

Lección 1 de 19 · Lectura y práctica
Introducción a RLHF y DPO: conceptos clave y diferencias
Concepto claveEl Fine-tuning de LLMs con técnicas de aprendizaje por refuerzo representa un salto cualitativo en la alineación de modelos de lenguaje con preferencias humanas. RLHF (Reinforcement Learning from Human Feedback) es.
Del concepto a la práctica
Taller de esta lección
La diferencia decisiva es dónde aparece la señal de preferencia. En el esquema RLHF con PPO estudiado aquí, las comparaciones entrenan un modelo de recompensa y esa señal guía a la política. RLHF es una familia de métodos y no implica obligatoriamente PPO en toda implementación. En DPO, el par elegido-rechazado entra directamente en una pérdida que favorece la respuesta elegida frente a una referencia.
Ejemplo resuelto
Para el prompt «Resume el incidente en una frase», la respuesta elegida obtiene log-probabilidad -4 y la rechazada -6. RLHF podría convertir la comparación en una etiqueta para el modelo de recompensa; DPO usa la diferencia 2 frente a las diferencias equivalentes de la referencia.
Pruébalo
Escribe qué componente produce la salida.
Marca quién aprende de la comparación.
Indica si existe un modelo de recompensa separado.
Anota qué método elegirías para un experimento pequeño y por qué.
Comprueba tu resultado
La política produce ambas respuestas; RLHF necesita política, recompensa y referencia durante el proceso; DPO optimiza pares sin entrenar una recompensa separada.
Error frecuente: llamar «recompensa» a toda preferencia. Corrección: una preferencia es el dato; la recompensa es una función aprendida o definida.
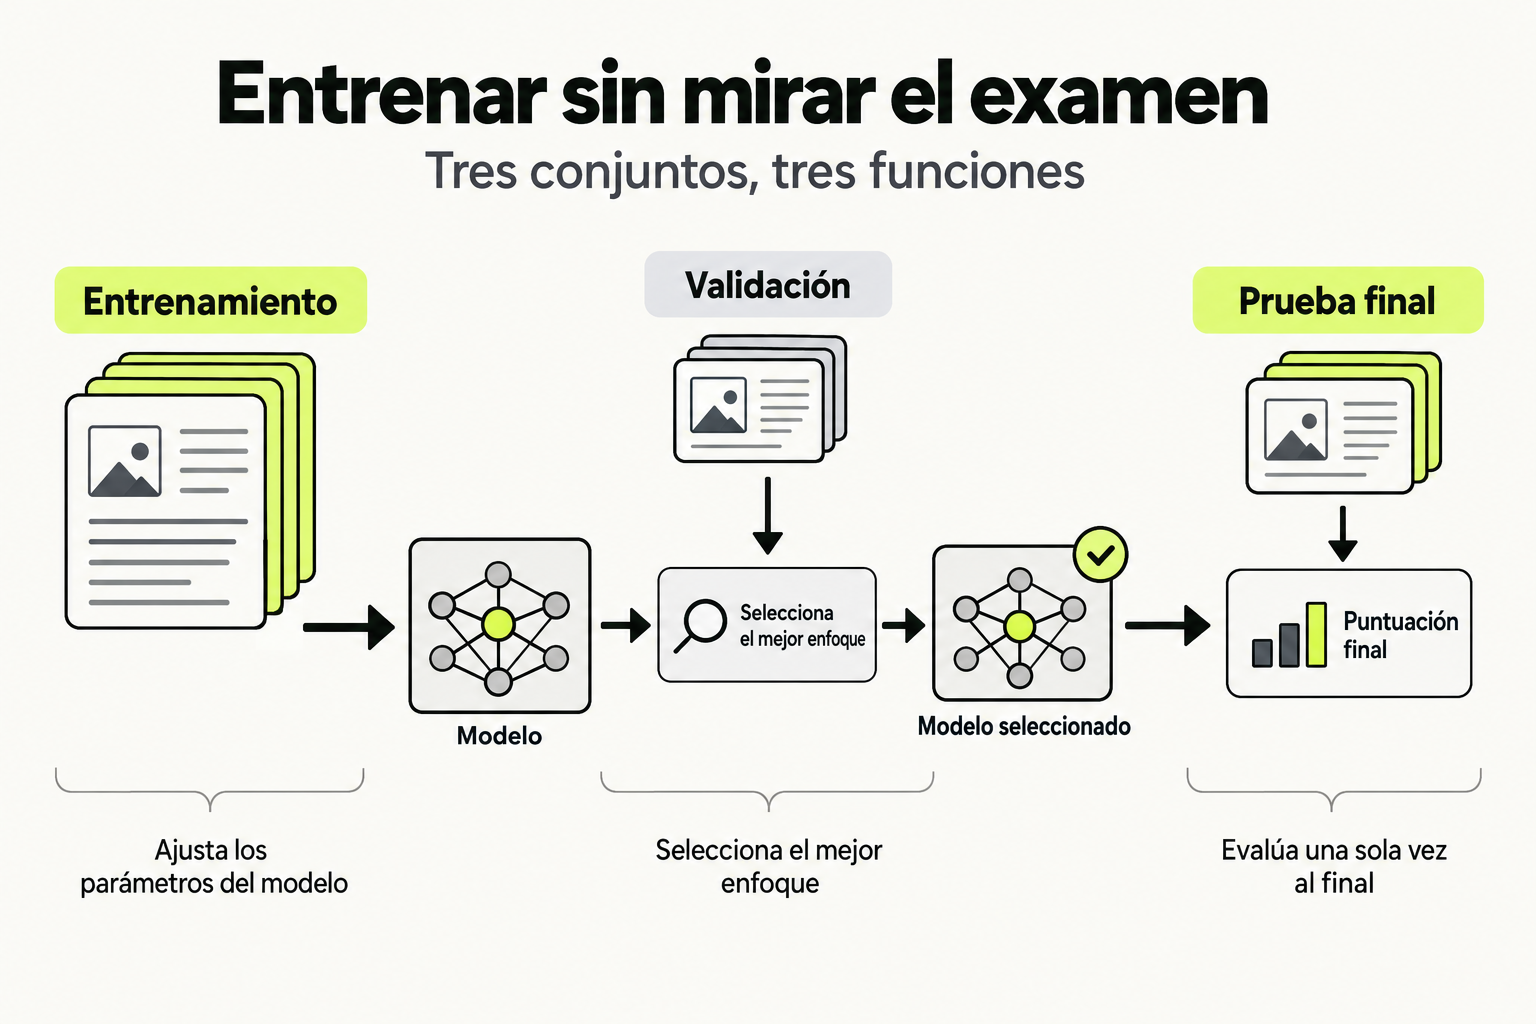
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Concepto clave
El Fine-tuning de LLMs con técnicas de aprendizaje por refuerzo representa un salto cualitativo en la alineación de modelos de lenguaje con preferencias humanas. RLHF (Reinforcement Learning from Human Feedback) es un proceso de tres etapas que comienza con un modelo base preentrenado, luego se ajusta con aprendizaje supervisado usando demostraciones humanas, y finalmente se optimiza mediante aprendizaje por refuerzo donde un modelo de recompensa, entrenado con comparaciones humanas, guía las actualizaciones de política.
DPO (Direct Preference Optimization) emerge como una alternativa más eficiente que reformula el problema de optimización de preferencias como un problema de clasificación directa, eliminando la necesidad de entrenar un modelo de recompensa separado. Mientras RLHF requiere múltiples modelos y fases de entrenamiento, DPO optimiza directamente el modelo de política usando una función de pérdida derivada de las preferencias humanas, reduciendo complejidad computacional y potencial de inestabilidad.
"RLHF es como entrenar a un chef con críticas detalladas de cada plato, mientras DPO es como darle acceso directo a las calificaciones de los comensales para que ajuste sus recetas."
Cómo funciona en la práctica
Imaginemos que queremos ajustar un modelo LLM open-source como Llama 3 para generar respuestas más útiles y seguras en un asistente virtual. Con RLHF, el proceso sería:
- Recopilar un dataset de preferencias humanas donde evaluadores comparan pares de respuestas del modelo base
- Entrenar un modelo de recompensa (Reward Model) que aprenda a puntuar respuestas según las preferencias humanas
- Usar PPO (Proximal Policy Optimization) para ajustar el modelo de política, maximizando la recompensa predicha mientras se mantiene cerca del modelo original para evitar deriva
Con DPO, el flujo se simplifica:
- Recopilar el mismo dataset de preferencias (respuestas preferidas vs no preferidas)
- Aplicar directamente la función de pérdida DPO al modelo, que optimiza la probabilidad de generar respuestas preferidas sobre las no preferidas
- El modelo se ajusta en un solo paso de entrenamiento, sin necesidad de modelos auxiliares
| Aspecto | RLHF | DPO |
|---|---|---|
| Complejidad de implementación | Alta (múltiples modelos) | Moderada (un solo modelo) |
| Estabilidad de entrenamiento | Requiere tuning cuidadoso | Generalmente más estable |
| Costo computacional | Alto | Moderado a bajo |
| Flexibilidad | Alta (reward model reusable) | Moderada (específico por tarea) |
Caso de estudio
Una startup de fintech necesita ajustar Mistral 7B para generar análisis de riesgo crediticio que sean tanto precisos como éticamente alineados. El equipo recopila 10,000 pares de respuestas donde expertos en riesgo marcan cuál análisis es más completo y cuál evita mejor sesgos discriminatorios.
Implementan ambas aproximaciones en paralelo:
- RLHF: Entrenan un reward model de 350M parámetros con los datos de preferencias, luego aplican PPO durante 3 días en 4 GPUs A100. El modelo resultante mejora la precisión en 15% pero muestra cierta inestabilidad en respuestas largas.
- DPO: Ajustan directamente Mistral 7B con la pérdida DPO durante 1.5 días en las mismas GPUs. Logran una mejora similar en precisión (14%) con mayor consistencia en respuestas extensas, y el modelo mantiene mejor sus capacidades generales de lenguaje.
La decisión final: implementan DPO en producción por su simplicidad operativa, reservando RLHF para experimentos futuros donde necesiten mayor control granular sobre diferentes dimensiones de calidad.
Errores comunes
1. Dataset de preferencias de baja calidad: Usar comparaciones inconsistentes o de evaluadores no calificados lleva a modelos mal alineados. Solución: Implementar protocolos de evaluación rigurosos y calcular agreement scores entre evaluadores.
2. Ignorar el problema de reward hacking: En RLHF, el modelo puede aprender a maximizar la recompensa predicha sin realmente mejorar la calidad. Solución: Incluir penalizaciones KL divergence y monitorear métricas de calidad independientes.
3. Sobreespecialización con DPO: Optimizar demasiado agresivamente para preferencias específicas puede degradar capacidades generales del modelo. Solución: Usar regularización y mezclar el dataset de preferencias con datos de instrucción general.
4. Subestimar requerimientos computacionales: Ambos métodos, especialmente RLHF, demandan recursos significativos. Solución: Empezar con fine-tuning parcial (LoRA) y escalar gradualmente.
5. Evaluación insuficiente: Confiar solo en métricas automáticas sin evaluación humana comprehensiva. Solución: Implementar pipeline de evaluación con métricas múltiples y revisión humana periódica.
Checklist de dominio
- Comprendo la diferencia fundamental entre el enfoque indirecto de RLHF y el directo de DPO
- Puedo explicar cuándo elegir RLHF vs DPO según requisitos del proyecto
- Sé preparar un dataset de preferencias con pares (chosen, rejected) de calidad
- Entiendo cómo la KL divergence previene deriva del modelo en RLHF
- Puedo implementar fine-tuning básico con DPO usando librerías como TRL
- Conozco las métricas clave para evaluar modelos ajustados (precisión, coherencia, seguridad)
- Sé diagnosticar problemas comunes como reward hacking o sobreajuste
Implementación básica de DPO con modelo open-source
En este ejercicio práctico, ajustarás un modelo LLM pequeño usando DPO para mejorar la calidad de respuestas en un dominio específico.
- Prepara el entorno: Instala las librerías necesarias:
pip install transformers datasets trl accelerate - Carga un modelo base: Usa un modelo pequeño como GPT-2 o TinyLlama para pruebas iniciales:
from transformers import AutoModelForCausalLM, AutoTokenizer model = AutoModelForCausalLM.from_pretrained("gpt2") tokenizer = AutoTokenizer.from_pretrained("gpt2") - Prepara datos sintéticos: Crea un dataset mínimo de preferencias para respuestas a preguntas técnicas:
preference_data = [ { "prompt": "Explica qué es backpropagation", "chosen": "Backpropagation es el algoritmo fundamental para entrenar redes neuronales...", "rejected": "Backpropagation es algo de redes, no sé mucho más." } ] # Añade al menos 10 ejemplos variados - Configura el entrenamiento DPO: Usa el trainer de TRL con parámetros conservadores:
from trl import DPOTrainer trainer = DPOTrainer( model=model, args=training_args, train_dataset=dataset, tokenizer=tokenizer, beta=0.1 # Parámetro de regularización ) - Ejecuta fine-tuning: Entrena por 3 épocas y guarda el modelo ajustado
- Evalúa resultados: Compara respuestas del modelo base vs ajustado en prompts no vistos
Pistas
- Comienza con un modelo muy pequeño para iterar rápido antes de escalar
- Asegúrate de que tu tokenizer tenga un padding token configurado
- El parámetro beta controla trade-off entre preferencias y divergencia del modelo original
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Práctica acompañada: Automatiza una tarea verificable
Python, archivos CSV y pruebas pequeñas. Usa este cuaderno como práctica complementaria de la ruta; el material original de la lección continúa siendo tu referencia.
Práctica: añade una salida reutilizable
Amplía el programa para escribir un nuevo archivo resumen.csv con encabezados categoria,total_centavos. No cambies resumir: añade una función que reciba su resultado y escriba la salida. Ejecuta dos veces y comprueba que no acumula filas duplicadas.
Después agrega una categoría con acento y una cantidad de dos dígitos. Comprueba que la codificación y la conversión siguen funcionando. Para automatizaciones de carpetas, aplica primero este patrón en una carpeta de prueba. Genera un informe de qué se cambiaría antes de habilitar operaciones de escritura sobre archivos importantes.
Comprueba tu entrega
Entrega el programa, la prueba, un ejemplo de entrada y un README con el comando exacto. Indica qué hace ante un archivo inexistente, una columna ausente o un valor inválido. La confiabilidad viene de conocer esos límites, no de añadir muchas funciones.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.