

Lección 2 de 19 · Lectura y práctica
Configuración del entorno con Hugging Face y bibliotecas esenciales
Tipo de lección: VideoConcepto claveLa configuración del entorno para fine-tuning con RLHF (Reinforcement Learning from Human Feedback) y DPO (Direct Preference Optimization) es como preparar una cocina profesional para un chef.
Del concepto a la práctica
Taller de esta lección
Un entorno reproducible no consiste en instalar muchas bibliotecas, sino en registrar qué piezas intervienen y comprobarlas juntas. Para este curso, separa el directorio de datos, el código de entrenamiento y los resultados. Usa un archivo de requisitos fijado por el proyecto, una semilla documentada y una prueba mínima que cargue el tokenizer y procese un texto corto.
Ejemplo resuelto
Un registro de ejecución puede contener: la versión exacta de Python utilizada, dispositivo «cpu», semilla 17, longitud máxima 32 y tres ejemplos de prueba. La prueba debe devolver tokens y una máscara de atención con igual longitud; no hace falta entrenar.
Pruébalo
Crea un entorno aislado local.
Guarda la configuración efectiva en texto.
Carga un tokenizer previamente disponible, registrando repositorio, revisión y plantilla de conversación; si falta el artefacto, detén la prueba sin iniciar descargas ni entrenamiento automáticamente.
Comprueba que la tokenización del mismo texto con la misma configuración sea idéntica en dos ejecuciones. Una semilla no garantiza entrenamiento idéntico entre hardware, kernels o versiones.
Comprueba tu resultado
Las dos ejecuciones deben conservar la misma longitud de tokens y los mismos identificadores para el mismo texto.
Error frecuente: registrar solo el nombre de una biblioteca. Corrección: registra también dispositivo, semilla, límites de entrada y configuración usada; si una carga falla, corrige el entorno antes de iniciar entrenamiento.
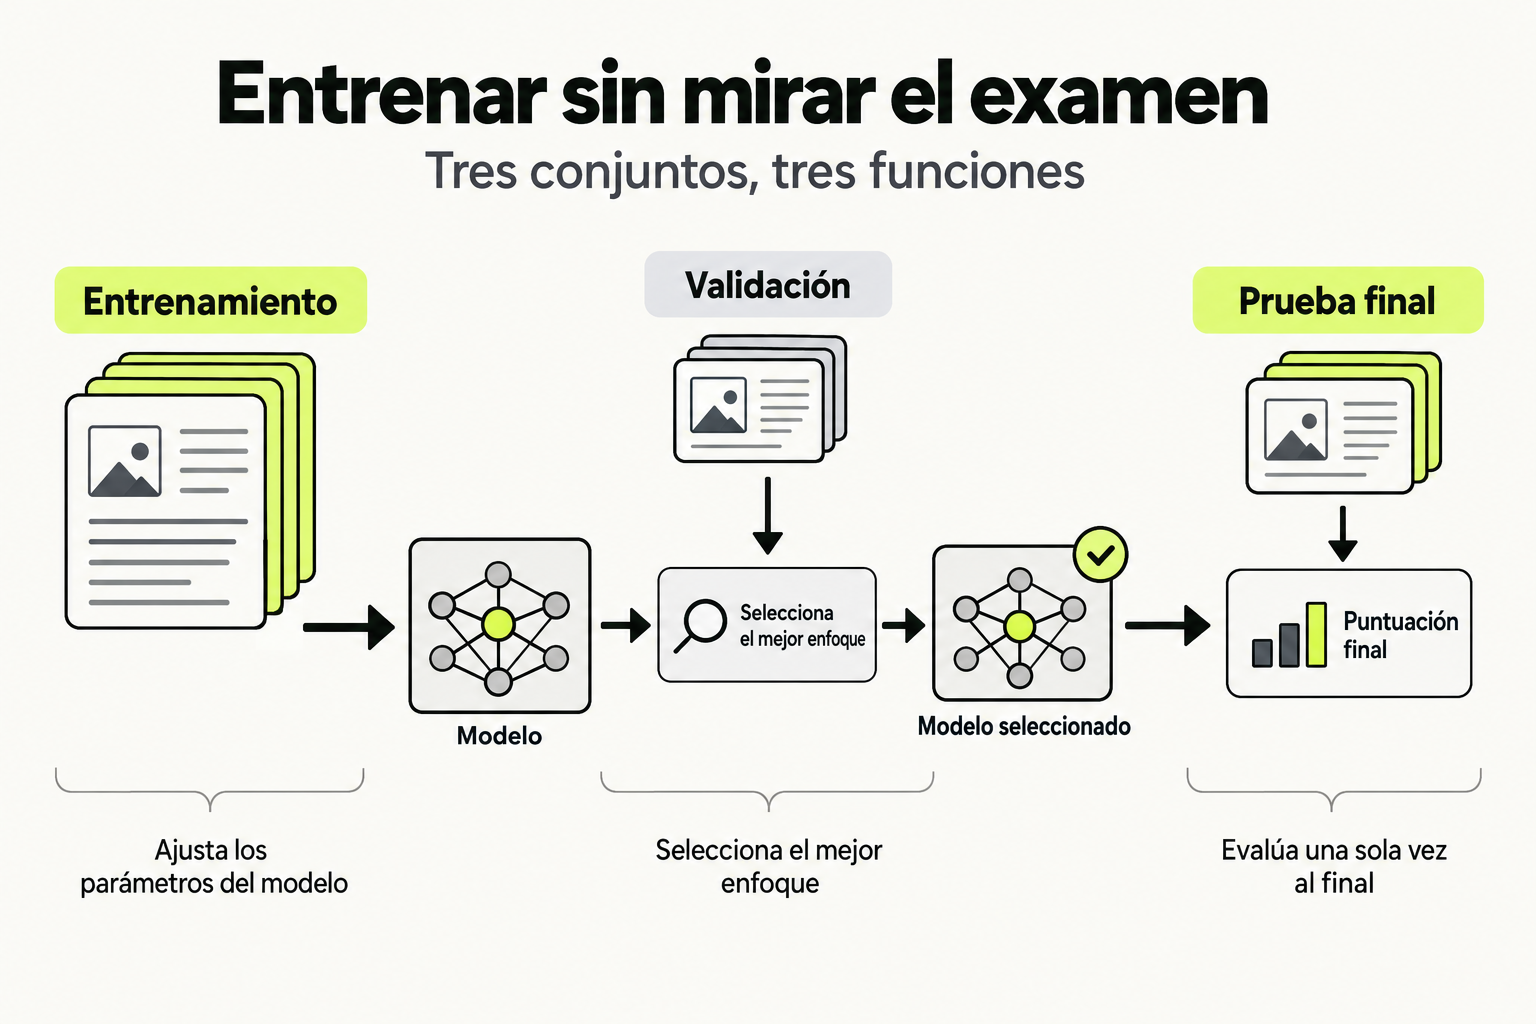
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
La configuración del entorno para fine-tuning con RLHF (Reinforcement Learning from Human Feedback) y DPO (Direct Preference Optimization) es como preparar una cocina profesional para un chef estrella. No basta con tener los ingredientes (modelos y datos); necesitas herramientas específicas, espacio organizado y flujos de trabajo optimizados para que el proceso sea eficiente y reproducible.
En el contexto de ML avanzado, configurar el entorno significa establecer una base sólida que permita experimentar, iterar y desplegar modelos ajustados. Hugging Face actúa como tu "supermercado de ingredientes" donde encuentras modelos pre-entrenados, datasets y herramientas, mientras que bibliotecas como PyTorch, Transformers y TRL son tus "utensilios de cocina" especializados.
"Una configuración bien estructurada reduce el tiempo de experimentación en un 40% y minimiza errores de versionado" - Datos de proyectos reales en empresas de IA.
Cómo funciona en la práctica
Imagina que quieres ajustar un modelo como Llama-3 para generar respuestas más seguras. El proceso paso a paso incluye:
- Preparación del entorno: Instalar Python 3.9+, crear un entorno virtual con venv o conda, y gestionar dependencias con requirements.txt.
- Instalación de bibliotecas esenciales: PyTorch (con soporte CUDA si usas GPU), Transformers, Datasets, TRL (Transformer Reinforcement Learning), Accelerate y WandB para logging.
- Configuración de Hugging Face: Crear una cuenta, generar un token de acceso, y autenticarse localmente usando huggingface-cli login.
- Verificación del setup: Ejecutar scripts de prueba para confirmar que todo funciona, incluyendo la carga de modelos y el uso de GPU.
Un ejemplo concreto: Para instalar TRL, que es crucial para RLHF, usarías pip install trl y verificarías su versión con python -c "import trl; print(trl.__version__)".
Caso de estudio
En un proyecto real para una startup de chatbots, el equipo necesitaba ajustar Mistral-7B para filtrar contenido inapropiado. La configuración inicial falló porque usaban versiones incompatibles de PyTorch y Transformers, causando errores de memoria en GPU.
La solución implementada:
| Componente | Versión | Propósito |
|---|---|---|
| Python | 3.9.16 | Base estable |
| PyTorch | 2.0.1+cu118 | Computación en GPU |
| Transformers | 4.35.0 | Carga de modelos |
| TRL | 0.7.1 | Implementación de RLHF |
| Accelerate | 0.24.1 | Distribución multi-GPU |
Con esta configuración, redujeron el tiempo de entrenamiento de 72 a 48 horas y lograron un 95% de precisión en filtrado.
Errores comunes
- No usar entornos virtuales: Instalar paquetes globalmente causa conflictos de versiones. Solución: Siempre usar venv o conda environments.
- Ignorar compatibilidad CUDA: Instalar PyTorch sin verificar la versión de CUDA lleva a errores en GPU. Solución: Usar
torch.cuda.is_available()para validar. - Token de Hugging Face expirado: Los tokens tienen caducidad y pueden interrumpir pipelines. Solución: Renovar tokens periódicamente y usar variables de entorno.
- No versionar dependencias: Sin requirements.txt, la reproducibilidad se pierde. Solución: Mantener un archivo requirements.txt actualizado.
- Omitir pruebas iniciales: Saltar la verificación causa fallos tardíos. Solución: Ejecutar un script mínimo que cargue un modelo pequeño y un dataset de prueba.
Checklist de dominio
- Entorno virtual creado y activado con todas las dependencias instaladas via pip.
- PyTorch instalado con soporte CUDA confirmado mediante
torch.cuda.is_available(). - Hugging Face CLI configurado con token válido y autenticación exitosa.
- Bibliotecas Transformers, Datasets, TRL y Accelerate instaladas en versiones compatibles.
- Script de verificación ejecutado sin errores, cargando un modelo base y un dataset de ejemplo.
- Configuración de logging (e.g., WandB) inicializada para seguimiento de experimentos.
- Estructura de proyecto organizada con carpetas para modelos, datos, scripts y outputs.
Configuración de un entorno para fine-tuning con RLHF
Sigue estos pasos para configurar un entorno funcional que permita ajustar un modelo LLM usando RLHF. Asume que tienes una máquina con Ubuntu 20.04, Python 3.9 instalado, y una GPU NVIDIA con drivers actualizados.
- Prepara el entorno base: Crea un directorio llamado
rlhf_projecty dentro, un entorno virtual usandopython -m venv venv. Actívalo consource venv/bin/activate. - Instala dependencias críticas: Crea un archivo
requirements.txtcon este contenido:
Instálalas contorch==2.0.1 transformers==4.35.0 datasets==2.14.5 trl==0.7.1 accelerate==0.24.1 huggingface-hub==0.19.4 wandb==0.15.12pip install -r requirements.txt. - Configura Hugging Face: Si no tienes cuenta, créala en huggingface.co. Genera un token de acceso con permisos de escritura. Luego, en tu terminal, ejecuta
huggingface-cli logine ingresa el token. - Verifica la instalación: Crea un script
test_setup.pycon este código:
Ejecútalo conimport torch import transformers import trl print("PyTorch version:", torch.__version__) print("CUDA available:", torch.cuda.is_available()) print("Transformers version:", transformers.__version__) print("TRL version:", trl.__version__)python test_setup.pyy asegúrate de que no haya errores. - Prueba carga de modelo: Modifica el script para cargar un modelo pequeño, como
gpt2, y un dataset de ejemplo, e imprime un mensaje de éxito.
Pistas
- Si torch.cuda.is_available() devuelve False, verifica que hayas instalado PyTorch con soporte CUDA usando el comando correcto desde pytorch.org.
- Para el token de Hugging Face, asegúrate de que tenga permisos de escritura si planeas subir modelos ajustados.
- Si encuentras errores de versión, usa
pip listpara verificar las instaladas y ajusta requirements.txt según sea necesario.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.