

Lección 12 de 15 · Lectura y práctica
Logging y Monitoreo de Contenedores
Concepto claveEl logging y monitoreo de contenedores es fundamental para mantener aplicaciones en producción. Imagina que tus contenedores son como cajas negras: necesitas saber qué sucede dentro sin abrirlas. Los logs son los.
Del concepto a la práctica
Taller de esta lección
La observabilidad empieza por emitir eventos útiles en stdout y stderr, con suficiente contexto para filtrar sin leer cada línea manualmente. Las métricas de recursos responden otra pregunta: cuánto consume el proceso, no qué ocurrió funcionalmente.
Ejemplo resuelto
Una aplicación puede emitir líneas consistentes:
level=info event=request request_id=r17 status=200 duration_ms=24
level=error event=cache_timeout request_id=r18 status=503 duration_ms=1200
La primera línea describe éxito y duración; la segunda permite filtrar un fallo y relacionarlo con r18.
Pruébalo
Genera una petición correcta y otra que provoque error local.
Consulta los logs del contenedor.
Filtra por
level=erroro por el identificador de petición.Consulta el consumo de CPU y memoria en una medición separada.
Error frecuente: mezclar mensajes multilínea sin campos estables. Corrígelo usando claves repetibles y enviando cada evento a una línea.
Comprueba tu resultado
Entrega dos eventos con request_id distintos y una medición de recursos con hora de captura. Debe ser posible localizar el error sin incluir la petición correcta y distinguir el dato funcional de la métrica de consumo.
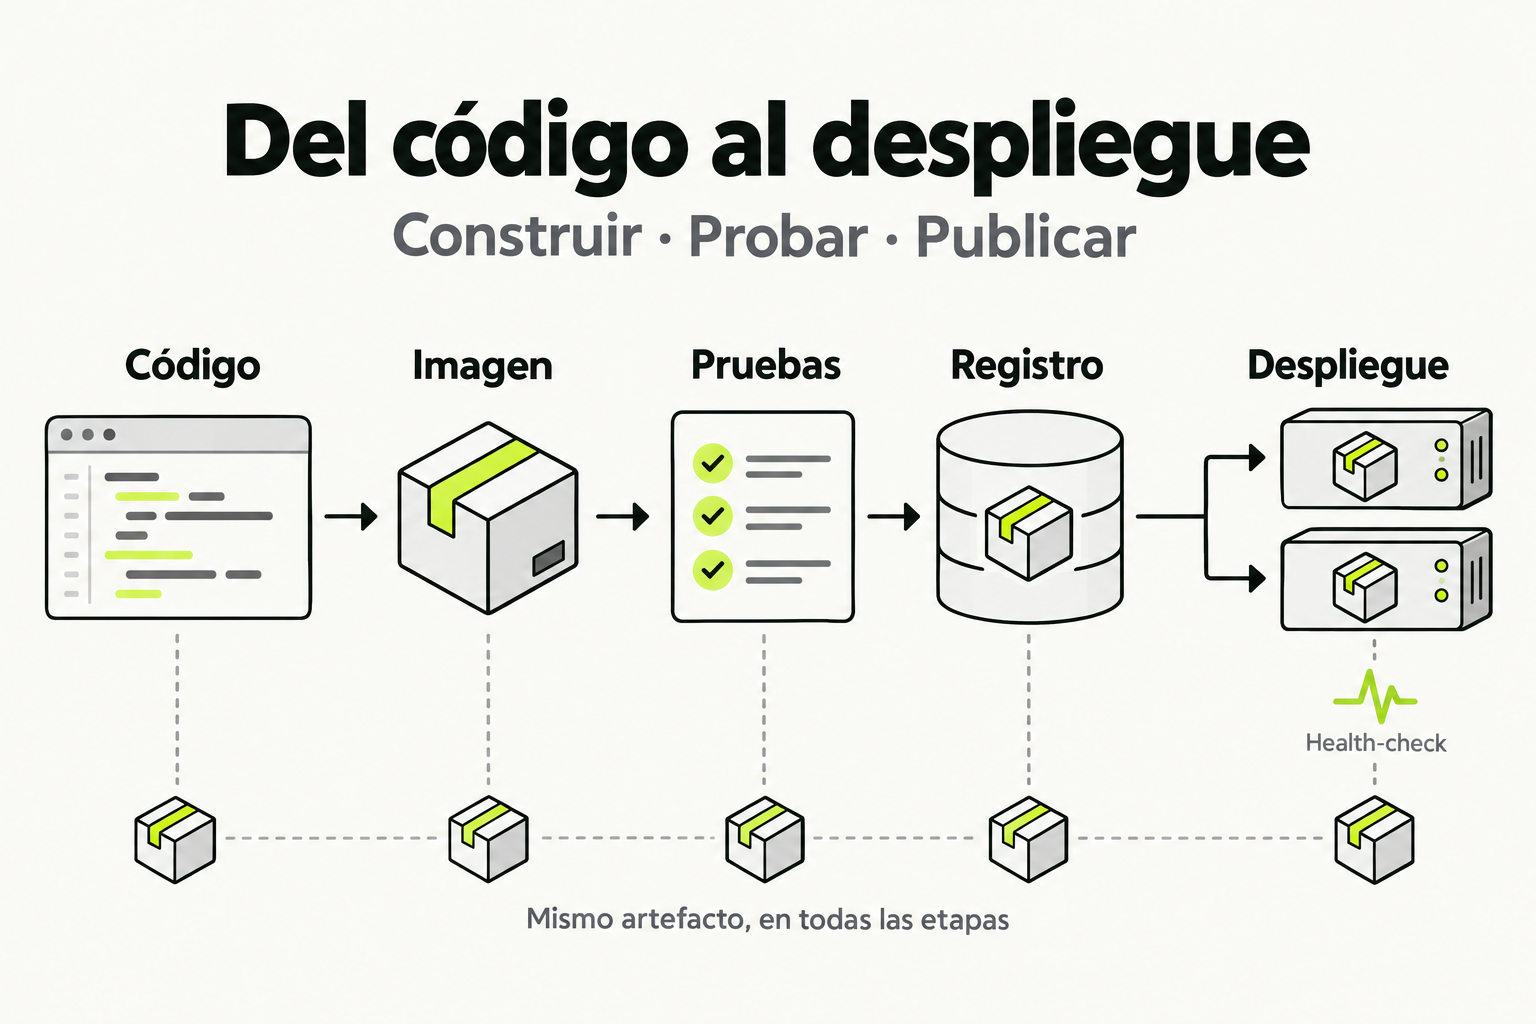
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Concepto clave
El logging y monitoreo de contenedores es fundamental para mantener aplicaciones en producción. Imagina que tus contenedores son como cajas negras: necesitas saber qué sucede dentro sin abrirlas. Los logs son los mensajes que cada contenedor escribe (como un diario de a bordo), y el monitoreo te permite medir métricas como CPU, memoria y red. Sin estas herramientas, estás volando a ciegas: no sabes si un contenedor falló, por qué, o si está a punto de colapsar por falta de recursos.
En Docker, por defecto, los logs se manejan con el controlador json-file, que guarda la salida estándar (stdout) y de error (stderr) en archivos JSON. Sin embargo, en producción necesitas centralizar logs y métricas para poder analizarlos históricamente y alertar en tiempo real. Herramientas como Prometheus (para métricas) y ELK Stack (Elasticsearch, Logstash, Kibana) o Loki + Grafana son los estándares de la industria.
La analogía del mundo real: Piensa en un edificio inteligente. Los logs son los reportes de cada sensor (temperatura, humedad), y el monitoreo es el panel de control que te muestra todo en tiempo real. Sin ellos, no sabrías si un piso está en llamas hasta que sea demasiado tarde.
Cómo funciona en la práctica
Para implementar logging y monitoreo en producción, seguiremos estos pasos:
- Configurar el controlador de logs de Docker para que envíe logs a un sistema centralizado (por ejemplo, usando
syslogogelf). - Exponer métricas desde la aplicación (por ejemplo, con una librería como
prometheus_clienten Python) y configurar Docker para que Prometheus pueda recolectarlas. - Usar docker-compose para levantar una pila de monitoreo con Prometheus, Grafana y un recolector de logs (como Loki o Filebeat).
Ejemplo paso a paso: Supongamos que tienes una aplicación web en un contenedor. Primero, modificamos el docker-compose.yml para agregar un servicio de Loki y Grafana. Luego, instalamos el driver de logs loki (o usamos json-file con un recolector). Finalmente, configuramos Grafana para visualizar tanto logs como métricas.
Código en acción
A continuación, un ejemplo funcional de docker-compose.yml que levanta una aplicación Python, Prometheus, Grafana y Loki:
version: '3.8'

services:
  app:
    build: .
    ports:
      - "5000:5000"
    logging:
      driver: loki
      options:
        loki-url: "http://loki:3100/loki/api/v1/push"
        loki-external-labels: "job=app"

  prometheus:
    image: prom/prometheus
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml
    ports:
      - "9090:9090"

  grafana:
    image: grafana/grafana
    ports:
      - "3000:3000"
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=admin

  loki:
    image: grafana/loki
    ports:
      - "3100:3100"
Además, necesitas un archivo prometheus.yml para configurar el scraping de métricas desde la aplicación:
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: 'app'
    static_configs:
      - targets: ['app:5000']
Para que la aplicación exponga métricas, agrega el siguiente código Python (suponiendo Flask):
from flask import Flask
from prometheus_flask_exporter import PrometheusMetrics

app = Flask(__name__)
metrics = PrometheusMetrics(app)

@app.route('/')
def hello():
    return "Hello, World!"

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
Con esto, al ejecutar docker-compose up, tendrás logs en Loki y métricas en Prometheus, visibles en Grafana.
Errores comunes
- No configurar el driver de logs correctamente: Usar el driver por defecto
json-fileen producción sin rotación puede llenar el disco. Solución: Configurarmax-sizeymax-fileen el daemon de Docker o usar un driver externo. - No exponer métricas desde la aplicación: Muchos asumen que Docker expone métricas automáticamente, pero solo expone las del contenedor (CPU, memoria). Las métricas de negocio (peticiones, latencia) deben ser expuestas por la app.
- Olvidar etiquetar logs y métricas: Sin etiquetas (labels) como
service,version,environment, es imposible filtrar. Solución: Usarloki-external-labelso etiquetas en Prometheus. - No probar la integración localmente: Configurar todo en producción sin verificar que los logs lleguen a Loki o que Grafana pueda consultar Prometheus. Solución: Probar con
docker-composeen local. - Ignorar la rotación de logs: Incluso con drivers externos, si la app genera muchos logs, el buffer puede saturarse. Solución: Configurar límites de tamaño y políticas de retención en Loki o Elasticsearch.
Checklist de dominio
- [ ] Configuré el driver de logs de Docker para enviar logs a un sistema centralizado (Loki, ELK, etc.).
- [ ] Mi aplicación expone métricas en un endpoint
/metrics(por ejemplo, con Prometheus client). - [ ] Agregué un servicio de Prometheus y Grafana en mi stack de docker-compose.
- [ ] Configuré Grafana para conectar a Prometheus y Loki como fuentes de datos.
- [ ] Creé un dashboard en Grafana que muestra al menos 3 métricas (CPU, memoria, peticiones por segundo) y los logs filtrados por servicio.
- [ ] Verifiqué que los logs contengan etiquetas útiles (servicio, entorno) y que las métricas tengan labels consistentes.
- [ ] Probé la rotación de logs y que no se llena el disco local.
Configurar una pila de monitoreo para una aplicación contenedorizada
En este ejercicio, configurarás una pila completa de logging y monitoreo para una aplicación web simple. Deberás entregar un archivo docker-compose.yml funcional que incluya la aplicación, Prometheus, Grafana y Loki. Además, deberás crear un dashboard en Grafana que muestre al menos 3 métricas (CPU, memoria, peticiones por segundo) y los logs de la aplicación.
Pasos:
- Crea un directorio de trabajo:
mkdir monitoreo-ejercicio && cd monitoreo-ejercicio - Dentro, crea una aplicación Python simple (por ejemplo, Flask) que exponga un endpoint
/metricscon métricas de Prometheus. Usa la libreríaprometheus_flask_exporter. - Crea un
Dockerfilepara la aplicación. - Crea un archivo
docker-compose.ymlcon los servicios: app, prometheus, grafana, loki. Configura el driver de logs de la app para que envíe logs a Loki. - Crea un archivo
prometheus.ymlpara configurar el scraping de métricas desde la app. - Ejecuta
docker-compose upy verifica que todo funcione. - Accede a Grafana en
http://localhost:3000(usuario: admin, contraseña: admin). Agrega Prometheus y Loki como fuentes de datos. - Crea un dashboard con al menos 3 paneles: uno para CPU del contenedor, uno para memoria, y uno para peticiones por segundo (puedes usar métricas de Prometheus como
container_cpu_usage_seconds_totalyflask_http_request_total). - Agrega un panel de logs que muestre los logs de la aplicación (usando la fuente de Loki).
- Exporta el dashboard como JSON (opcional) y toma una captura de pantalla.
Entregable:
Sube a la plataforma un archivo ZIP que contenga:
docker-compose.ymlDockerfileapp.py(código de la aplicación)prometheus.ymlrequirements.txt(si aplica)- Captura de pantalla del dashboard de Grafana mostrando los paneles.
Rúbrica de evaluación:
- (20%) La aplicación expone métricas correctamente en
/metrics. - (20%) El archivo docker-compose.yml está bien estructurado y todos los servicios se levantan sin errores.
- (20%) Los logs de la aplicación llegan a Loki y se pueden consultar desde Grafana.
- (20%) El dashboard muestra al menos 3 métricas relevantes y los logs.
- (20%) La solución es reproducible: se puede ejecutar
docker-compose upy todo funciona.
Pistas
- Para exponer métricas de Flask, usa la librería prometheus_flask_exporter. Instálala con pip y agrega la línea 'metrics = PrometheusMetrics(app)' después de crear la app.
- En el docker-compose, para el driver de logs de Loki, asegúrate de que el servicio de Loki se llame exactamente 'loki' y que el puerto 3100 esté expuesto. La URL del driver debe ser 'http://loki:3100/loki/api/v1/push'.
- Para que Prometheus pueda scrapear la app, el target debe ser 'app:5000' (o el puerto que uses). Verifica que la app esté en la misma red de docker-compose.
Sigue con Docker para Desarrolladores
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.