

Lección 11 de 15 · Lectura y práctica
Health Checks y Reinicio Automático
CONCEPTO CLAVE: Los health checks permiten a Docker monitorear el estado de salud de un container y tomar acciones automáticas cuando algo falla. Combinados con políticas de reinicio, garantizan alta disponibilidad y resiliencia.
Del concepto a la práctica
Taller de esta lección
Un health check debe probar una capacidad útil, mientras que una política de reinicio decide qué hacer después de que el proceso termine. Un contenedor puede estar ejecutándose y seguir atendiendo mal; por eso ambas señales no son equivalentes.
Ejemplo resuelto
FROM nginx:alpine
HEALTHCHECK --interval=10s --timeout=3s --retries=3 CMD wget -q -O - http://localhost/estado.txt || exit 1
La comprobación exige una respuesta HTTP local. Si falla tres veces, el estado cambia a unhealthy; la política de reinicio se define aparte. Docker Engine no reinicia automáticamente por unhealthy: las políticas restart reaccionan a la salida del proceso, no al estado de salud por sí solo.
Pruébalo
Construye la imagen y arráncala.
Espera a que aparezca el estado
healthy.En la imagen local de práctica crea primero estado.txt con ok. Después retira únicamente ese archivo temporal: nginx devolverá 404 y wget fallará, sin detener el proceso principal. Cambiar el contenido a otro texto con HTTP200 no provocaría fallo en este health check.
Observa el estado sin confundirlo con el código de salida del proceso.
Error frecuente: comprobar solo ps o el proceso principal. Corrígelo verificando la ruta o dependencia que realmente necesita el usuario.
Comprueba tu resultado
Registra una transición starting a healthy y, después, una transición a unhealthy provocada localmente. El resultado esperado incluye los códigos de salida de la comprobación y demuestra que un proceso activo no garantiza salud.
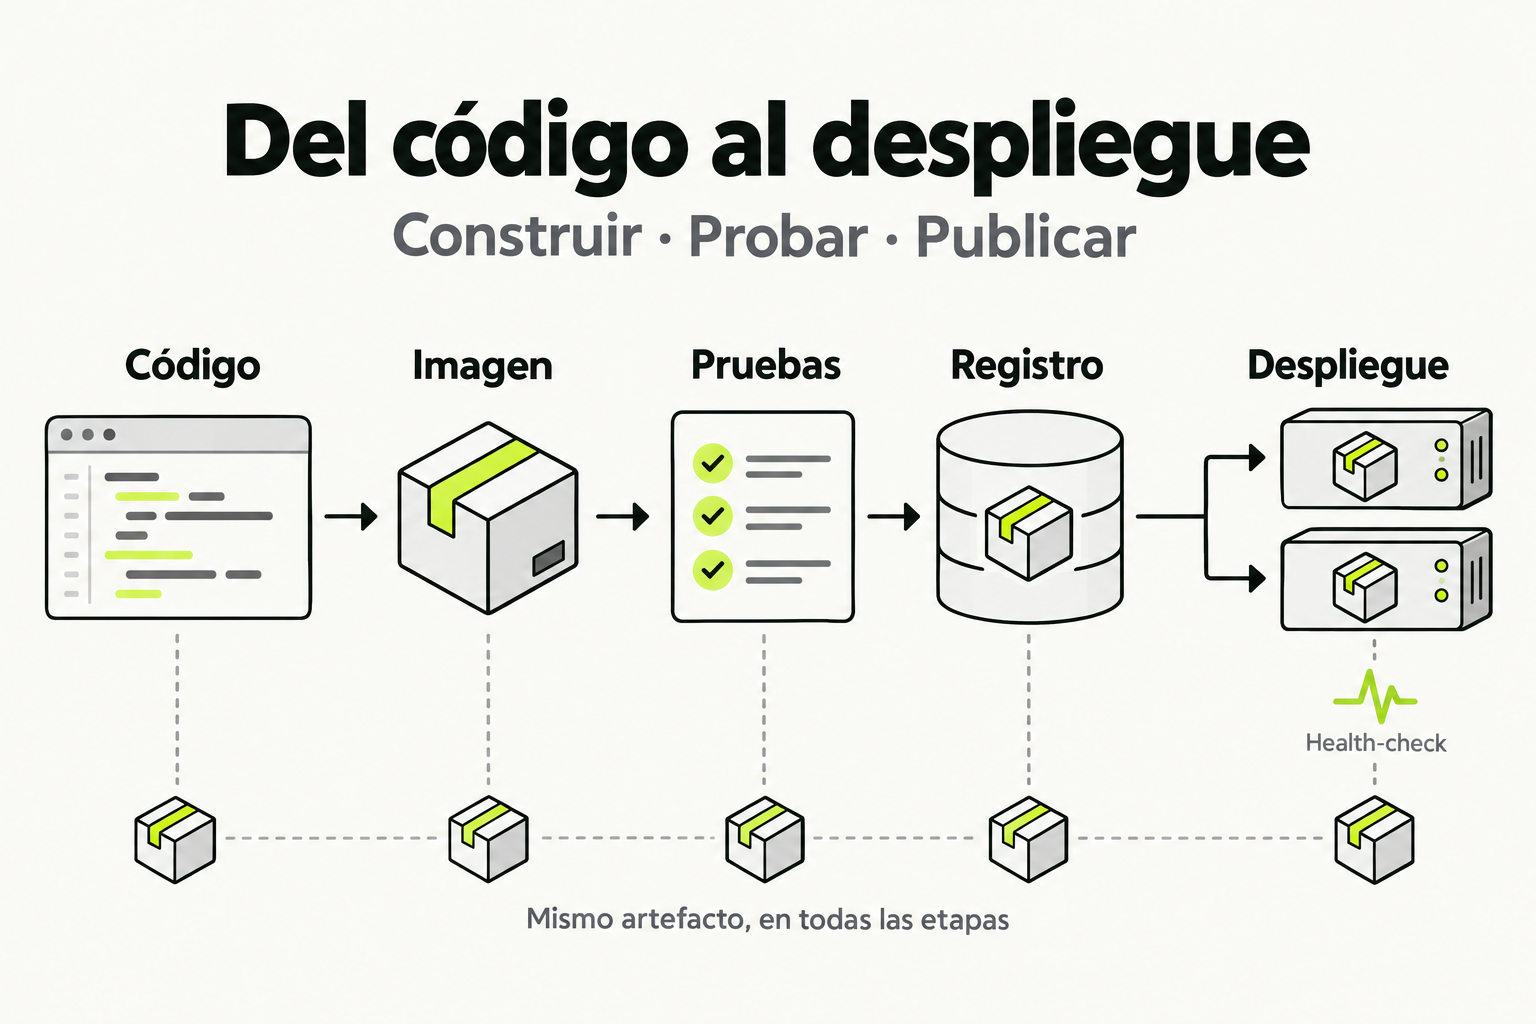
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗¿Por qué necesitas Health Checks?
En un entorno de producción, los containers pueden fallar por múltiples razones: errores en la aplicación, agotamiento de memoria, conexiones perdidas a bases de datos, o simplemente procesos zombies. Sin mecanismos de supervisión, un container caído permanece caído hasta que alguien lo descubre manualmente.
Los health checks resuelven este problema permitiendo que Docker interrogue periódicamente al container sobre su estado real de salud. Si el container no responde correctamente, Docker puede reiniciarlo automáticamente según la política configurada.
Configurando Health Checks
Docker proporciona la instrucción HEALTHCHECK en el Dockerfile para definir cómo verificar que un container está saludable. Esta instrucción acepta varios parámetros:
HEALTHCHECK [--interval=30s] [--timeout=10s] [--retries=3] [--start-period=40s] CMD comandoParámetros del HEALTHCHECK
| Parámetro | Descripción | Valor por defecto |
|---|---|---|
--interval |
Tiempo entre verificaciones de salud | 30 segundos |
--timeout |
Tiempo máximo para considerar la verificación exitosa | 30 segundos |
--retries |
Intentos fallidos consecutivos antes de marcar como unhealthy | 3 |
--start-period |
Tiempo de gracia inicial durante el cual los fallos no cuentan | 0 segundos |
Ejemplo práctico: API REST con Node.js
FROM node:18-alpine

WORKDIR /app

COPY package*.json ./
RUN npm ci --only=production

COPY . .

EXPOSE 3000

# Health check: verifica que el endpoint /health responde correctamente
HEALTHCHECK --interval=30s --timeout=10s --start-period=30s --retries=3 \
  CMD node -e "
    const http = require('http');
    http.get('http://localhost:3000/health', (res) => {
      process.exit(res.statusCode === 200 ? 0 : 1);
    }).on('error', () => process.exit(1));
  "

CMD ["node", "server.js"]
Ejemplo: Base de datos PostgreSQL
FROM postgres:15-alpine

ENV POSTGRES_DB=mydb
ENV POSTGRES_USER=myuser
ENV POSTGRES_PASSWORD=mypassword

# Verificar que PostgreSQL responde a conexiones
HEALTHCHECK --interval=10s --timeout=5s --retries=5 \
  CMD pg_isready -U myuser -d mydb || exit 1

EXPOSE 5432Políticas de Reinicio Automático
Docker ofrece múltiples políticas de reinicio que determinan qué sucede cuando un container se detiene. Estas políticas se configuran con la bandera --restart al crear el container.
Políticas disponibles
| Política | Comportamiento | Casos de uso |
|---|---|---|
no |
No reinicia automáticamente (comportamiento por defecto) | Containers de desarrollo, tareas únicas |
on-failure[:max-retries] |
Reinicia solo si el container sale con código de error | Procesos que pueden fallar recoverablemente |
unless-stopped |
Reinicia siempre excepto si se detuvo manualmente | Servicios en producción (recomendado) |
always |
Reinicia siempre, incluso si se detuvo manualmente | Servicios críticos, demonios |
Ejemplos de uso
# Reiniciar siempre (para demonios y servicios críticos)
docker run -d --name mi-nginx --restart always -p 80:80 nginx

# Reiniciar solo en caso de fallo, máximo 5 intentos
docker run -d --name mi-app --restart on-failure:5 mi-imagen

# Reiniciar siempre excepto si se detuvo manualmente (PRODUCCIÓN)
docker run -d --name mi-api --restart unless-stopped -p 8080:8080 mi-api:latestunless-stopped en lugar de always. La diferencia es sutil pero importante: si detienes manualmente un container con always, se reiniciará al reiniciar Docker. Con unless-stopped, respetará tu decisión de mantenerlo detenido.Combinando Health Checks y Reinicio Automático
La verdadera potencia surge cuando combinas ambas características. Cuando un health check falla consecutivamente el número de retries configurado, Docker marca el container como unhealthy. Con la política de reinicio apropiada, Docker puede automáticamente reiniciar el container para intentar recuperarlo.
Ejemplo completo: Aplicación web con base de datos
version: '3.8'

services:
  api:
    build: ./api
    restart: unless-stopped
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:3000/health"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s
    depends_on:
      db:
        condition: service_healthy
    ports:
      - "3000:3000"

  db:
    image: postgres:15-alpine
    restart: unless-stopped
    environment:
      POSTGRES_DB: appdb
      POSTGRES_USER: appuser
      POSTGRES_PASSWORD: secretpassword
    volumes:
      - pgdata:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U appuser -d appdb"]
      interval: 10s
      timeout: 5s
      retries: 5

volumes:
  pgdata:
Verificando el estado de salud
# Ver estado de todos los containers incluyendo health
docker ps --format "table {{.Names}}\t{{.Status}}\t{{.Health}}"

# Ver detalles del health check de un container específico
docker inspect --format='{{json .State.Health}}' mi-container | jq

# Ver historial de health checks
docker inspect --format='{{range .State.Health.Log}} {{.End}} - Exit: {{.ExitCode}} - Output: {{.Output}} {{end}}' mi-container
Códigos de estado del Health
Un container puede tener uno de estos estados de salud:
| Estado | Descripción |
|---|---|
starting |
El container está en su período de gracia inicial (start-period) |
healthy |
Todos los health checks han pasado exitosamente |
unhealthy |
El número de fallos consecutivos alcanzó el límite de retries |
Casos de uso avanzados
Health check para aplicaciones con autenticación
# Verificar salud sin exponer endpoints de métricas públicos
HEALTHCHECK --interval=30s --timeout=5s --retries=3 \
  CMD wget --no-verbose --tries=1 --spider http://localhost:8080/api/health \
    -O /dev/null || exit 1
Health check con verificación de dependencias
Ver más: Verificación de servicios dependientes
#!/bin/sh
set -e

# Verificar que el servicio responde
curl -f http://localhost:8080/health || exit 1

# Verificar conexión a base de datos
nc -z db 5432 || exit 1

echo "All dependencies healthy"
exit 0
Este script verifica tanto la aplicación como sus dependencias externas antes de reportar salud.
Reinicio con límite de intentos
# Detener después de 10 intentos fallidos para evitar loops infinitos
docker run -d \
  --name servicio-critico \
  --restart on-failure:10 \
  --health-cmd="pg_isready -U postgres" \
  --health-interval=30s \
  --health-retries=3 \
mi-base-datoson-failure, Docker intentará reiniciar indefinidamente. En casos de bugs críticos que causan crashes constantes, esto puede generar un loop de reinicios que satura los recursos del sistema. Establece un límite máximo de intentos.Debugging de problemas
- Verifica los logs del container:
docker logs mi-containerpara identificar qué está causando los fallos. - Revisa el output del health check:
docker inspect --format='{{.State.Health}}' mi-container - Ejecuta el comando manualmente: Entra al container y ejecuta el comando del health check para ver el error directamente.
- Verifica recursos: Asegúrate de que el container tiene suficiente CPU y memoria asignados.
- Revisa dependencias: Verifica que los servicios externos (bases de datos, APIs) están accesibles.
# Entrar al container y verificar manualmente
docker exec -it mi-container sh

# Dentro del container, ejecutar el health check
curl -f http://localhost:3000/health

# O verificar pg_isready si es PostgreSQL
pg_isready -U postgres
Integración con orquestación
En entornos con Docker Swarm o Kubernetes, los health checks se integran con los mecanismos de orquestación:
# En Docker Swarm, crear servicio con health check
docker service create \
  --name mi-servicio \
  --health-cmd="curl -f http://localhost:3000/health || exit 1" \
  --health-interval=30s \
  --health-retries=3 \
  --health-timeout=10s \
  --replicas=3 \
  -p 3000:3000 \
  mi-imagen:latest
"Los sistemas distribuidos tolerantes a fallos asumen que los componentes fallarán eventualmente. Diseña tus servicios asumiendo que necesitarán reiniciarse y asegura que el reinicio los lleve a un estado consistente."
exit 0 hardcodeado en tus health checks. Asegúrate de que el comando realmente verifique la funcionalidad de tu aplicación. Un health check que siempre pasa pero no verifica nada es peor que no tener ninguno, porque crea una falsa sensación de seguridad.Resumen de mejores prácticas
| Área | Recomendación |
|---|---|
| Intervalo | No más de 30-60 segundos para servicios críticos. Verificaciones muy frecuentes consumen recursos. |
| Timeout | Debe ser menor que el intervalo para permitir reintentos. |
| Retries | 3-5 intentos son suficientes. Muy pocos pueden causar falsos positivos. |
| Start period | Configúralo para aplicaciones que tardan en inicializar. |
| Reinicio | Usa unless-stopped para producción, on-failure:N con límite para evitar loops. |
¿Cuál es la diferencia principal entre las políticas de reinicio always y unless-stopped?
- A) No hay diferencia, ambas reinician siempre
- B)
alwaysreinicia incluso después de un stop manual, mientrasunless-stoppedrespeta los stops manuales hasta el próximo reinicio de Docker - C)
unless-stoppedsolo reinicia una vez - D)
alwayses para desarrollo yunless-stoppedpara producción
always ignora los stops manuales y reinicia el container al reiniciar el daemon de Docker, mientras unless-stopped respeta la decisión de detenerlo manualmente, manteniendo el container detenido incluso después de reiniciar Docker.¿Qué sucede cuando un health check alcanza el número máximo de fallos configurado en --retries?
- A) El container se elimina automáticamente
- B) El container se marca como unhealthy y puede ser reiniciado según la política de reinicio configurada
- C) Docker envía un email al administrador
- D) Nada, los retries solo afectan los logs
always o unless-stopped, Docker reiniciará el container. Si es on-failure, también reiniciará porque el exit code será diferente de 0.# Comando rápido para verificar todos los health checks de tus containers
docker ps --filter "health=unhealthy" --format "table {{.Names}}\t{{.Status}}"Sigue con Docker para Desarrolladores
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.