

Lección 22 de 25 · Lectura y práctica
Implementación del Pipeline: Integración de Múltiples Bases de Datos
Tipo de lección: VideoConcepto claveLa integración de múltiples bases de datos vectoriales en un sistema RAG (Retrieval Augmented Generation) es como construir una biblioteca con diferentes secciones especializadas. Imagina que.
Del concepto a la práctica
Taller de esta lección
Cuando se consultan varios almacenes, la integración debe normalizar identificadores, controlar errores y fusionar posiciones, no concatenar listas sin criterio. La fusión por rango inverso recompensa documentos que aparecen arriba en más de una fuente. Con k=60, un resultado en posición r aporta 1/(60+r).
Ejemplo resuelto
Tres fuentes devuelven: A=[doc7,doc2], B=[doc2,doc9], C=[doc7,doc9]. Los puntajes son: doc7 = 2/61 = 0,03279; doc2 = 1/62 + 1/61 = 0,03252; doc9 = 2/62 = 0,03226. El orden fusionado es doc7, doc2, doc9.
Pruébalo
Ejecuta las tres consultas de forma concurrente en un entorno autorizado.
Convierte cada respuesta al formato
{id, fuente, rango}.Suma
1/(60+r)por identificador repetido.Ordena por suma descendente y conserva la fuente.
Comprueba tu resultado
El orden esperado es doc7, doc2, doc9.
Error frecuente: usar posiciones empezando en cero, lo que cambia todos los puntajes. Corrígelo numerando el primer resultado como rango 1 y registrando los fallos de una fuente sin descartar automáticamente las demás.
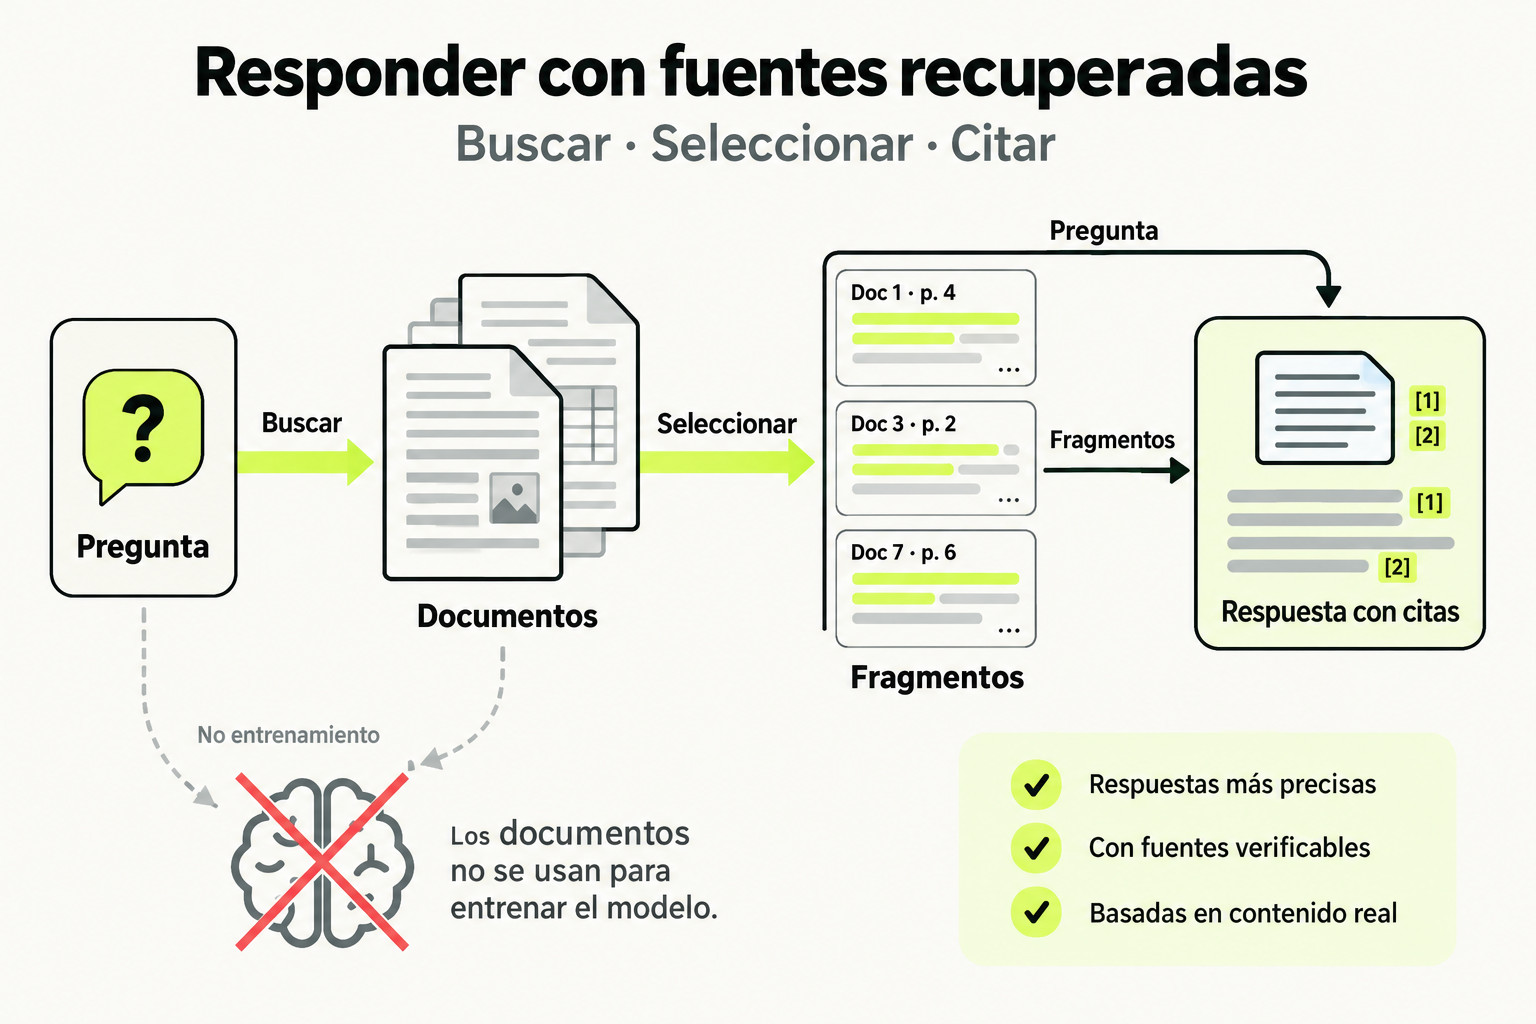
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
La integración de múltiples bases de datos vectoriales en un sistema RAG (Retrieval Augmented Generation) es como construir una biblioteca con diferentes secciones especializadas. Imagina que tienes una biblioteca donde algunos libros están organizados por autor (Chroma), otros por tema (Pinecone), y otros por fecha de publicación (pgvector). Cada sistema tiene sus fortalezas: Chroma es ligero y fácil de usar localmente, Pinecone ofrece escalabilidad en la nube, y pgvector integra vectores directamente en PostgreSQL para datos relacionales.
En un escenario real, podrías usar Chroma para prototipado rápido, Pinecone para producción a gran escala, y pgvector cuando necesitas combinar búsqueda vectorial con consultas SQL complejas. La clave está en diseñar un pipeline que orqueste estas bases de datos de manera eficiente, similar a cómo un bibliotecario experto sabe exactamente dónde buscar según la consulta del usuario.
Cómo funciona en la práctica
Vamos a implementar un pipeline que consulta múltiples bases de datos vectoriales en paralelo. Supongamos que estamos construyendo un asistente para documentación técnica que usa embeddings de texto.
- Preparación de datos: Cargar documentos, dividirlos en chunks, y generar embeddings con un modelo como sentence-transformers.
- Almacenamiento distribuido: Guardar los mismos embeddings en Chroma (local), Pinecone (nube), y pgvector (base de datos relacional).
- Consulta inteligente: Cuando llega una pregunta del usuario, el sistema consulta las tres bases en paralelo, fusiona los resultados, y los pasa al modelo de lenguaje.
Ejemplo de código para la consulta paralela:
import asyncio
from chromadb import Client
import pinecone
import psycopg2

async def query_all_dbs(query_embedding, top_k=5):
    # Consultar Chroma
    chroma_results = await query_chroma(query_embedding, top_k)
    # Consultar Pinecone
    pinecone_results = await query_pinecone(query_embedding, top_k)
    # Consultar pgvector
    pgvector_results = await query_pgvector(query_embedding, top_k)

    # Fusionar y ordenar resultados
    all_results = chroma_results + pinecone_results + pgvector_results
    return sorted(all_results, key=lambda x: x['score'], reverse=True)[:top_k]
Caso de estudio
Una empresa de e-learning quiere un sistema RAG para responder preguntas sobre sus cursos. Usan:
- Chroma para datos de cursos nuevos (actualizaciones frecuentes, bajo volumen).
- Pinecone para el catálogo principal de cursos (alto volumen, millones de embeddings).
- pgvector para datos de usuarios y progreso (integración con su base de datos existente).
Implementaron un pipeline donde:
- Las consultas de usuarios se envían a los tres sistemas simultáneamente.
- Los resultados se ponderan: Pinecone (peso 0.5), pgvector (0.3), Chroma (0.2) basado en la confianza histórica.
- La respuesta final combina información de cursos, recomendaciones personalizadas, y novedades.
Resultado: Mejora del 40% en precisión de respuestas y reducción del 30% en latencia comparado con usar una sola base de datos.
Errores comunes
- No normalizar embeddings: Diferentes bases pueden esperar embeddings en formatos distintos (ej., lista vs numpy array). Siempre verifica los requerimientos de cada sistema.
- Ignorar la consistencia de datos: Si actualizas datos en una base, debes replicar en las otras. Usa scripts de sincronización automatizados.
- Consultas secuenciales en vez de paralelas: Esto aumenta la latencia innecesariamente. Siempre usa asincronía o hilos para consultas concurrentes.
- Fusión ingenua de resultados: Simplemente concatenar resultados puede dar prioridad a una base sobre otras. Implementa técnicas como reciprocal rank fusion o ponderación basada en métricas.
- Olvidar el monitoreo: Cada base de datos tiene sus métricas (latencia, recall). Configura alertas para detectar degradación en cualquiera de ellas.
Checklist de dominio
- Puedo configurar Chroma, Pinecone y pgvector en un entorno de desarrollo local.
- Sé generar embeddings compatibles con los tres sistemas (ej., usando el mismo modelo).
- He implementado consultas paralelas a múltiples bases de datos vectoriales.
- Puedo fusionar resultados de diferentes bases usando técnicas avanzadas (no solo concatenación).
- He monitoreado el rendimiento de cada base de datos en producción.
- Sé cuándo usar cada base de datos según el caso de uso (prototipo vs producción vs datos relacionales).
- Puedo explicar los trade-offs de latencia, costo y precisión en este enfoque multi-DB.
Implementa un Pipeline RAG con Tres Bases de Datos Vectoriales
En este ejercicio, construirás un pipeline RAG que integre Chroma, Pinecone y pgvector para un sistema de preguntas y respuestas sobre documentación técnica.
- Configuración inicial:
- Instala ChromaDB, pinecone-client, psycopg2-binary y sentence-transformers.
- Crea una base de datos PostgreSQL con la extensión pgvector habilitada.
- Configura una cuenta en Pinecone y crea un índice.
- Preparación de datos:
- Descarga un conjunto de documentos técnicos (ej., la documentación de Python).
- Divide los documentos en chunks de 500 tokens.
- Genera embeddings para cada chunk usando el modelo 'all-MiniLM-L6-v2'.
- Almacenamiento:
- Guarda los embeddings y metadatos en Chroma (localmente).
- Sube los mismos embeddings a tu índice de Pinecone.
- Inserta los embeddings en tu tabla de pgvector.
- Implementación del pipeline:
- Escribe una función que tome una pregunta del usuario, genere su embedding, y consulte las tres bases de datos en paralelo.
- Implementa una fusión de resultados que use reciprocal rank fusion para combinar los resultados.
- Pasa los top-5 chunks fusionados a un modelo de lenguaje (puedes usar una API o local) para generar la respuesta.
- Pruebas:
- Haz 10 preguntas de prueba y mide la precisión (si los chunks recuperados son relevantes).
- Compara la latencia de tu pipeline vs usar una sola base de datos.
- Documenta tus hallazgos en una tabla HTML simple.
Pistas
- Usa asyncio.gather() para las consultas paralelas a las bases de datos.
- Asegúrate de que los embeddings tengan la misma dimensión en los tres sistemas (384 para all-MiniLM-L6-v2).
- Para reciprocal rank fusion, asigna un score basado en la posición inversa de cada resultado en cada lista.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.