

Lección 23 de 25 · Lectura y práctica
Evaluación de Rendimiento: Métricas y Pruebas
Concepto claveLa evaluacion de rendimiento en sistemas RAG es como calibrar un sistema de navegacion GPS para un conductor de camiones de larga distancia. No basta con que el GPS encuentre una ruta; debe ser la mas eficiente,.
Del concepto a la práctica
Taller de esta lección
La evaluación debe separar recuperación y respuesta final. Precision@k mide qué proporción de los resultados mostrados es relevante; recall@k mide cuánto de lo relevante conocido fue recuperado. El rango recíproco (RR) es 1 dividido por la posición del primer resultado relevante; MRR es su media entre consultas. No son intercambiables.
Ejemplo resuelto
Para q1, los relevantes son {a,b} y el sistema devuelve [a,c,b]: precision@3=2/3=66,7%, recall@3=2/2=100%, RR=1. Para q2, el relevante es {d} y devuelve [c,d,e]: precision=1/3=33,3%, recall=100%, RR=1/2=0,5. Los promedios son precision 50%, recall 100% y MRR 0,75.
Pruébalo
Crea cinco consultas con conjuntos relevantes explícitos.
Registra los primeros tres IDs devueltos.
Calcula las tres métricas por consulta.
Promedia cada columna por separado.
Comprueba tu resultado
Para los dos casos anteriores, los promedios deben ser 50%, 100% y 0,75.
Error frecuente: llamar recall a la proporción de resultados relevantes mostrados. Corrígelo dividiendo por el total relevante conocido, no por k.
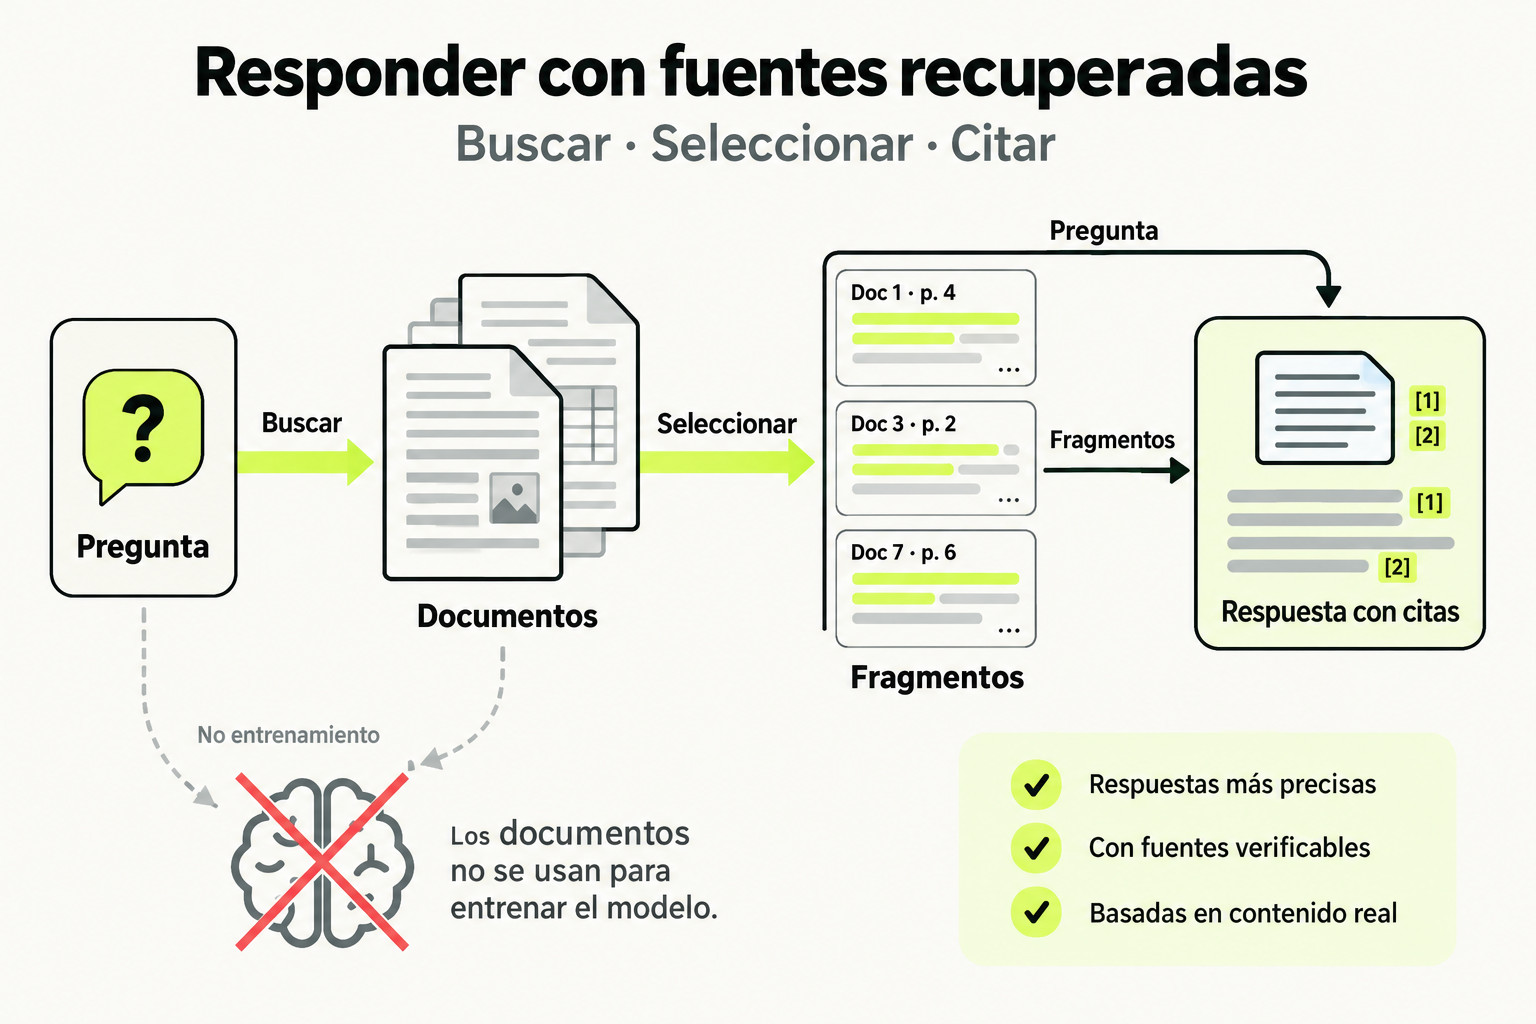
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
La evaluacion de rendimiento en sistemas RAG es como calibrar un sistema de navegacion GPS para un conductor de camiones de larga distancia. No basta con que el GPS encuentre una ruta; debe ser la mas eficiente, precisa y segura para entregar la carga a tiempo. En RAG, esto significa medir que tan bien tu sistema recupera informacion relevante de la base de datos vectorial y la usa para generar respuestas utiles.
Imagina que eres un ingeniero de datos en una empresa de e-commerce. Tu sistema RAG debe responder preguntas de clientes sobre productos, como "¿Que laptop tiene mejor bateria para viajes frecuentes?". La evaluacion te dice si recupera los productos correctos y genera respuestas que realmente ayudan al cliente a decidir. Sin metricas, solo estas adivinando si tu sistema funciona bien.
Práctica: crea una evaluación reproducible
Usa las mismas preguntas para comparar Chroma, Pinecone y pgvector. Registra pregunta, respuesta esperada, contextos recuperados, fidelidad, relevancia de la respuesta, recall/precision del contexto y latencia. Compara calidad y velocidad; una respuesta más rápida no es mejor si recupera peor evidencia.
Como funciona en la practica
Vamos a evaluar un sistema RAG que usa Chroma para buscar laptops en una base de datos. Supongamos que tienes 100 consultas de prueba con respuestas ideales predefinidas. El proceso paso a paso:
- Preparar datos de prueba: Crea un conjunto de 100 preguntas de clientes y las respuestas correctas esperadas. Ejemplo: Pregunta: "Laptop para programar con buen rendimiento bajo 1000€", Respuesta ideal: "Modelo X con procesador Y y 16GB RAM".
- Ejecutar el sistema RAG: Para cada pregunta, tu sistema recupera los 5 productos mas relevantes de Chroma y genera una respuesta.
- Calcular metricas clave:
- Precision@K: De los K productos recuperados, cuantos son realmente relevantes. Si K=5 y 3 productos son relevantes, Precision@5 = 3/5 = 0.6.
- Recall@K: De todos los productos relevantes en la base de datos, cuantos recuperaste en los primeros K. Si hay 10 productos relevantes y recuperas 4 en los primeros 5, Recall@5 = 4/10 = 0.4.
- F1-Score: Media armonica de Precision y Recall: F1 = 2 * (Precision * Recall) / (Precision + Recall).
- Latencia: Tiempo desde la pregunta hasta la respuesta, medido en segundos.
- Analizar resultados: Usa una tabla para resumir:
Metrica Valor Objetivo Valor Actual Accion Precision@5 >0.7 0.6 Mejorar embeddings Recall@5 >0.5 0.4 Ajustar K o consultas Latencia <2s 3s Optimizar indice Chroma
Caso de estudio
En una startup de salud, implementamos un sistema RAG con Pinecone para responder preguntas sobre sintomas medicos. El objetivo: recuperar informacion precisa de una base de 10,000 documentos medicos y generar respuestas claras. Evaluamos con 50 preguntas reales de usuarios.
Resultados iniciales: Precision@3 = 0.65, Recall@3 = 0.55, latencia = 4s. El problema: los embeddings no capturaban bien terminos medicos. Solucion: Fine-tunamos el modelo de embeddings con datos medicos especificos. Despues: Precision@3 = 0.8, Recall@3 = 0.7, latencia = 2s (optimizando el indice Pinecone).
La evaluacion continua es clave; monitoreamos metricas semanalmente para detectar degradaciones, como cambios en las consultas de usuarios.
Errores comunes
- Evaluar solo con datos sinteticos: Usar preguntas generadas por IA en lugar de casos reales lleva a metricas infladas. Solucion: Recopila preguntas reales de usuarios o simula escenarios del mundo real.
- Ignorar la latencia: Enfocarse solo en precision y recall, pero si el sistema tarda 10 segundos en responder, los usuarios lo abandonaran. Solucion: Mide latencia en condiciones de carga real y establece objetivos claros (ej., <3s para el 95% de consultas).
- No definir K adecuadamente: Usar K=10 cuando los usuarios solo ven los primeros 3 resultados desperdicia recursos. Solucion: Analiza el uso real (ej., en una app movil, K=3 puede ser suficiente) y ajusta K segun el contexto.
- Olvidar la evaluacion de la generacion: Medir solo la recuperacion, pero la calidad de la respuesta generada es crucial. Solucion: Incluye metricas como BLEU o ROUGE para comparar respuestas generadas con ideales, o haz evaluacion humana con una muestra.
Checklist de dominio
- He definido un conjunto de datos de prueba con al menos 50 preguntas reales o simuladas realisticas.
- He calculado Precision@K, Recall@K y F1-Score para mi sistema RAG con Chroma/Pinecone/pgvector.
- He medido la latencia del sistema en un entorno similar a produccion (ej., con carga concurrente).
- He comparado metricas con objetivos basados en requisitos de negocio (ej., Precision@5 > 0.7).
- He identificado al menos un cuello de botella en el rendimiento (ej., embeddings, indice, generacion).
- He documentado los resultados y planes de mejora en un informe ejecutivo.
- He configurado monitoreo basico para metricas clave en despliegue (ej., con logs o dashboards).
Evaluacion de un Sistema RAG con Chroma para Preguntas sobre Productos
En este ejercicio, evaluaras el rendimiento de un sistema RAG simple que usa Chroma para responder preguntas sobre productos electronicos. Sigue estos pasos:
- Configura el entorno:
- Instala ChromaDB y un modelo de embeddings como sentence-transformers (ej., 'all-MiniLM-L6-v2').
- Crea una base de datos vectorial en Chroma con 20 productos electronicos ficticios. Cada producto debe tener: nombre, descripcion (2-3 oraciones), precio y categoria (ej., laptop, telefono). Usa embeddings basados en la descripcion.
- Prepara datos de prueba:
- Genera 10 preguntas de clientes realistas, como "Telefono con buena camara bajo 500€" o "Laptop ligera para estudiar".
- Define manualmente las respuestas ideales para cada pregunta, listando los 3 productos mas relevantes de tu base de datos.
- Implementa y ejecuta:
- Construye un sistema RAG basico: para cada pregunta, recupera los 5 productos mas similares de Chroma usando similitud coseno.
- Genera una respuesta simple que liste los productos recuperados con sus nombres y precios.
- Ejecuta las 10 preguntas y registra los productos recuperados.
- Calcula metricas:
- Para cada pregunta, calcula Precision@5 (cuantos de los 5 recuperados estan en tu lista de 3 ideales) y Recall@5 (cuantos de los 3 ideales fueron recuperados en los 5).
- Promedia los resultados sobre las 10 preguntas para obtener Precision@5 y Recall@5 globales.
- Mide el tiempo promedio de respuesta (latencia) para las 10 consultas.
- Analiza y reporta:
- Crea una tabla HTML con las metricas calculadas y comparalas con objetivos razonables (ej., Precision@5 > 0.6, latencia < 1s).
- Identifica un area de mejora (ej., calidad de embeddings, tamano de K) y propone una accion concreta.
Pistas
- Usa la funcion 'similarity_search' de Chroma para recuperar productos basados en embeddings de la pregunta.
- Para calcular Precision@5, cuenta cuantos productos recuperados coinciden con tu lista ideal; si no hay coincidencias, Precision@5 = 0.
- Si la latencia es alta, prueba a reducir el numero de dimensiones en los embeddings o a indexar menos productos.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.