

Lección 4 de 20 · Lectura y práctica
Ejercicio: Configurar un DAG que Ejecute un Script Python
Concepto claveUn DAG (Grafo Acíclico Dirigido) en Apache Airflow es la unidad fundamental de orquestación que define un flujo de trabajo de datos. Piensa en él como un plano arquitectónico para tu pipeline: especifica qué tareas.
Del concepto a la práctica
Taller de esta lección
Ejecutar un script desde Airflow exige definir con claridad su contrato: entrada, salida, código de retorno y ubicación. Un script que crea un archivo temporal puede servir para practicar, siempre que la tarea compruebe la existencia del resultado y no dependa de rutas ambiguas. La función de Airflow debe invocarlo de forma controlada y registrar el nombre generado.
Ejemplo resuelto
Usa un script local que reciba entrada.txt, cuente sus caracteres y escriba resultado.txt. Con el contenido dato hay cuatro caracteres. La tarea comprueba que el archivo de salida existe y muestra caracteres=4; no borra la entrada original.
Pruébalo
Escribe el script y prueba su ejecución fuera de Airflow.
Crea una tarea que lo invoque con rutas absolutas del entorno de práctica.
Encadena una validación que lea el resultado.
Ejecuta una prueba de tarea y luego una ejecución completa.
Comprueba tu resultado
Error frecuente: pasar la función con paréntesis o asumir que el directorio de trabajo es el proyecto. Corrige usando un callable sin invocarlo al declarar la tarea y rutas explícitas. El resultado esperado es resultado.txt con caracteres=4 y un log que confirme su existencia.
Script íntegro y conteo sin ambigüedad
Guarda el siguiente archivo como contar.py y proporciona una entrada UTF-8 que contenga exactamente dato, sin salto de línea final:
import sys
from pathlib import Path

entrada = Path(sys.argv[1])
salida = Path(sys.argv[2])
contenido = entrada.read_text(encoding="utf-8")
salida.write_text(f"caracteres={len(contenido)}\n", encoding="utf-8")
La ejecución fuera de Airflow recibe tres argumentos: intérprete Python, ruta a contar.py y las dos rutas de archivos. Desde una función de tarea usa subprocess.run([sys.executable, ruta_script, ruta_entrada, ruta_salida], check=True, timeout=20), sin concatenar una orden de shell. Todos los archivos pertenecen a una carpeta de prueba montada en el worker. El resultado para dato es 4; si escribes dato
, es 5. Especificar el salto de línea evita confundir caracteres con bytes o con el tamaño que muestra el explorador.
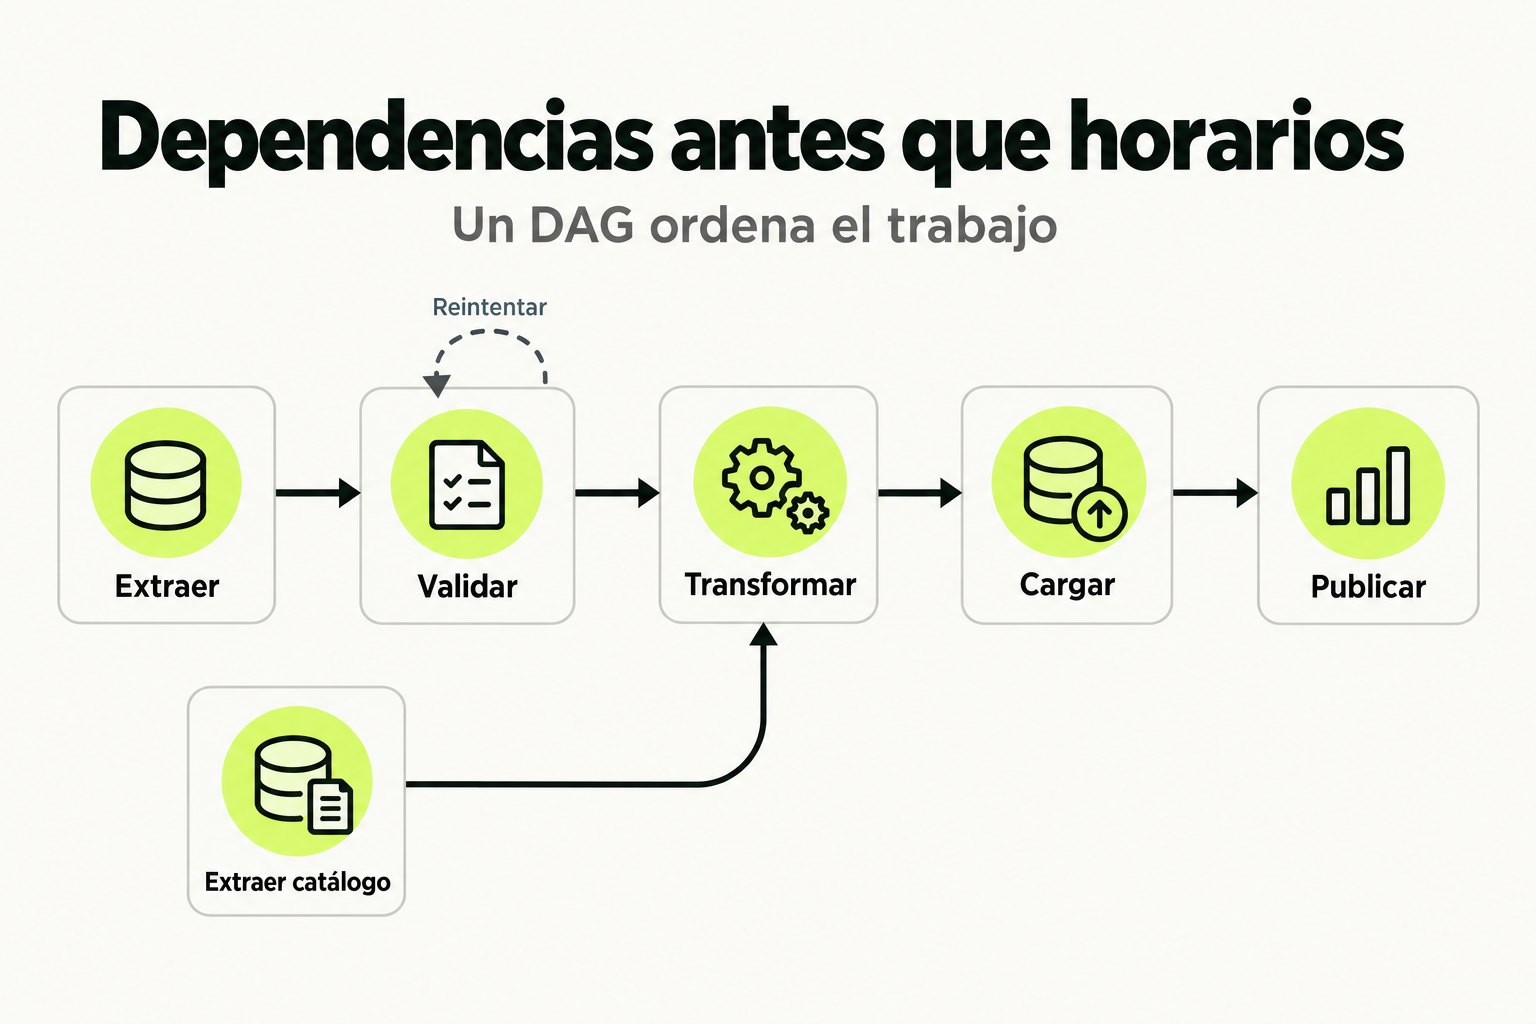
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Concepto clave
Un DAG (Grafo Acíclico Dirigido) en Apache Airflow es la unidad fundamental de orquestación que define un flujo de trabajo de datos. Piensa en él como un plano arquitectónico para tu pipeline: especifica qué tareas deben ejecutarse, en qué orden y bajo qué condiciones. A diferencia de un script secuencial tradicional, un DAG permite paralelismo, reintentos automáticos y monitoreo centralizado.
La analogía perfecta es una receta de cocina compleja. El DAG es la receta completa, mientras que cada paso (picar verduras, cocinar la carne, preparar la salsa) es una tarea individual. Algunos pasos pueden ejecutarse simultáneamente (como picar verduras mientras se cocina la carne), otros dependen de pasos anteriores (no puedes ensamblar el plato sin tener los ingredientes listos), y si algo falla (se quema la carne), puedes configurar reintentos automáticos.
Cómo funciona en la práctica
Para configurar un DAG que ejecute un script Python, sigues una estructura específica. Primero, defines el DAG con metadatos como schedule_interval (cada cuánto se ejecuta) y start_date (cuándo comienza). Luego, creas tareas usando operadores como PythonOperator, que ejecuta funciones Python, o BashOperator para comandos de shell. Finalmente, estableces las dependencias entre tareas usando los operadores >> y <<.
Ejemplo básico: imagina que necesitas procesar datos de ventas diarias. Tu DAG podría tener tres tareas: 1) Descargar el archivo CSV desde un servidor FTP, 2) Transformar los datos con un script Python que calcula métricas, 3) Cargar los resultados a una base de datos. En código, se vería así:
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime

def procesar_datos():
    # Tu lógica de transformación aquí
    print("Ejecutando script Python")

default_args = {
    'owner': 'data_engineer',
    'start_date': datetime(2023, 1, 1),
}

with DAG('procesar_ventas', default_args=default_args, schedule_interval='@daily') as dag:
    tarea_procesar = PythonOperator(
        task_id='ejecutar_script',
        python_callable=procesar_datos
    )
Caso de estudio
Una empresa de e-commerce necesita actualizar diariamente su dashboard de análisis. El pipeline extrae datos de ventas de una API REST, los transforma para calcular KPIs como conversión y ticket promedio, y los carga a Redshift para visualización. Implementamos un DAG con tres tareas:
- Extraer: PythonOperator que llama a la API y guarda los datos en formato JSON.
- Transformar: PythonOperator que ejecuta un script Python que lee el JSON, calcula métricas y genera un DataFrame.
- Cargar: PythonOperator que inserta el DataFrame en Redshift usando pandas y SQLAlchemy.
La configuración incluye manejo de errores: si la API falla, la tarea se reintenta 3 veces con un retraso de 5 minutos. Además, usamos XCom para pasar datos entre tareas (ej., el nombre del archivo JSON de la extracción a la transformación).
En producción, este DAG procesa 50GB de datos diarios y reduce el tiempo de actualización del dashboard de 2 horas (manual) a 15 minutos (automatizado).
Errores comunes
- Mal manejo de start_date y schedule_interval: Si start_date es una fecha futura o schedule_interval está mal configurado, el DAG no se ejecutará. Solución: Usa datetime objects para start_date y cron expressions válidas (ej., '0 2 * * *' para 2 AM diario).
- Scripts Python con dependencias no instaladas: Airflow ejecuta tareas en su entorno; si tu script importa librerías como pandas y no están instaladas, fallará. Solución: Usa virtual environments o instala dependencias en el Dockerfile si usas contenedores.
- No definir dependencias entre tareas: Si olvidas usar >> o <<, las tareas se ejecutarán en paralelo por defecto, causando errores si una depende de otra. Solución: Siempre mapea el flujo, ej., tarea_extraer >> tarea_transformar >> tarea_cargar.
- Ignorar el logging y monitoreo: Sin logs detallados, depurar fallos es difícil. Solución: Configura logging en tu script Python y revisa los logs en la UI de Airflow.
Checklist de dominio
- ¿Puedes crear un DAG básico con PythonOperator que ejecute una función simple?
- ¿Sabes configurar schedule_interval usando cron expressions o presets como '@daily'?
- ¿Entiendes cómo pasar parámetros entre tareas usando op_args o XCom?
- ¿Puedes manejar errores configurando retries y retry_delay en default_args?
- ¿Sabes verificar la ejecución del DAG en la UI de Airflow y leer los logs?
- ¿Puedes estructurar un pipeline ETL con tareas de extracción, transformación y carga?
- ¿Entiendes la diferencia entre ejecución secuencial y paralela en un DAG?
Configurar un DAG para procesar datos de clima
En este ejercicio, crearás un DAG en Apache Airflow que ejecute un script Python para procesar datos de clima. Sigue estos pasos:
- Prepara el entorno: Asegúrate de tener Airflow instalado y funcionando. Crea un directorio para tus DAGs si no existe (por defecto, ~/airflow/dags).
- Crea el script Python: En un archivo llamado procesar_clima.py, escribe una función que simule procesar datos. Ejemplo:
def procesar_clima(): import pandas as pd # Simular datos de temperatura datos = {'ciudad': ['Madrid', 'Barcelona'], 'temp': [22, 20]} df = pd.DataFrame(datos) print(f"Datos procesados: {df}") return df.to_json() - Define el DAG: En un archivo llamado clima_dag.py, importa los módulos necesarios, define default_args con owner y start_date, y crea un DAG llamado 'procesar_clima_diario' con schedule_interval diario.
- Añade la tarea: Usa PythonOperator para crear una tarea que ejecute la función procesar_clima. Asigna un task_id descriptivo como 'ejecutar_procesamiento'.
- Prueba el DAG: Guarda los archivos en el directorio de DAGs, espera unos segundos para que Airflow los detecte, y verifica en la UI (localhost:8080) que el DAG aparece. Actívalo y ejecuta una instancia manualmente.
- Verifica la ejecución: Revisa los logs en la UI para confirmar que el script se ejecutó correctamente y mostró los datos procesados.
Pistas
- Recuerda que la función en PythonOperator debe ser callable (sin paréntesis al pasarla).
- Si el DAG no aparece en la UI, verifica que los archivos estén en el directorio correcto y que Airflow esté corriendo.
- Usa 'airflow tasks test [dag_id] [task_id] [execution_date]' para probar una tarea sin activar el DAG completo.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.