

Lección 3 de 20 · Lectura y práctica
Crear tu Primer DAG para un Pipeline Simple
Tipo de lección: VideoConcepto claveUn DAG (Directed Acyclic Graph) en Apache Airflow es la unidad fundamental para definir workflows de datos. Imagina que estás organizando una cadena de producción en una fábrica: cada paso.
Del concepto a la práctica
Taller de esta lección
Un primer DAG debe demostrar una ejecución repetible, no abarcar todo un sistema ETL. La combinación de una fecha de inicio fija, un intervalo explícito y catchup=False limita ejecuciones inesperadas. La función de tarea debe producir una salida observable y no depender de la hora actual para que una prueba pueda compararse.
Ejemplo resuelto
Crea contar_lineas para leer un archivo local con cuatro líneas y devolver 4. Encadena después registrar_resultado, que escribe lineas=4 en un archivo de salida. El grafo tiene solo dos nodos, pero permite comprobar lectura, dependencia y resultado.
Pruébalo
Prepara un archivo con las líneas
A,B,CyD.Define el DAG con una fecha pasada y
catchup=False.Ejecuta primero la tarea de conteo en modo de prueba.
Ejecuta el DAG completo y abre la salida.
Comprueba tu resultado
Error frecuente: usar datetime.now() como fecha de inicio y obtener una programación difícil de reproducir. Corrige con una fecha fija. El resultado esperado es una ejecución completada, cuatro líneas contadas y una salida que contiene lineas=4; si el archivo cambia, el nuevo conteo debe reflejar exactamente sus líneas.
Archivo de entrada y dos tareas completas
En una carpeta propia de práctica, crea entrada.txt con el texto exacto A
B
C
D
y prepara un montaje visible para los workers. Configura Cursalo ruta práctica como documentación de esa ruta; el ejemplo utiliza /opt/airflow/cursalo-practica:
from datetime import datetime, timezone
from pathlib import Path
from airflow.sdk import dag, task

@dag(dag_id="cursalo_contar_lineas", schedule=None,
     start_date=datetime(2026, 1, 1, tzinfo=timezone.utc),
     catchup=False, default_args={"retries": 0})
def flujo():
    @task
    def contar_lineas():
        ruta = Path("/opt/airflow/cursalo-practica/entrada.txt")
        return len(ruta.read_text(encoding="utf-8").splitlines())

    @task
    def registrar_resultado(numero):
        ruta = Path("/opt/airflow/cursalo-practica/resultado.txt")
        ruta.write_text(f"lineas={numero}\n", encoding="utf-8")
        print(f"lineas={numero}")

    registrar_resultado(contar_lineas())

flujo()
No se debe generar el archivo de entrada mientras Airflow importa el DAG. El montaje debe existir en cualquier worker que ejecute estas tareas; un archivo privado en /tmp no cumple esa condición. La fecha inicial es fija y la prueba se dispara manualmente. TaskFlow.
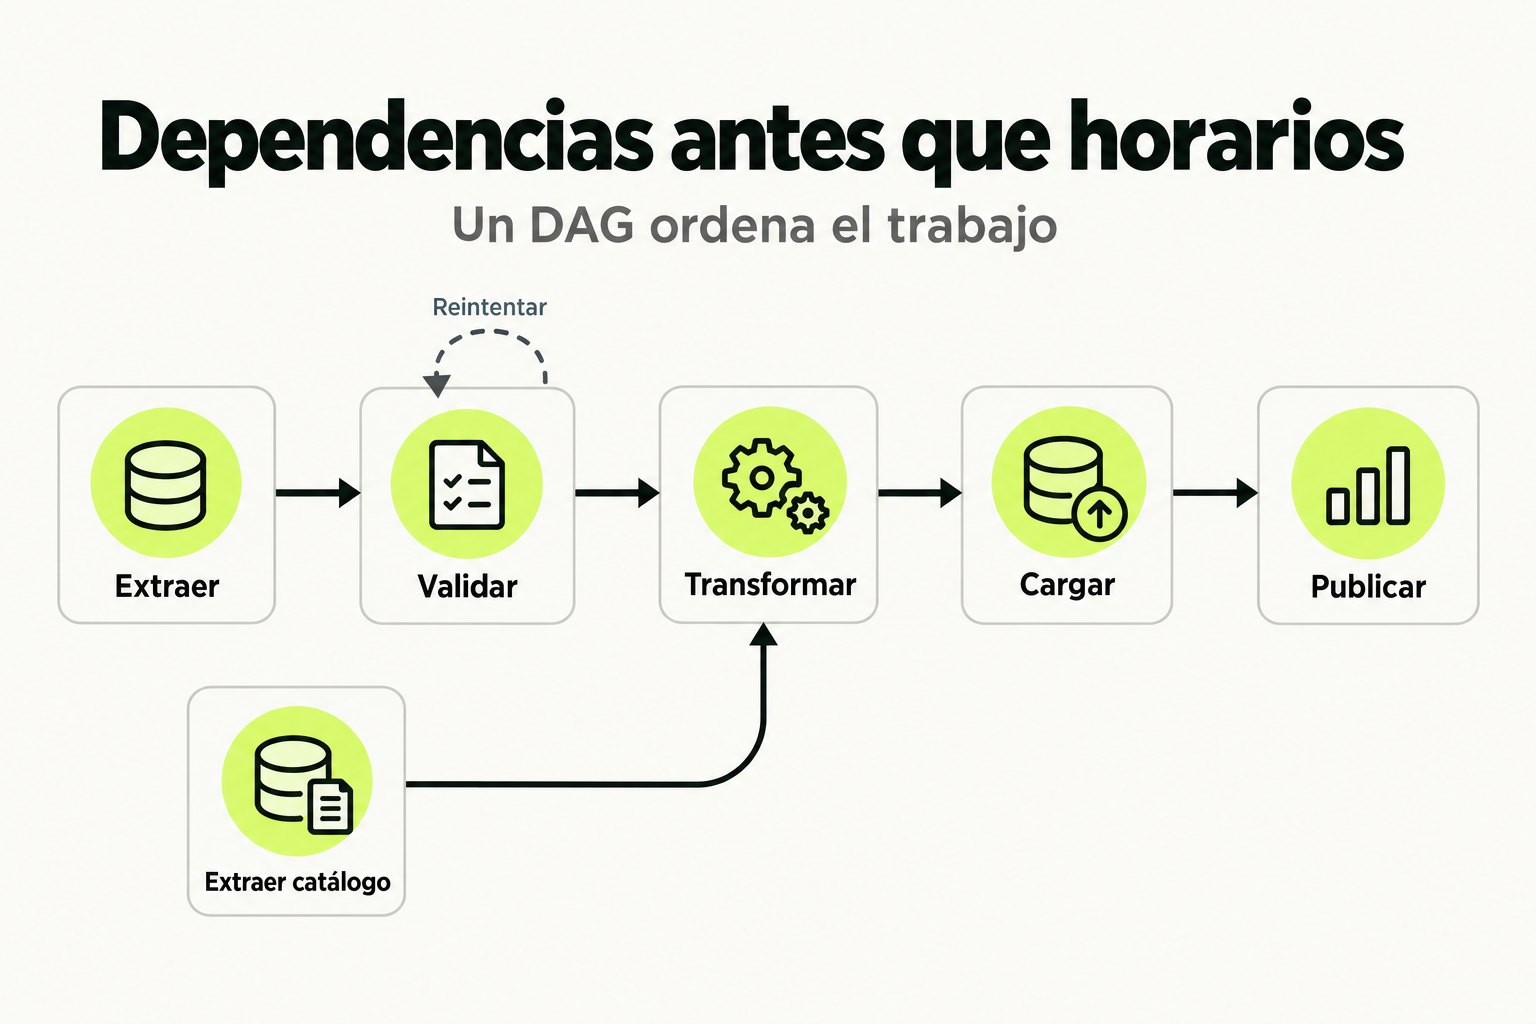
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
Un DAG (Directed Acyclic Graph) en Apache Airflow es la unidad fundamental para definir workflows de datos. Imagina que estás organizando una cadena de producción en una fábrica: cada paso (como cortar, ensamblar, pintar) es una tarea, y el DAG es el plano que define el orden y las dependencias entre ellas, asegurando que no haya ciclos (como pintar antes de ensamblar). En el contexto de pipelines ETL, un DAG orquesta extracciones, transformaciones y cargas de datos de manera automatizada y programable.
La clave de Airflow es que los DAGs son definidos en código Python, lo que permite versionamiento, pruebas y reutilización. A diferencia de herramientas visuales donde arrastras bloques, aquí escribes la lógica del pipeline como un script, dando control total sobre la ejecución. Esto es especialmente útil para pipelines complejos que requieren manejo de errores, reintentos y monitoreo detallado.
Cómo funciona en la práctica
Para crear tu primer DAG, sigue estos pasos en un entorno de Airflow configurado:
- Define un archivo Python en la carpeta
dags/de Airflow (por ejemplo,mi_primer_dag.py). - Importa los módulos necesarios:
from airflow import DAGyfrom airflow.operators.python import PythonOperator. - Crea un objeto DAG con parámetros como
dag_id,schedule_interval(ej.,@daily), ystart_date. - Define funciones Python que representen tareas, como una función que simule extraer datos de una API.
- Instancia operadores (como
PythonOperator) para cada tarea, vinculándolos al DAG y a las funciones. - Establece dependencias usando el operador
>>(ej.,tarea1 >> tarea2) para indicar el flujo.
Ejemplo básico de código:
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime

def extraer_datos():
    print("Extrayendo datos...")

def transformar_datos():
    print("Transformando datos...")

with DAG(
    dag_id="primer_pipeline",
    schedule_interval="@daily",
    start_date=datetime(2023, 1, 1),
    catchup=False
) as dag:
    tarea_extraer = PythonOperator(
        task_id="extraer",
        python_callable=extraer_datos
    )
    tarea_transformar = PythonOperator(
        task_id="transformar",
        python_callable=transformar_datos
    )
    tarea_extraer >> tarea_transformar
Caso de estudio
Supongamos que trabajas en una empresa de e-commerce y necesitas un pipeline diario para analizar ventas. El DAG debe:
- Extraer datos de ventas de una base de datos SQL (ej., PostgreSQL) cada día a las 6 AM.
- Transformar los datos calculando métricas como ventas totales y promedio por producto.
- Cargar los resultados en un almacén de datos (ej., Amazon Redshift) para reportes.
En la práctica, esto se implementa con operadores específicos (como PostgresOperator para extracción y RedshiftOperator para carga), pero el concepto de DAG permanece igual. Un error común aquí es no manejar conexiones de base de datos correctamente en Airflow, lo que se soluciona configurando Connections en la interfaz web.
En proyectos reales, los DAGs suelen manejar terabytes de datos, por lo que la eficiencia en las tareas es crítica. Usa operadores nativos de Airflow cuando sea posible para aprovechar características como reintentos automáticos.
Errores comunes
- Definir
start_dateen el futuro o de forma dinámica: Esto puede causar que el DAG no se ejecute. Usa fechas fijas pasadas y evita funciones comodatetime.now(). - Olvidar
catchup=False: Si no se establece, Airflow intentará ejecutar todas las instancias pasadas desdestart_date, saturando el sistema. Configúralo según la necesidad del pipeline. - No probar tareas localmente: Antes de desplegar, ejecuta
airflow tasks testpara verificar que cada tarea funcione sin errores de sintaxis o lógica. - Usar recursos intensivos en el scheduler: Evita tareas pesadas en la definición del DAG (fuera de los operadores), ya que el scheduler lee el archivo frecuentemente, lo que puede ralentizar Airflow.
- Ignorar el manejo de dependencias externas: Si una tarea depende de un archivo o API externa, incluye verificaciones o use sensores (
Sensoroperators) para esperar disponibilidad.
Checklist de dominio
- Puedo crear un archivo DAG básico en Python con al menos dos tareas y dependencias.
- Entiendo cómo configurar
schedule_intervalpara ejecuciones periódicas (ej., diarias o horarias). - Sé cómo probar una tarea individual usando el comando
airflow tasks testen la terminal. - Puedo identificar y evitar ciclos en las dependencias de tareas (asegurando que el grafo sea acíclico).
- Conozco la diferencia entre operadores (como
PythonOperatorvs.BashOperator) y cuándo usar cada uno. - Sé cómo monitorear la ejecución del DAG en la interfaz web de Airflow (ej., ver logs y estados).
- Puedo explicar el impacto de
catchupen la ejecución histórica de pipelines.
Implementa un DAG para procesar logs de servidor
En este ejercicio, crearás un DAG simple que simula un pipeline ETL para logs de servidor. Sigue estos pasos:
- Asegúrate de tener Apache Airflow instalado y corriendo localmente (puedes usar Docker o una instalación directa).
- En la carpeta
dags/de tu instalación de Airflow, crea un nuevo archivo Python llamadoprocesar_logs.py. - Define un DAG con ID
procesamiento_logs, programado para ejecutarse cada hora (schedule_interval='@hourly'), constart_datefijado a ayer ycatchup=False. - Crea tres tareas usando
PythonOperator:leer_logs: Una función que imprime "Leyendo archivo de logs..." y simula leer un archivo de texto.filtrar_errores: Una función que imprime "Filtrando errores del log..." y simula extraer líneas con la palabra 'ERROR'.guardar_resultados: Una función que imprime "Guardando resultados en base de datos..." y simula insertar datos en SQL.
- Establece las dependencias para que las tareas se ejecuten en orden: primero
leer_logs, luegofiltrar_errores, y finalmenteguardar_resultados. - Guarda el archivo y verifica en la interfaz web de Airflow que el DAG aparezca y esté activo. Ejecuta una instancia manualmente para probarlo.
Entrega: Proporciona el código completo del archivo procesar_logs.py y una captura de pantalla de la ejecución exitosa en Airflow.
Pistas
- Recuerda importar los módulos necesarios al inicio del archivo, como DAG y PythonOperator.
- Usa el operador >> para definir dependencias entre tareas, por ejemplo: tarea1 >> tarea2 >> tarea3.
- Si el DAG no aparece en la interfaz web, verifica que el archivo esté en la carpeta correcta y que Airflow esté recargando DAGs (default cada 30 segundos).
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.