

Data Science con Python y Pandas
Domina el análisis de datos con Python y Pandas. Aprende a limpiar, transformar y visualizar datos para tomar decisiones basadas en evidencia. Es un curso en español con 4 módulos y 16 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 132 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Construir y manipular DataFrames, seleccionando filas y columnas con criterios explícitos.
- Limpiar valores ausentes, tipos, duplicados y outliers documentando cada decisión.
- Calcular estadísticas y agregaciones verificables por categoría y periodo.
- Crear un análisis de ventas con visualizaciones, métricas reproducibles y conclusiones prudentes.
Este curso presenta un recorrido práctico para convertir registros tabulares en decisiones verificables. El punto de partida es reconocer qué representa cada observación y cómo se organiza en Pandas: una Serie para una variable y un DataFrame para una tabla con filas, columnas e índices. Sobre esa base se construyen tablas pequeñas, se inspeccionan tipos y se seleccionan subconjuntos sin perder trazabilidad.
El primer módulo trabaja la estructura del análisis. Aprenderás a crear DataFrames desde diccionarios o listas, modificar columnas y aplicar filtros combinados. La evaluación de fundamentos comprobará que puedas interpretar una tabla, elegir una operación adecuada y justificar el resultado, no solo memorizar sintaxis.
El segundo módulo se concentra en la calidad de los datos. Los valores ausentes requieren una decisión vinculada al significado de la variable: eliminar una fila puede ser razonable para un campo imprescindible, mientras que imputar una mediana puede ser más prudente para una medida numérica. También se revisan tipos, formatos, escalas, duplicados y valores extremos. Cada transformación debe dejar evidencia de qué cambió y por qué.
El tercer módulo convierte la tabla limpia en evidencia descriptiva. Se calcularán conteos, medias, medianas, mínimos, máximos y medidas agrupadas. La agrupación permite comparar regiones, categorías o periodos, pero exige distinguir entre número de filas, suma de importes y promedio por operación. Después se elegirán gráficos según la pregunta: líneas para evolución temporal, barras para comparar categorías y dispersión para observar relaciones entre variables. Una visualización útil debe incluir unidades, etiquetas y una interpretación limitada a lo que muestran los datos.
El módulo integrador reúne el proceso en un análisis de ventas. Primero se formula una pregunta concreta y se carga un conjunto de registros con una estructura conocida. Luego se documentan las reglas de limpieza, se calculan métricas reproducibles y se investigan patrones por fecha, producto, región o canal. El análisis no termina al hallar una diferencia: hay que comprobar cuántos registros la sostienen, identificar posibles sesgos y separar una asociación descriptiva de una explicación causal.
El trabajo final será un dashboard compacto acompañado de conclusiones. Deberá mostrar indicadores cuyo cálculo pueda reconstruirse, filtros coherentes y visualizaciones que respondan a preguntas explícitas. También incluirá una nota metodológica con los cambios aplicados al dataset y sus limitaciones. Para comprobar el aprendizaje, otra persona debería poder ejecutar el procedimiento con los mismos registros y obtener los mismos totales. La evaluación considerará la integridad de los datos, la corrección aritmética, la claridad visual, la trazabilidad del código y la prudencia de las conclusiones. El objetivo es practicar un flujo completo: preguntar, inspeccionar, limpiar, resumir, visualizar y comunicar con evidencia.
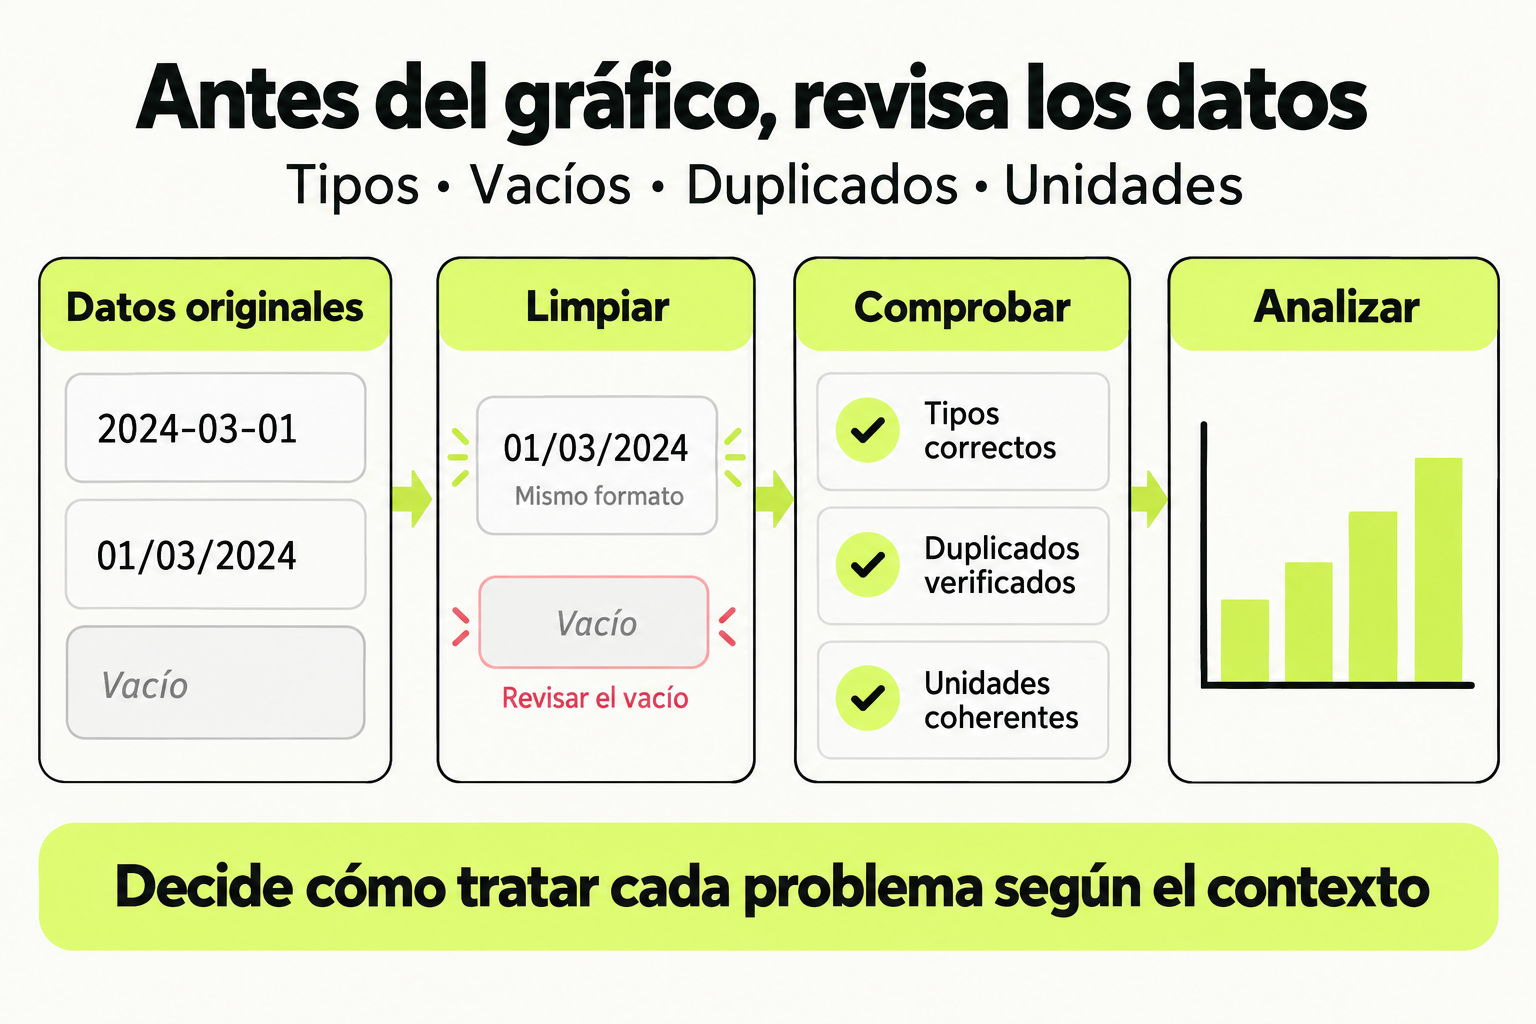
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Proyecto final
Informe reproducible de ventas por región y categoría
Construye un análisis local a partir de un dataset de ventas con fecha, región, categoría, unidades y precio unitario. Define una pregunta de negocio, prepara los datos, calcula métricas y presenta un dashboard compacto que permita comparar resultados sin ocultar las reglas aplicadas.
Qué entregar
- Archivo o notebook con carga, inspección, limpieza y cálculos reproducibles.
- Dashboard con al menos tres métricas, un filtro documentado y dos visualizaciones adecuadas.
- Informe breve con pregunta, decisiones de preparación, resultados, limitaciones y conclusiones.
- Tabla de control con totales antes y después de las transformaciones relevantes.
Cómo comprobarlo
- Las columnas, tipos, unidades y reglas de limpieza están documentados.
- Los totales y porcentajes se pueden recalcular desde los registros entregados.
- Las visualizaciones responden a preguntas concretas y tienen etiquetas comprensibles.
- Las conclusiones distinguen evidencia descriptiva de hipótesis y reconocen limitaciones.
- El procedimiento conserva los datos originales y evita transformaciones no justificadas.
Temario completo
16 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos de Pandas para Análisis de Datos
- Introducción a Pandas y estructuras de datos
- Creación y manipulación de DataFrames
- Selección y filtrado de datos avanzado
- Evaluación: Fundamentos de Pandas
Limpieza y Transformación de Datos
- Manejo de valores nulos y datos faltantes
- Conversión de tipos de datos y normalización
- Eliminación de duplicados y outliers
- Evaluación: Limpieza y Transformación
Análisis Exploratorio y Visualización
- Estadística descriptiva con Pandas
- Agrupaciones y funciones de agregación
- Visualización de datos con Matplotlib y Seaborn
- Evaluación: Análisis y Visualización
Proyecto Integrador: Análisis de Ventas
- Planteamiento del proyecto y carga de datos
- Limpieza y preparación del dataset
- Análisis de patrones y tendencias de ventas
- Proyecto Final: Dashboard y Conclusiones
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Data Science con Python y Pandas?
Puedes adquirir el curso Data Science con Python y Pandas con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Data Science con Python y Pandas?
Es un curso completo en español con 4 módulos y 16 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Data Science con Python y Pandas?
Revisa el temario público para comprobar el punto de partida y la progresión de Data Science con Python y Pandas. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Data Science con Python y Pandas entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Qué formato tiene el curso?
El formato actual es lectura y práctica. Consulta las lecciones y sus recursos; no se ofrece como un curso completo de video.
¿Puedo revisar el programa antes de pagar?
Sí. El temario y esta ficha son públicos. Compara el contenido y los requisitos con tu objetivo antes de elegir una compra individual o un acceso a toda la escuela en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Otros cursos de IA
Ver todo el catálogo →- Análisis de Datos con Google Sheets y SQLDomina las herramientas esenciales para analizar datos. Aprende a manipular hojas de cálculo en Google Sheets y a realizar consultas SQL para extraer información valiosa de bases de datos.
- Apache Airflow para ETL: Integraciones y Pipelines en Tiempo RealCurso práctico para data engineers que desean dominar Apache Airflow en la automatización de pipelines ETL. Aprenderás a diseñar, implementar y monitorear DAGs robustos para flujos de trabajo complejos, integrando herramientas como Python, SQL y bases de datos. Al finalizar, serás capaz de construir pipelines escalables y.
- Apache Airflow: Construcción de Pipelines ETL Automatizados con DAGsCurso práctico para data engineers que desean dominar Apache Airflow en la orquestación de pipelines ETL complejos. Aprenderás a diseñar, programar y monitorear DAGs robustos, integrando herramientas como Python, bases de datos y APIs. Al finalizar, serás capaz de automatizar flujos de datos escalables en entornos productivos.
- Apache Airflow: Orquestación de Pipelines ETL Complejos con DAGsCurso práctico para data engineers que desean dominar Apache Airflow en la automatización de pipelines ETL. Aprenderás a diseñar, programar y monitorear DAGs complejos, integrando múltiples fuentes de datos y herramientas. Al finalizar, serás capaz de implementar soluciones robustas de orquestación en entornos productivos.