

Containerización y Despliegue de Modelos ML con Docker y Kubernetes
Aprende a containerizar tus flujos de machine learning con Docker y desplegar modelos en producción usando Kubernetes. Este curso práctico te guiará desde los conceptos básicos hasta la implementación de pipelines escalables en entornos cloud. Es un curso en español con 5 módulos y 25 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 131 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Construir imágenes Docker reproducibles para scripts, modelos y APIs de machine learning.
- Separar código, configuración, artefactos y datos persistentes en un proyecto ML.
- Exponer un modelo mediante una API REST con validación, errores y registros claros.
- Crear Deployments y Services de Kubernetes con réplicas, recursos y sondas de salud.
- Usar ConfigMaps y Secrets sin incrustar credenciales en imágenes.
- Evaluar escalado y operación mediante métricas, comprobaciones y evidencias reproducibles.
Este curso sigue el recorrido de un modelo de machine learning desde un entorno reproducible de desarrollo hasta un servicio distribuido en Kubernetes. El escenario común será una API de predicción que clasifica solicitudes de soporte como urgentes o normales. No se trata solo de empaquetar código: cada módulo obliga a decidir qué pertenece a la imagen, qué debe permanecer fuera de ella, cómo se valida una entrada y cómo se observa el comportamiento del servicio.
En el primer módulo resolverás el problema de dependencias mediante imágenes Docker. Compararás un entorno local con una imagen que fija el intérprete, las bibliotecas y el comando de arranque. Después revisarás la instalación, distinguirás cliente, demonio, imagen y contenedor, y construirás un Dockerfile pequeño para Python. La práctica de preprocesamiento conectará un archivo de entrada con un resultado montado en un volumen, dejando explícito qué datos son efímeros y cuáles persisten. La evaluación comprobará decisiones, no solo definiciones.
El segundo módulo organiza un proyecto ML para que pueda construirse y probarse sin rutas absolutas ni estados ocultos. Separarás código, configuración, datos de ejemplo y artefactos. Luego crearás una imagen que contenga un modelo entrenado, cargarás ese modelo una sola vez y expondrás una API REST con validación de forma, errores comprensibles y registros en la salida estándar. La práctica integrará preprocesamiento, inferencia y respuesta HTTP en un flujo completo. El objetivo será reproducir una predicción a partir de la misma entrada, no prometer una métrica que no se haya calculado con datos disponibles.
El tercer módulo introduce Kubernetes como un sistema declarativo. Identificarás plano de control, nodos, Pods, Deployments y Services, y usarás Minikube únicamente en un laboratorio local autorizado. Desplegarás una imagen, comprobarás sus estados y observarás la diferencia entre la identidad cambiante de un Pod y el punto de acceso estable de un Service. Después configurarás varias réplicas con solicitudes, límites y sondas de salud. Las comprobaciones incluirán número de réplicas disponibles, correspondencia entre selectores y etiquetas, y comportamiento durante una actualización.
El cuarto módulo aborda operación controlada. Un ConfigMap alojará parámetros no sensibles, como un umbral de clasificación; un Secret representará una credencial de laboratorio y no se incorporará a la imagen. Estudiarás el tamaño limitado de estos objetos y cuándo conviene un archivo o almacenamiento externo. Después relacionarás demanda, uso de CPU y réplicas, recordando que un autoescalador no corrige un modelo lento ni una métrica mal elegida. El monitoreo se centrará en latencia, errores, volumen y distribución de predicciones, con datos de ejemplo verificables.
El proyecto integrador reunirá entrenamiento reproducible, artefacto versionado, servicio de inferencia, manifiestos, configuración separada, comprobaciones y un procedimiento de actualización. Cada decisión deberá quedar respaldada por una evidencia: una salida de comando, una respuesta JSON, un conteo de Pods o un cálculo explícito. La revisión final comprobará que el sistema puede reconstruirse, que una entrada inválida no se convierte silenciosamente en predicción y que el despliegue puede inspeccionarse y revertirse en el laboratorio. La documentación oficial de introducción a Docker entregada con el curso sirve como referencia conceptual; las actividades se limitan a lo que puede verificarse en el entorno de trabajo.
La ampliación incluye fixtures completos y diferencia cálculo teórico de observación del controlador. El proyecto inicial usa una regla/artefacto JSON preparado para comprobar infraestructura y contrato; el clasificador entrenado se presenta aparte con su dataset propio, pipeline y entorno compatible. La probabilidad de una clase no garantiza calibración. Conserva digest de imagen, checksum real del artefacto y evidencia observada de disponibilidad.
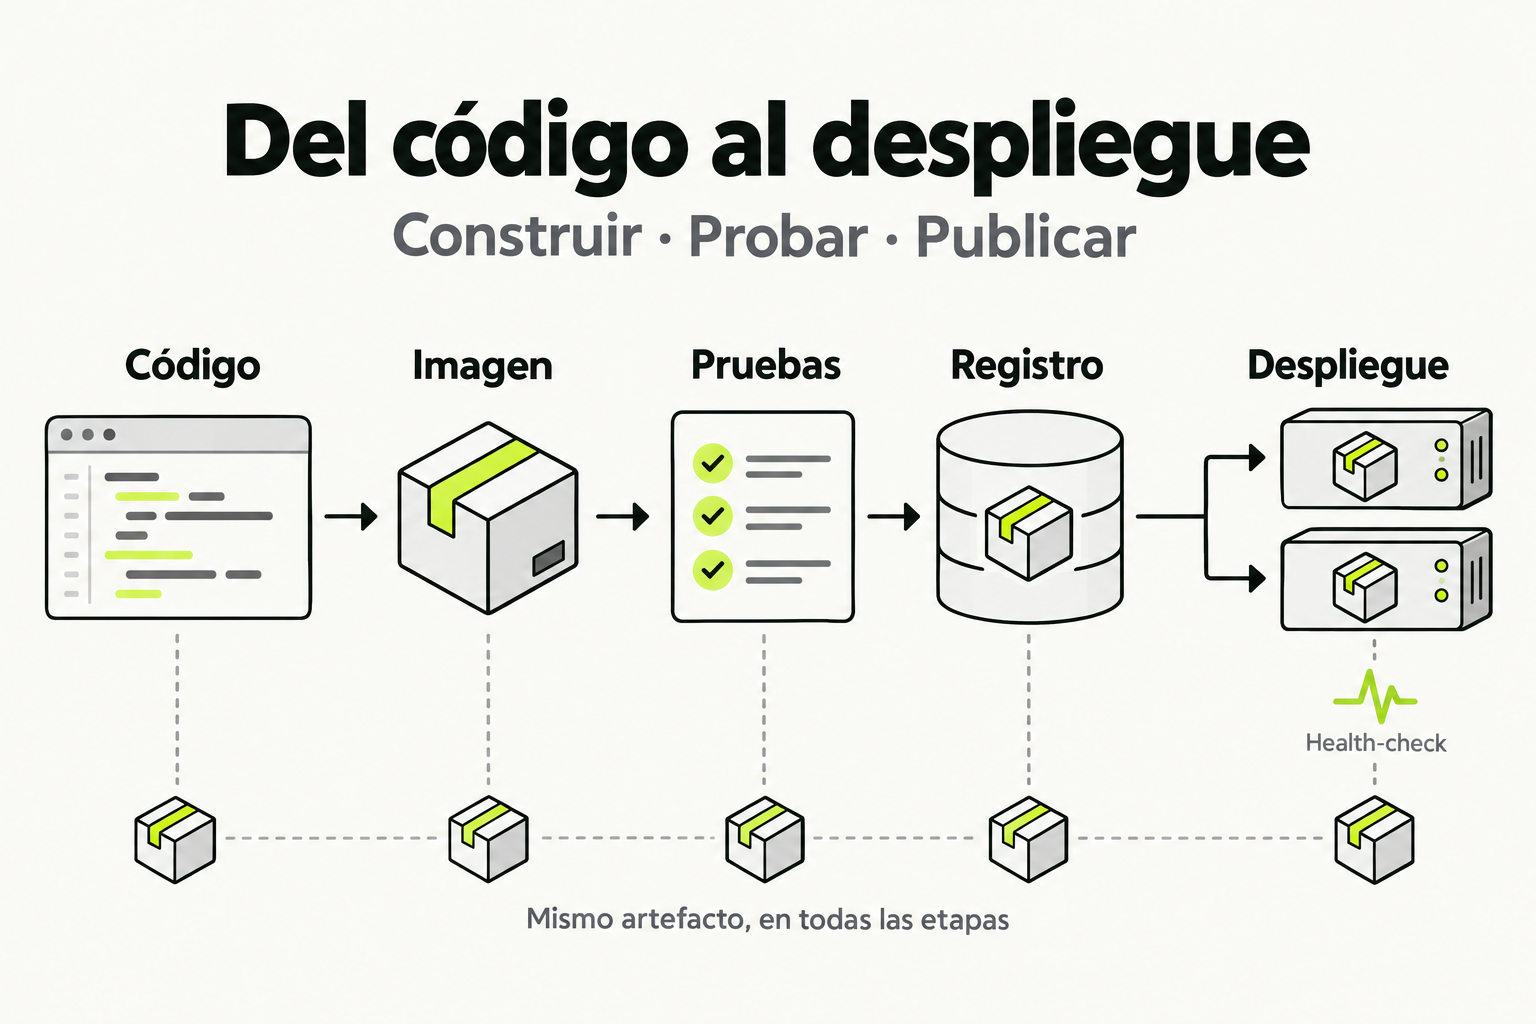
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Proyecto final
Servicio reproducible de clasificación desplegado localmente
Construye un servicio que reciba registros de solicitudes de soporte, aplique el mismo preprocesamiento usado durante el entrenamiento y devuelva una clase y una confianza. Empaqueta entrenamiento e inferencia en imágenes separadas o claramente diferenciadas, despliega la inferencia en Kubernetes y externaliza un umbral no sensible mediante configuración.
Qué entregar
- Estructura de proyecto con código, dependencias, datos mínimos reproducibles y artefacto de modelo.
- Dockerfile o Dockerfiles, instrucciones de construcción y comprobaciones de ejecución.
- API de predicción con ejemplos válidos e inválidos y respuestas documentadas.
- Manifiestos de Deployment, Service, ConfigMap y, si corresponde, Secret de laboratorio.
- Registro de evidencias: salidas de construcción, estado de Pods, prueba de servicio y cálculo de una métrica operativa.
Cómo comprobarlo
- La misma entrada produce una respuesta reproducible tras reconstruir la imagen.
- La imagen no contiene credenciales ni depende de rutas absolutas del equipo anfitrión.
- La API valida estructura y tipos, devuelve errores apropiados y carga el modelo una sola vez.
- El Deployment alcanza el número solicitado de réplicas y el Service selecciona los Pods correctos.
- La configuración sensible y no sensible está separada y el informe distingue hechos medidos de supuestos.
Fuentes para profundizar
- Dockerfile ↗
- Docker: volúmenes ↗
- Kubernetes: EndpointSlices ↗
- Kubernetes: sondas ↗
- Kubernetes: HPA ↗
- Kubernetes: persistencia ↗
- Kubernetes: Jobs ↗
- kind: laboratorio ↗
- Minikube: imágenes ↗
- Helm: plantillas ↗
- Prometheus: configuración ↗
- Scikit-learn: persistencia ↗
- Scikit-learn: DecisionTreeClassifier ↗
- Flask: referencia ↗
- GitHub: artifacts ↗
- ConfigMaps ↗
- Secrets ↗
- pandas Copy-on-Write ↗
- RMSE actual ↗
- Flask cambios ↗
Temario completo
25 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos de Docker para Científicos de Datos
- Containerización: La solución a problemas de dependencias en ML
- Instalación y configuración de Docker en tu entorno
- Creación de tu primer Dockerfile para Python y librerías de datos
- Práctica: Containeriza un script de preprocesamiento de datos
- Evaluación de conceptos Docker para ML
Dockerizando Pipelines Completos de Machine Learning
- Estructura de proyectos ML para containerización eficiente
- Creación de imágenes Docker con modelos entrenados
- Exponiendo modelos como APIs REST en contenedores
- Práctica: Containeriza un pipeline completo de clasificación
- Quiz: Dockerización de flujos ML
Introducción a Kubernetes para Despliegue de Modelos
- Arquitectura de Kubernetes: Por qué es ideal para ML en producción
- Configuración de Minikube para desarrollo local
- Desplegando tu primer contenedor ML en Kubernetes
- Práctica: Despliega un servicio de predicción con múltiples réplicas
- Evaluación de conceptos Kubernetes básicos
Gestión Avanzada y Escalado de Modelos en Kubernetes
- ConfigMaps y Secrets: Gestión de parámetros de modelos
- Autoescalado horizontal de pods para picos de demanda
- Monitoreo de métricas de modelos desplegados
- Práctica: Configura autoescalado para un modelo de recomendación
- Quiz: Gestión avanzada en Kubernetes
Proyecto Integrador: Pipeline ML de Extremo a Extremo
- Diseño del pipeline: Desde datos hasta predicciones en producción
- Containerización del entrenamiento y servicio de predicción
- Despliegue en Kubernetes con CI/CD básico
- Implementación del proyecto completo
- Evaluación final del proyecto integrador
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Containerización y Despliegue de Modelos ML con Docker y Kubernetes?
Puedes adquirir el curso Containerización y Despliegue de Modelos ML con Docker y Kubernetes con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Containerización y Despliegue de Modelos ML con Docker y Kubernetes?
Es un curso completo en español con 5 módulos y 25 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Containerización y Despliegue de Modelos ML con Docker y Kubernetes?
Revisa el temario público para comprobar el punto de partida y la progresión de Containerización y Despliegue de Modelos ML con Docker y Kubernetes. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Containerización y Despliegue de Modelos ML con Docker y Kubernetes entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Qué formato tiene el curso?
El formato actual es lectura y práctica. Consulta las lecciones y sus recursos; no se ofrece como un curso completo de video.
¿Puedo revisar el programa antes de pagar?
Sí. El temario y esta ficha son públicos. Compara el contenido y los requisitos con tu objetivo antes de elegir una compra individual o un acceso a toda la escuela en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Otros cursos de IA
Ver todo el catálogo →- Containerización y Despliegue de Modelos de ML con Docker y KubernetesAprende a containerizar tus flujos de Machine Learning con Docker y desplegarlos en Kubernetes para producción. Este curso práctico te guiará desde la creación de imágenes personalizadas hasta la orquestación de servicios escalables, optimizado para científicos de datos.
- Docker para DesarrolladoresDomina Docker para optimizar tu flujo de desarrollo, crear entornos reproducibles y desplegar aplicaciones como un profesional. Aprende a containerizar aplicaciones, gestionar múltiples contenedores y aplicar mejores prácticas de la industria.
- Accesibilidad Web (WCAG)Aprende a crear sitios web accesibles para todas las personas. Estándares WCAG 2.2, herramientas de auditoría, HTML semántico, ARIA, contraste de colores y navegación por teclado.
- Arquitectura de Micro-frontends con Module Federation de WebpackEste curso avanzado te guiará en el diseño e implementación de arquitecturas de micro-frontends utilizando Module Federation de Webpack. Aprenderás a desplegar aplicaciones frontend distribuidas entre equipos, optimizando la colaboración y escalabilidad. Cada módulo incluye ejercicios prácticos para construir componentes.