

Lección 16 de 20 · Lectura y práctica
Diseñar una Arquitectura Multi-AZ con Alta Disponibilidad
Concepto claveDiseñar una arquitectura Multi-AZ (Multi-Availability Zone) con alta disponibilidad en AWS significa distribuir tus recursos de infraestructura en al menos dos zonas de disponibilidad diferentes dentro de una.
Del concepto a la práctica
Taller de esta lección
Multi-AZ no significa duplicar nombres, sino colocar componentes equivalentes en zonas distintas y evitar un punto único de fallo. Para la plataforma de reservas, usa dos subredes públicas para el balanceador y dos privadas para aplicación, distribuidas en zonas a y b. La base de datos debe seguir una estrategia de disponibilidad compatible con el alcance del laboratorio.
Ejemplo resuelto
La matriz es: pública-a/AZ-a, pública-b/AZ-b, privada-a/AZ-a y privada-b/AZ-b. El balanceador usa las públicas; las instancias usan las privadas. Si una zona falla, aún existe capacidad en la otra, siempre que el grupo y las rutas estén configurados.
Pruébalo
Dibuja cuatro subredes con CIDR no solapados.
Coloca cada pareja funcional en zonas diferentes.
Enumera dependencias que seguirían disponibles durante la pérdida de una zona.
Marca cualquier componente que continúe siendo un punto único.
Error frecuente: declarar dos subredes en la misma zona y llamarlo Multi-AZ. Corrección: comprobar el atributo de zona de cada subred.
Ejercicio: completa una tabla de fallo de zona a y zona b.
Comprueba tu resultado
la zona superviviente conserva una subred privada y una pública; el diseño identifica explícitamente qué componente no está replicado.
Disponibilidad medida por dependencias
En la tabla de fallos, perder AZ-a deja operativas publica-b/privada-b; no conserva físicamente una subred de cada tipo en la AZ perdida. Perder b deja a. Esta cuenta solo indica rutas y capacidad diseñadas: alcanzar la app requiere destinos sanos, distribución de instancias, capacidad suficiente y dependencias sobrevivientes.
El despliegue RDS Multi-AZ de instancia con un standby es disponibilidad/failover; ese standby no sirve tráfico de lectura como una read replica. Otros tipos de clúster Multi-AZ tienen otro contrato y no se deducen solo de multi_az=true en aws_db_instance. El failover puede producir pausa y reconexión; Multi-AZ no garantiza cero interrupciones. Un solo NAT en a puede cortar salida de recursos b si a falla, según rutas; define la estrategia y coste en vez de asumir que dos subredes resuelven cada dependencia.
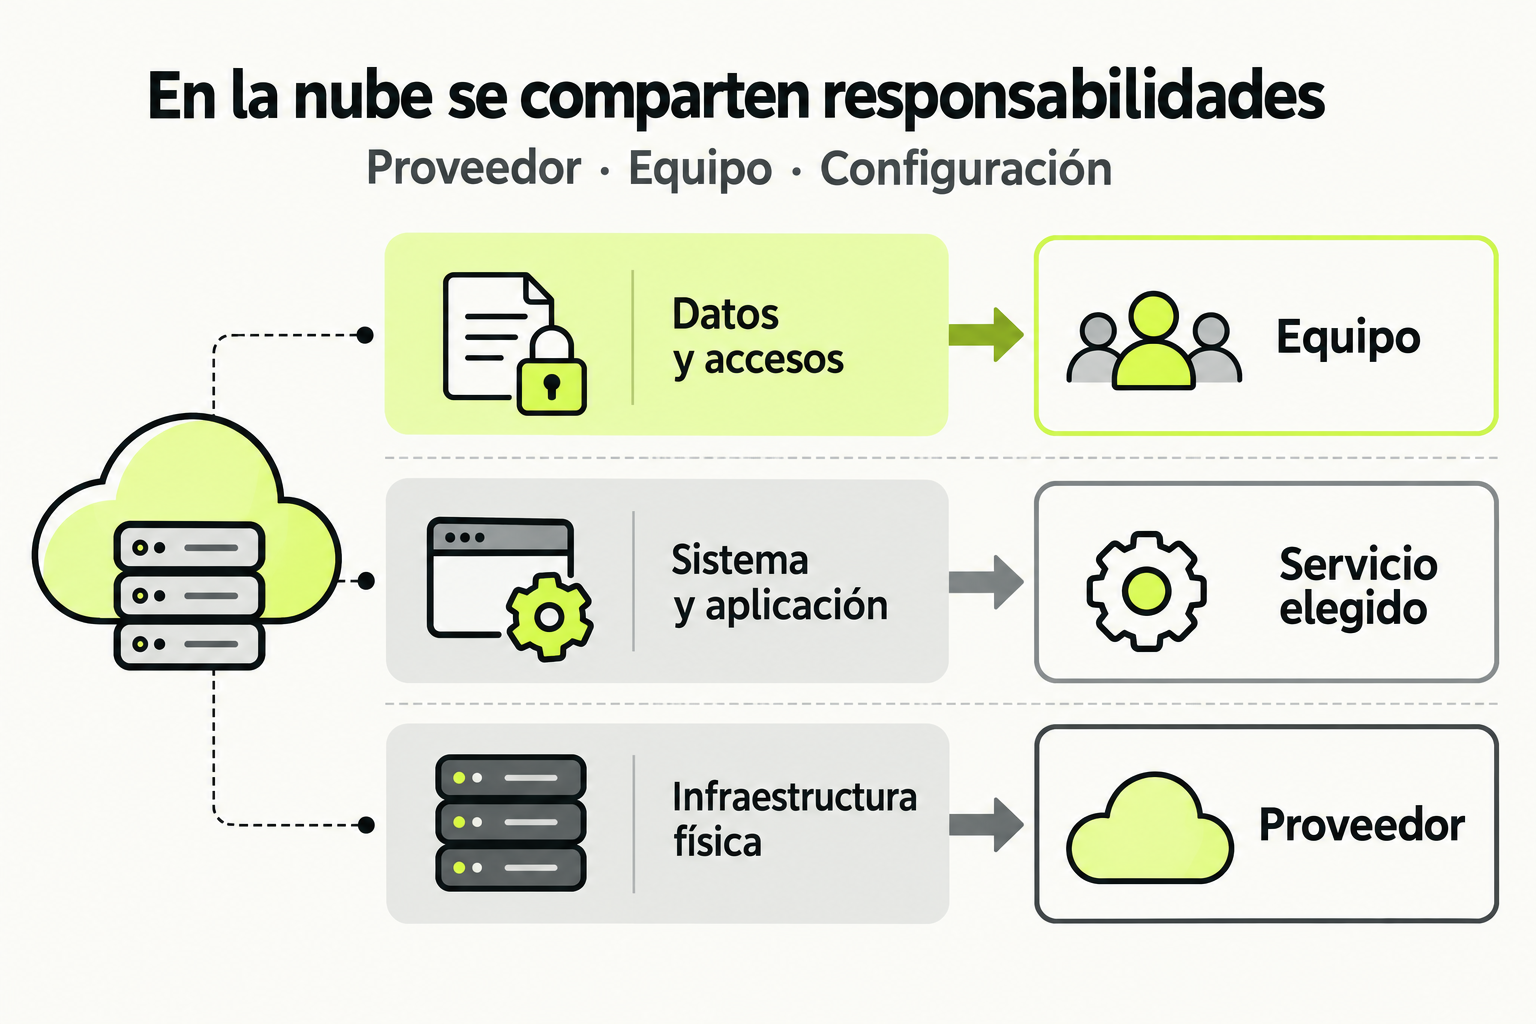
La app no guarda sesiones o archivos únicos en el disco de una instancia efímera si otras deben servirlas. Documenta respaldo/restauración y límites de pérdida/tiempo, además de replicación. En el diagrama de nube, AWS opera capas del servicio y el equipo conserva decisiones de configuración/datos/permisos; crear dos zonas no transfiere toda esa responsabilidad. Evalúa fallo lógico con la matriz, sin simular averías en una cuenta real aquí.
 Mapa de práctica
El proveedor opera la infraestructura física y el equipo administra sus datos y accesos. La responsabilidad del sistema y la aplicación cambia según el servicio elegido. Revisa la configuración y el contrato del servicio antes de asumir que una capa está cubierta.
Ver la infografía en tamaño completo ↗Concepto clave
Diseñar una arquitectura Multi-AZ (Multi-Availability Zone) con alta disponibilidad en AWS significa distribuir tus recursos de infraestructura en al menos dos zonas de disponibilidad diferentes dentro de una región. Piensa en esto como tener tu casa principal y una casa de respaldo en otro barrio de la misma ciudad: si hay un problema en un barrio (como un corte de luz), puedes seguir operando desde el otro sin interrupciones.
En el contexto de DevOps, esto se traduce en crear infraestructura que sea resiliente a fallos de un solo punto. No se trata solo de tener servidores duplicados, sino de asegurar que todos los componentes críticos (como bases de datos, balanceadores de carga y almacenamiento) estén replicados. La analogía real seria un hospital con generadores de emergencia en diferentes edificios: si falla uno, el otro mantiene las operaciones vitales.
Cómo funciona en la práctica
Vamos a desplegar una arquitectura básica Multi-AZ para una aplicación web. El flujo paso a paso es:
- Definir una VPC (Virtual Private Cloud) con subredes públicas y privadas en al menos dos AZs (por ejemplo, us-east-1a y us-east-1b).
- Crear un balanceador de carga (ALB) que distribuya el tráfico entre instancias EC2 en diferentes AZs.
- Configurar un grupo de Auto Scaling que lance instancias EC2 en múltiples AZs para manejar la carga y reemplazar instancias fallidas.
- Implementar una base de datos RDS con replicación Multi-AZ para asegurar la disponibilidad de los datos.
Antes de Terraform, esto se hacia manualmente en la consola de AWS, lo que era propenso a errores y dificil de replicar. Con Terraform, defines todo como codigo, lo que permite versionar, probar y desplegar de manera consistente.
Codigo en accion
Aquí tienes un ejemplo funcional de un archivo Terraform que define una VPC con subredes Multi-AZ:
# main.tf - Configuración de VPC y subredes Multi-AZ
provider "aws" {
  region = "us-east-1"
}

resource "aws_vpc" "main" {
  cidr_block = "10.0.0.0/16"
  enable_dns_support = true
  enable_dns_hostnames = true
  tags = {
    Name = "vpc-multi-az"
  }
}

resource "aws_subnet" "public_az_a" {
  vpc_id            = aws_vpc.main.id
  cidr_block        = "10.0.1.0/24"
  availability_zone = "us-east-1a"
  map_public_ip_on_launch = true
  tags = {
    Name = "public-subnet-az-a"
  }
}

resource "aws_subnet" "public_az_b" {
  vpc_id            = aws_vpc.main.id
  cidr_block        = "10.0.2.0/24"
  availability_zone = "us-east-1b"
  map_public_ip_on_launch = true
  tags = {
    Name = "public-subnet-az-b"
  }
}

resource "aws_subnet" "private_az_a" {
  vpc_id            = aws_vpc.main.id
  cidr_block        = "10.0.3.0/24"
  availability_zone = "us-east-1a"
  tags = {
    Name = "private-subnet-az-a"
  }
}

resource "aws_subnet" "private_az_b" {
  vpc_id            = aws_vpc.main.id
  cidr_block        = "10.0.4.0/24"
  availability_zone = "us-east-1b"
  tags = {
    Name = "private-subnet-az-b"
  }
}
Ahora, mejoremos esto refactorizando para usar count y así evitar duplicación de codigo. Antes, teniamos bloques separados para cada subnet; despues, podemos hacerlo mas escalable:
# Refactorizado usando count para subredes
locals {
  azs = ["us-east-1a", "us-east-1b"]
  public_cidrs  = ["10.0.1.0/24", "10.0.2.0/24"]
  private_cidrs = ["10.0.3.0/24", "10.0.4.0/24"]
}

resource "aws_subnet" "public" {
  count = length(local.azs)
  vpc_id            = aws_vpc.main.id
  cidr_block        = local.public_cidrs[count.index]
  availability_zone = local.azs[count.index]
  map_public_ip_on_launch = true
  tags = {
    Name = "public-subnet-${local.azs[count.index]}"
  }
}

resource "aws_subnet" "private" {
  count = length(local.azs)
  vpc_id            = aws_vpc.main.id
  cidr_block        = local.private_cidrs[count.index]
  availability_zone = local.azs[count.index]
  tags = {
    Name = "private-subnet-${local.azs[count.index]}"
  }
}
Errores comunes
- No configurar correctamente las rutas en las tablas de enrutamiento: Si las subredes privadas no tienen una ruta a un NAT Gateway o Internet Gateway, las instancias no podran acceder a internet para actualizaciones. Solucion: Asegurate de asociar las tablas de enrutamiento adecuadas a cada subnet.
- Usar la misma AZ para todos los recursos: Esto anula el proposito de Multi-AZ. Solucion: Siempre especifica al menos dos AZs diferentes en tus configuraciones, como se muestra en el codigo de ejemplo.
- Olvidar habilitar la replicacion Multi-AZ en RDS: Sin esto, tu base de datos sera un punto unico de fallo. Solucion: Configura
multi_az = trueen el recursoaws_db_instance. - No probar la conmutacion por error: Desplegar sin probar que la arquitectura funcione en caso de fallo. Solucion: Realiza pruebas regulares simulando fallos en una AZ para verificar la resiliencia.
Checklist de dominio
- He definido una VPC con al menos dos subredes publicas y dos privadas en diferentes AZs.
- He configurado un balanceador de carga (ALB) que distribuye trafico entre instancias en multiples AZs.
- He implementado un grupo de Auto Scaling con instancias EC2 desplegadas en al menos dos AZs.
- He desplegado una base de datos RDS con replicacion Multi-AZ habilitada.
- He probado la conmutacion por error simulando un fallo en una AZ.
- He versionado mi codigo Terraform en un repositorio Git.
- He documentado la arquitectura y los procedimientos de recuperacion ante desastres.
Desplegar una Aplicacion Web Multi-AZ con Terraform en AWS
En este ejercicio, vas a crear una infraestructura completa para una aplicacion web con alta disponibilidad usando Terraform. Sigue estos pasos:
- Preparacion: Asegurate de tener Terraform instalado y configuradas las credenciales de AWS en tu entorno.
- Crear archivos de configuracion: Crea un directorio para el proyecto y dentro, archivos
main.tf,variables.tf, youtputs.tf. - Definir la VPC y subredes: En
main.tf, usa el codigo refactorizado de la leccion para crear una VPC con subredes publicas y privadas en dos AZs (por ejemplo, us-east-1a y us-east-1b). - Agregar un balanceador de carga: Añade un recurso
aws_lbque apunte a las subredes publicas. Configura un listener para HTTP en el puerto 80. - Configurar Auto Scaling: Crea un lanzamiento (launch template) para instancias EC2 con una AMI de Amazon Linux y un script de user-data que instale un servidor web basico. Luego, define un grupo de Auto Scaling que use este lanzamiento y se despliegue en las subredes privadas.
- Desplegar y probar: Ejecuta
terraform init,terraform planpara revisar, yterraform applypara desplegar. Una vez desplegado, accede a la URL del balanceador de carga en tu navegador para verificar que la aplicacion este funcionando. - Limpiar: Despues de probar, ejecuta
terraform destroypara eliminar los recursos y evitar costos innecesarios.
Pistas
- Usa el modulo oficial de AWS VPC de Terraform Registry para simplificar la creacion de VPC y subredes.
- Para el script de user-data en EC2, considera usar un simple comando como 'yum install -y httpd && systemctl start httpd' para Apache.
- Asegurate de que las reglas de seguridad en los security groups permitan el trafico HTTP (puerto 80) desde el balanceador de carga a las instancias EC2.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Terraform en AWS: Infraestructura como Código para DevOps
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.