

Lección 13 de 19 · Lectura y práctica
Quiz: Técnicas de Optimización
Tipo de lección: QuizConcepto claveEn sistemas de baja latencia, cada microsegundo cuenta. La optimización en Rust va más allá de escribir código eficiente; se trata de comprender cómo interactúan el hardware, el sistema.
Del concepto a la práctica
Taller de esta lección
Optimizar con rigor significa preservar la salida, medir una línea base y explicar el coste; una menor media no compensa errores funcionales ni una cola de latencia peor sin documentarlo.
Ejemplo resuelto
Una función tarda 50 microsegundos en promedio y 90 en p99. Tras un cambio tarda 45 y 140. La media mejora 10%, pero el p99 empeora 50 microsegundos, por lo que no es automáticamente mejor.
Pruébalo
Calcula la diferencia absoluta de cada métrica.
Calcula el cambio relativo solo para la media.
Decide según el requisito del sistema, no según una cifra aislada.
Comprueba tu resultado
La media baja 5 microsegundos, un 10%; el p99 sube de 90 a 140, 50 microsegundos.
Error frecuente: llamar “50% más lento” a una subida de 50 microsegundos sin indicar base; corrección: escribe unidades y denominador.
Ejercicio: evalúa una alternativa de media 48 y p99 88. Resultado esperado: mejora ambos indicadores frente a la línea base y merece una revisión funcional.
El incremento relativo de p99 es 50/90=55,56%, además de +50 microsegundos. Define el gate antes: si p99 debe ser <=100, la versión45/140 falla y48/88 supera ese requisito, pendiente aún de pruebas funcionales. Para obtener p99 de muestras usa un método escrito y suficiente población; no confíes en un percentil ficticio de tres peticiones.
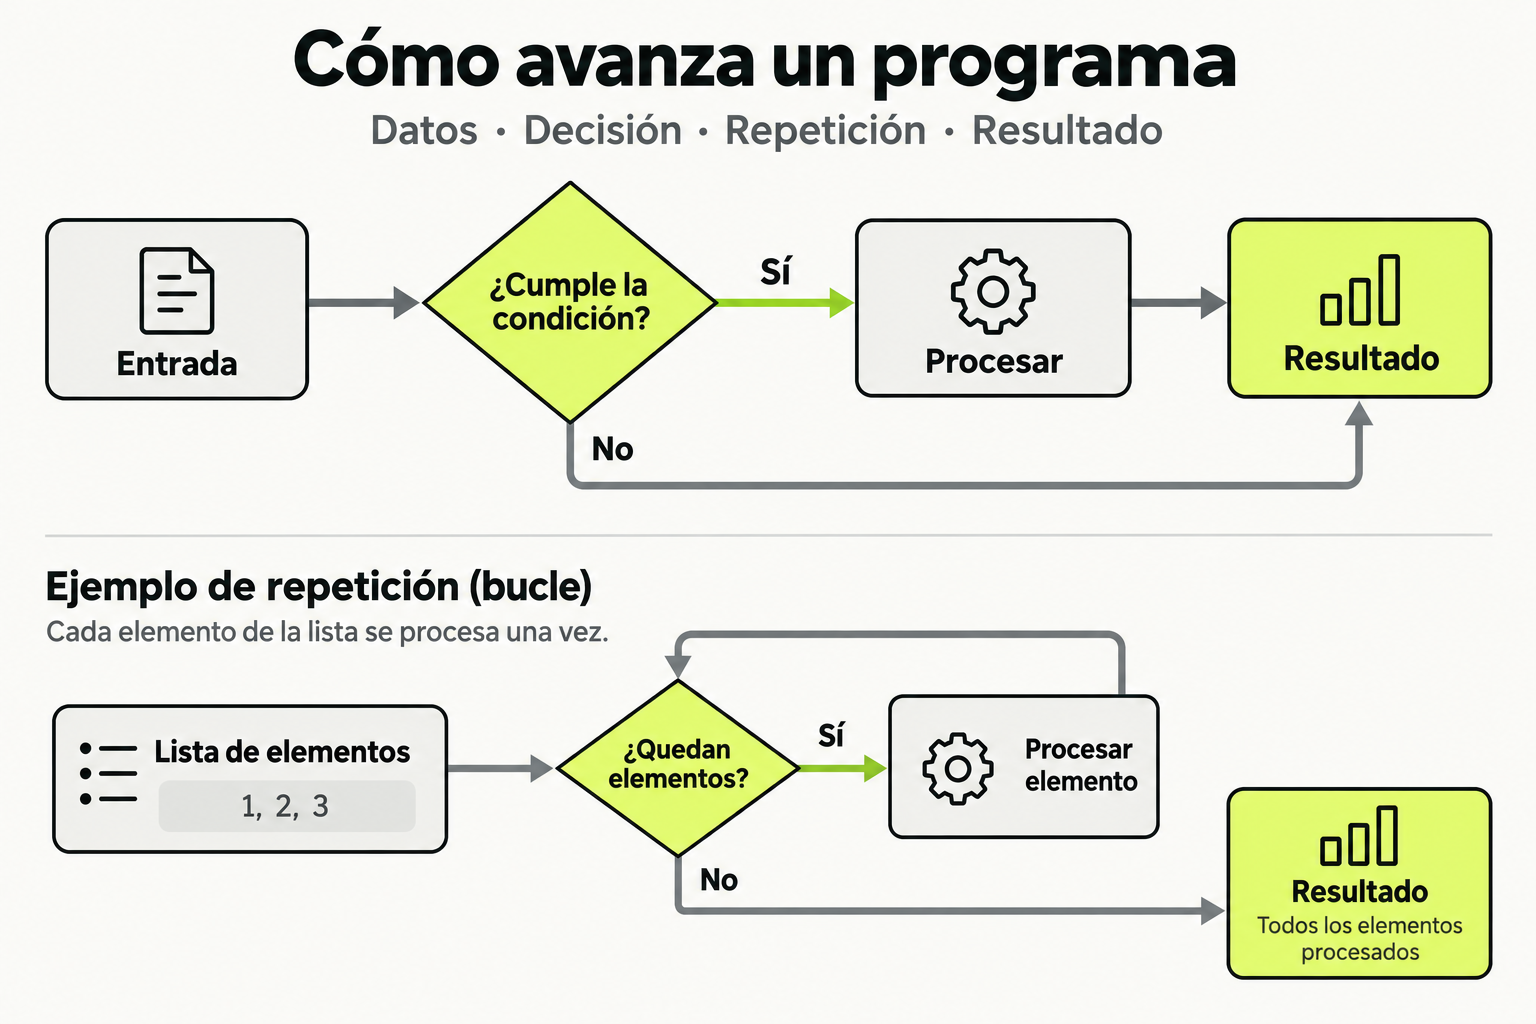
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Quiz
Concepto clave
En sistemas de baja latencia, cada microsegundo cuenta. La optimización en Rust va más allá de escribir código eficiente; se trata de comprender cómo interactúan el hardware, el sistema operativo y el compilador. Piensa en un corredor de Fórmula 1: no solo necesita un motor potente, sino también una aerodinámica precisa, neumáticos adecuados y una estrategia de pit stops impecable. En Rust, esto se traduce en gestionar la memoria de forma predecible, minimizar las pausas del recolector de basura (que Rust evita por diseño) y reducir el overhead de las abstracciones.
La predictibilidad es tan crucial como la velocidad bruta. Un sistema que responde en 1 ms el 99% del tiempo, pero en 100 ms el 1% restante, puede ser inaceptable para aplicaciones financieras o de telecomunicaciones. Rust ofrece herramientas como ownership y borrowing para controlar la memoria sin garbage collection, pero dominar técnicas como el uso de arenas de memoria, cache alignment y SIMD requiere una comprensión profunda.
Cómo funciona en la práctica
Imagina que estás optimizando un sistema de procesamiento de transacciones financieras. El objetivo es reducir la latencia de 50 microsegundos a 20 microsegundos por operación. Sigue estos pasos:
- Perfilación inicial: Usa herramientas como
perfoflamegraphpara identificar cuellos de botella. Por ejemplo, podrías descubrir que el 40% del tiempo se gasta en asignaciones de memoria dinámica. - Reducción de allocaciones: Reemplaza
Vec::new()conVec::with_capacity()para reservar memoria por adelantado. UsaBoxo referencias en lugar de clones innecesarios. - Optimización de estructuras de datos: Asegúrate de que las estructuras críticas estén alineadas en caché. Por ejemplo, en una CPU con líneas de caché de 64 bytes, usa
#[repr(align(64))]para estructuras frecuentemente accedidas. - Paralelismo controlado: Implementa
rayonpara procesamiento paralelo, pero mide el overhead de creación de hilos. En algunos casos, un bucle simple puede ser más rápido debido a la predictibilidad.
Caso de estudio
Una empresa de trading de alta frecuencia migró su núcleo de C++ a Rust para un sistema de matching de órdenes. El desafío era mantener latencias por debajo de 5 microsegundos durante picos de mercado. Implementaron:
- Arenas de memoria personalizadas: En lugar de usar el allocator global, crearon un allocator específico que reutiliza bloques de memoria para objetos de vida corta, reduciendo la fragmentación y el tiempo de allocación en un 60%.
- SIMD para cálculos de precios: Usaron la crate
packed_simdpara procesar 8 operaciones de punto flotante simultáneamente en operaciones de pricing, logrando una mejora del 3x en throughput. - Evitar syscalls en rutas críticas: Reemplazaron logging síncrono con un buffer en memoria que se vacía asíncronamente, eliminando pausas impredecibles.
Resultado: Latencia promedio reducida de 4.8 a 2.1 microsegundos, con un p99 (percentil 99) de 3.5 microsegundos, cumpliendo los requisitos de mercado.
Errores comunes
- Optimizar prematuramente sin profiling: Asumir que un cambio mejorará el performance sin datos. Solución: Siempre mide antes y después con herramientas como
criterion. - Ignorar el costo de las abstracciones seguras: Usar
Arc<Mutex<T>>en rutas críticas puede introducir overhead de locking innecesario. Solución: ConsideraRwLocko estructuras lock-free para acceso concurrente de lectura. - No alinear datos a la caché: Estructuras mal alineadas causan cache misses, aumentando la latencia. Solución: Usa
#[repr(C)]o#[repr(align(n))]para controlar el layout. - Sobrecargar el sistema con hilos: Crear más hilos que núcleos de CPU puede llevar a contention y overhead de scheduling. Solución: Usa pools de hilos estáticos y ajusta basado en benchmarks.
- Descuidar el impacto del compilador: No usar flags de optimización como
-C target-cpu=nativepuede dejar performance en la mesa. Solución: Configura perfiles de release agresivos enCargo.toml.
Checklist de dominio
- Puedo explicar la diferencia entre latencia promedio y latencia p99, y por qué esta última es crítica en sistemas financieros.
- He usado
perfo herramientas similares para identificar al menos un cuello de botella en un proyecto Rust real. - Sé implementar un allocator personalizado para reducir allocaciones en rutas críticas.
- Puedo escribir código que utilice SIMD para acelerar operaciones numéricas.
- He optimizado una estructura de datos para alineación en caché y medido la mejora.
- Comprendo cuándo usar concurrencia lock-free versus locking tradicional en contextos de baja latencia.
- Puedo configurar un perfil de release en Cargo para maximizar optimizaciones sin sacrificar debugabilidad.
Optimización de un procesador de mensajes en tiempo real
Implementa un sistema en Rust que procese mensajes de un stream en tiempo real, optimizando para baja latencia. Sigue estos pasos:
- Crea una estructura
MessageProcessorque tenga un buffer circular fijo para almacenar hasta 1024 mensajes. Usa un array en stack ([Message; 1024]) para evitar allocaciones dinámicas. - Define un tipo
Messagecon campos:id: u64,timestamp: u64,data: [u8; 32]. Añade#[repr(align(64))]para alineación en caché. - Implementa un método
process_batch(&mut self, messages: &[Message])que copie los mensajes al buffer y ejecute una operación de checksum (suma XOR de todos los bytes endata) sobre ellos. Usa un bucle que pueda ser vectorizado por el compilador. - Añade soporte para procesamiento paralelo usando
rayonen batches grandes (ej., más de 100 mensajes), pero mantén el procesamiento secuencial para batches pequeños para minimizar overhead. - Escribe un benchmark con
criterionque mida la latencia de procesar 1, 10, y 100 mensajes, comparando con una versión naive que useVecy clones.
Pistas
- Considera usar
MaybeUninitpara manejar el buffer circular de forma segura sin inicialización innecesaria. - Para la operación de checksum, explora el uso de iteradores y
foldpara permitir optimizaciones del compilador. - En el benchmark, asegúrate de calentar el cache y medir múltiples iteraciones para obtener resultados estables.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Rust para Sistemas de Baja Latencia y Alta Seguridad
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.