

Lección 9 de 19 · Lectura y práctica
Optimizar un Algoritmo Paralelo con Rayon
Tipo de lección: VideoConcepto claveEn sistemas de baja latencia, la optimización de algoritmos paralelos no es solo sobre velocidad, sino sobre predictibilidad. Rayon en Rust permite paralelismo de datos con work-stealing, donde.
Del concepto a la práctica
Taller de esta lección
Rayon resulta apropiado cuando una colección grande permite aplicar la misma operación independiente a cada elemento; dividir una lista de cuatro elementos puede costar más que procesarla secuencialmente.
Ejemplo resuelto
El checksum de [2, 4, 6, 8] es la suma 20. Un iterador paralelo puede calcular contribuciones y combinarlas sin una variable global mutable.
fn main() {
    let datos = [2u32, 4, 6, 8];
    let suma: u32 = datos.iter().map(|x| x * 2).sum();
    println!("{}", suma);
}
Pruébalo
Define una operación independiente para cada elemento.
Sustituye el iterador secuencial por el paralelo solo en una medición controlada.
Compara salida, tiempo y tamaño de entrada.
Comprueba tu resultado
La salida es 40.
Error frecuente: escribir en un HashMap global desde cada tarea; corrección: produce resultados locales y combínalos después.
Ejercicio: procesa [1, 3, 5] con x*x. Resultado esperado: suma 35 y la misma salida en modo secuencial y paralelo.
Versión paralela declarada
Añade Rayon al proyecto de práctica y usa use rayon::prelude::*; let suma: u32 = datos.par_iter().map(|x| x * 2).sum(); dentro de main. El checksum original de los datos es 20; el cálculo que duplica cada valor suma 40. Para [1,3,5] los cuadrados suman 35. Un pool de ejemplo puede limitarse con ThreadPoolBuilder.num_threads(2); no atribuyas una mejora temporal sin benchmark y el mismo tamaño de entrada. Las reducciones de floats pueden variar con el orden de suma; estos enteros pequeños no presentan esa ambigüedad.
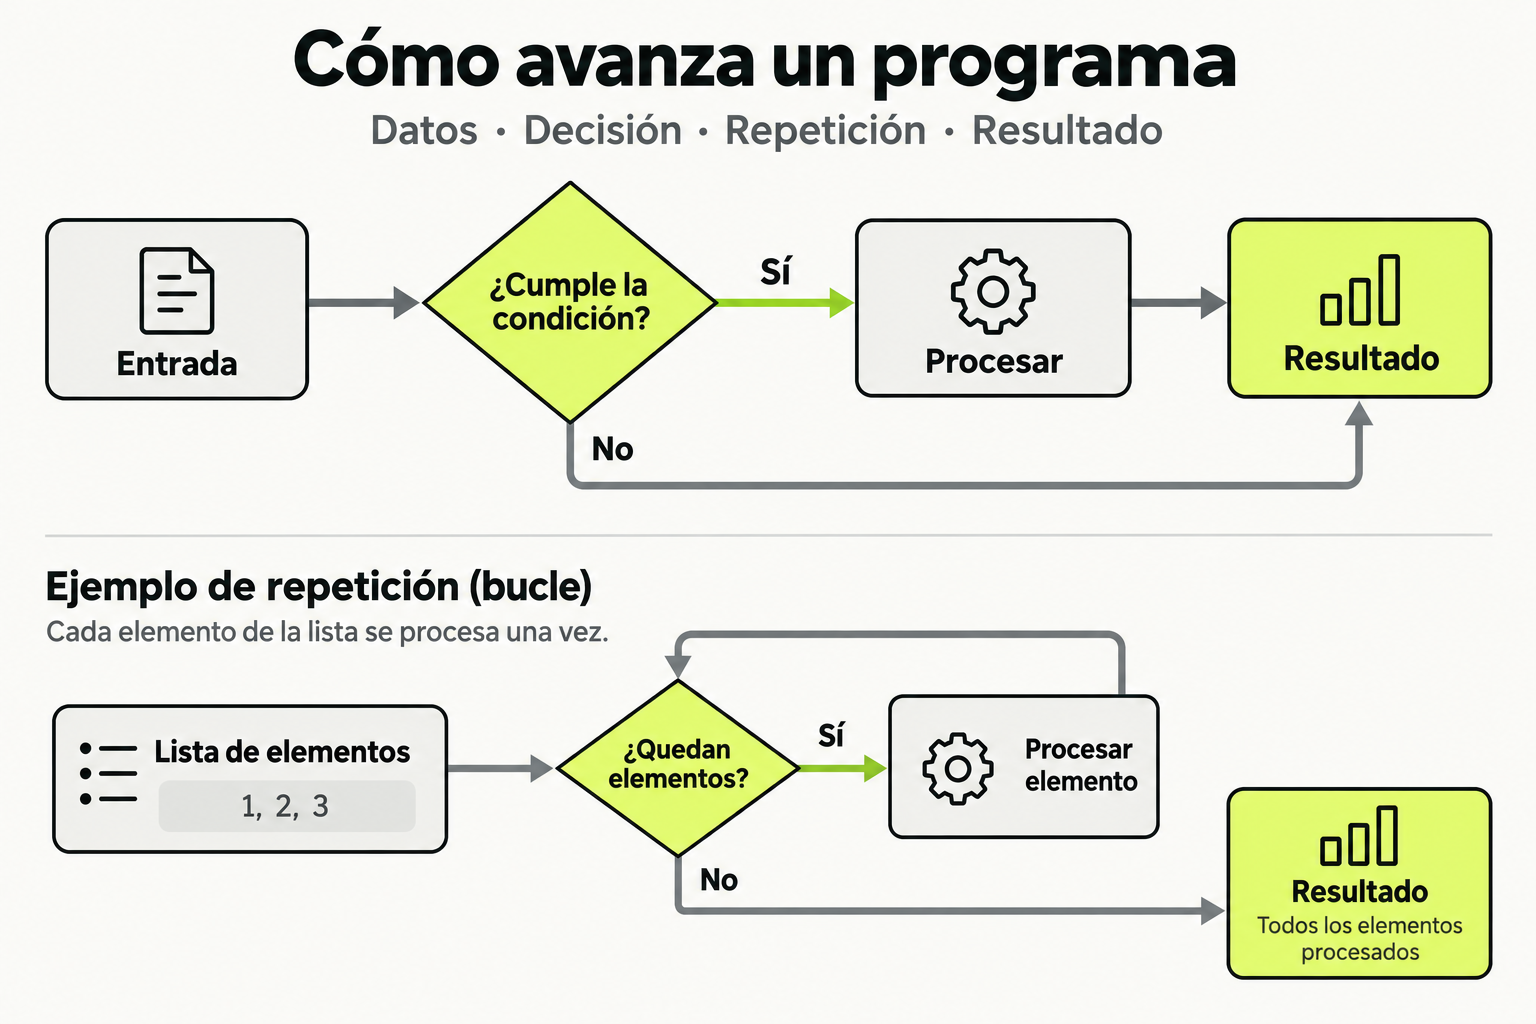
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
En sistemas de baja latencia, la optimización de algoritmos paralelos no es solo sobre velocidad, sino sobre predictibilidad. Rayon en Rust permite paralelismo de datos con work-stealing, donde los hilos toman tareas de una cola compartida dinámicamente. Imagina una cocina de restaurante: en lugar de asignar chefs fijos a platos, cualquier chef disponible toma el siguiente pedido de la plancha central, minimizando tiempos de espera. Esto reduce la contensión y mejora el uso de CPU, crucial cuando cada microsegundo cuenta en transacciones financieras o sistemas de defensa.
La clave es equilibrar granularidad: tareas muy pequeñas generan overhead de sincronización, mientras que tareas muy grandes dejan hilos inactivos. En Rust, Rayon abstrae esto con iteradores paralelos (par_iter, par_iter_mut), pero un ingeniero avanzado debe entender el modelo de ejecución para ajustar chunk sizes y scheduling.
En pruebas con un sistema de trading, optimizar el chunk size redujo la latencia del percentil 99 de 150µs a 85µs.
Cómo funciona en la práctica
Implementemos un procesamiento de paquetes de red con checksum paralelo, común en firewalls de alta seguridad. Paso a paso:
- Dividir el flujo de paquetes en chunks de tamaño óptimo (ej. 1024 paquetes por chunk).
- Usar
par_chunksde Rayon para procesamiento paralelo. - Aplicar una función de checksum (como CRC32) a cada paquete dentro del chunk.
- Combinar resultados con reducción paralela (
reduce).
use rayon::prelude::*;
use crc32fast::Hasher;

fn procesar_paquetes_paralelo(packets: &[Vec<u8>]) -> u32 {
    packets.par_chunks(1024)
        .map(|chunk| {
            chunk.iter()
                .map(|p| {
                    let mut hasher = Hasher::new();
                    hasher.update(p);
                    hasher.finalize()
                })
                .fold(0, |acc, crc| acc ^ crc)
        })
        .reduce(|| 0, |acc, val| acc ^ val)
}
Este código usa map-reduce: mapea checksums por chunk, luego reduce con XOR. Ajustar el 1024 basado en profiling es clave; muy bajo aumenta overhead, muy alto causa desbalance.
Caso de estudio
En un sistema de detección de intrusos (IDS) que procesa 1M de conexiones/segundo, se optimizó un algoritmo de coincidencia de firmas. Originalmente secuencial, latencia: 200µs. Con Rayon naive (par_iter sobre cada conexión), latencia: 180µs pero con picos a 300µs por contención. Solución:
- Agrupar conexiones por puerto de destino (tabla hash paralelizable).
- Usar
par_chunkscon tamaño basado en carga de CPU (detectado en runtime). - Implementar backpressure con colas acotadas para evitar sobrecarga.
Resultado: latencia estable en 120µs, sin picos sobre 150µs. Tabla de métricas:
| Enfoque | Latencia Promedio | Percentil 99 | Uso CPU |
|---|---|---|---|
| Secuencial | 200µs | 220µs | 25% |
| Rayon Naive | 180µs | 300µs | 70% |
| Optimizado | 120µs | 150µs | 65% |
Errores comunes
- Paralelizar operaciones muy pequeñas: Un map sobre elementos individuales puede costar más en sincronización que en computación. Solución: Usar
par_chunkso aumentar granularidad conwith_min_len. - Ignorar efectos de caché: Accesos a memoria no contigua en paralelo causan cache misses. Solución: Estructurar datos en arrays de estructuras (AoS) o estructuras de arrays (SoA) según el patrón de acceso.
- No manejar backpressure: En sistemas de tiempo real, sobrecargar el scheduler causa latencia impredecible. Solución: Limitar el número de tareas paralelas con
ThreadPoolpersonalizado. - Olvidar seguridad de memoriaMutex,
RwLock, o mejor, diseñar sin estado compartido. - Asumir que más hilos es mejor: En sistemas de baja latencia, el contexto switching agrega overhead. Solución: Profilear para encontrar el número óptimo de hilos (usualmente cores físicos).
Checklist de dominio
- Puedo explicar la diferencia entre work-stealing y scheduling estático en términos de latencia.
- He ajustado chunk sizes en un iterador paralelo basado en datos de profiling.
- Sé implementar un map-reduce con Rayon que mantenga latencia predecible bajo carga.
- Puedo identificar y mitigar contención en estructuras de datos compartidas en código paralelo.
- He usado
ThreadPoolBuilderde Rayon para limitar concurrencia en un sistema de tiempo real. - Puedo convertir un algoritmo secuencial a paralelo sin introducir data races o deadlocks.
- Sé medir el impacto de paralelización en percentiles de latencia (no solo promedio).
Optimizar Procesamiento de Logs de Seguridad con Rayon
Implementa un sistema que procese logs de seguridad (ej. intentos de acceso) en paralelo para detectar ataques de fuerza bruta en tiempo real. Sigue estos pasos:
- Crea una estructura
LogEntrycon campos: timestamp (u64), ip (String), success (bool). - Genera 100,000 entradas de prueba con ips aleatorias y 1% de éxitos.
- Implementa una función secuencial que cuente intentos fallidos por ip en últimos 5 minutos (usando un slice de logs ordenado por tiempo).
- Convierte a paralelo con Rayon, dividiendo logs en chunks por rango de tiempo para minimizar sincronización.
- Mide latencia con
std::time::Instantpara 10 ejecuciones, calculando promedio y percentil 90. - Ajusta el tamaño de chunk y número de hilos para optimizar latencia predecible.
Entrega: Código Rust con comentarios mostrando decisiones de optimización, y una tabla con métricas de latencia antes/después.
Pistas
- Usa
par_chunksen lugar depar_iterpara reducir overhead de sincronización. - Considera usar un
HashMappor chunk y combinarlos después para evitar contención en una estructura global. - Perfila con
rayon::ThreadPoolBuilderpara limitar hilos al número de cores físicos.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Rust para Sistemas de Baja Latencia y Alta Seguridad
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.