

Lección 2 de 24 · Lectura y práctica
Tipos de Datos y Estructuras para Performance
Concepto claveEn sistemas de baja latencia y alta seguridad, la elección de tipos de datos y estructuras no es solo una decisión de diseño, sino una estrategia de performance crítica. Los tipos de datos determinan cómo la CPU.
Del concepto a la práctica
Taller de esta lección
Elegir tipos para performance exige separar el tamaño del valor de la forma en que se accede a él. Una marca de severidad con cuatro estados puede representarse como u8, mientras que un texto variable requiere una asignación y un puntero. Esta decisión afecta tamaño, comparación y localidad, pero debe verificarse con size_of en el entorno usado.
Ejemplo resuelto
use std::mem::size_of;

#[derive(Copy, Clone)]
struct Evento {
    id: u64,
    valor: i64,
    nivel: u8,
}

fn main() { println!("{}", size_of::<Evento>()); }
El número exacto depende del layout y el alineamiento; por eso se mide, no se adivina.
Pruébalo
Compila el ejemplo.
Añade un campo
u32.Mueve
niveljunto a los campos pequeños.Compara el tamaño observado.
Comprueba tu resultado
Error frecuente: afirmar que reordenar siempre reduce la estructura. Corrección: medir cada variante y comprobar que el significado no cambia.
Ejercicio: crea tres Evento con ids 1,2,3, valores 100,-20,45 y niveles 1,2,1; calcula manualmente la suma de valores: 125. El programa debe imprimir esa suma y el tamaño medido.
String guarda longitud/capacidad/puntero y puede contener una cadena vacía sin asignación; un &str es una vista prestada. #[repr(Rust)] no fija un orden ABI estable de campos. Mide layout con el compilador usado; no concluyas que sumar tamaños de campos da siempre el tamaño del struct. El fixture100-20+45=125 necesita un iterador que sume valor y main debe imprimir también esa suma, porque el snippet inicial solo imprime size_of.
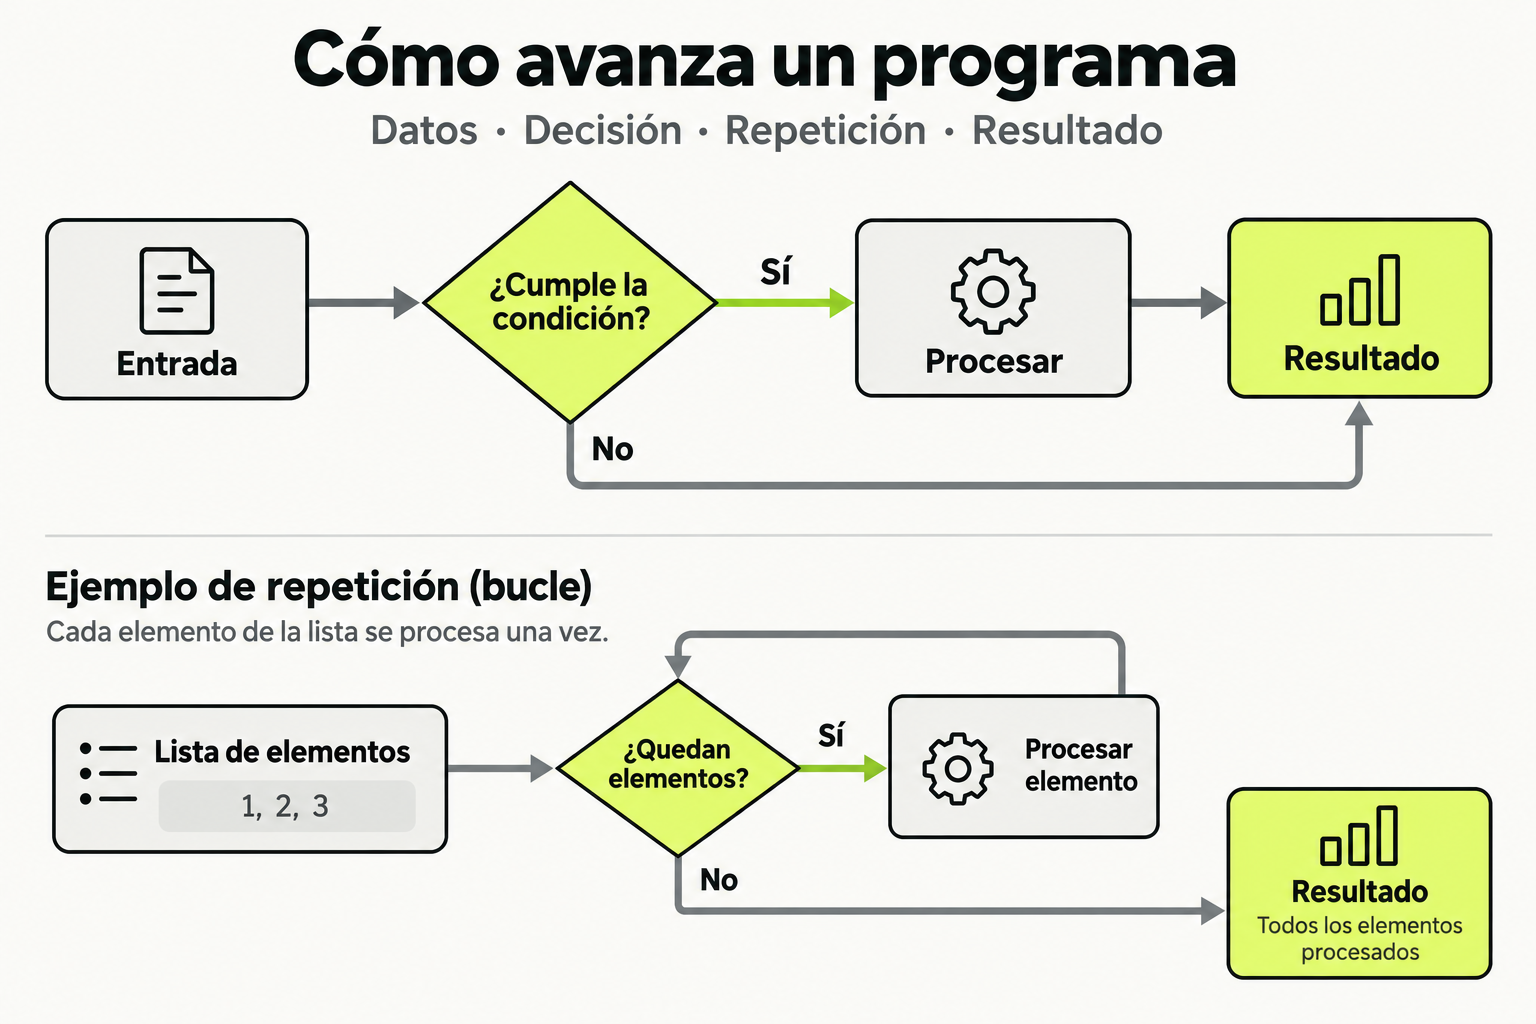
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
En sistemas de baja latencia y alta seguridad, la elección de tipos de datos y estructuras no es solo una decisión de diseño, sino una estrategia de performance crítica. Los tipos de datos determinan cómo la CPU accede a la memoria, mientras que las estructuras definen la organización de esos datos. En Rust, esto se traduce en control preciso sobre la alineación de memoria, el layout de estructuras, y la localidad de datos.
Imagina que estás organizando una biblioteca de alta velocidad donde cada libro debe ser encontrado en nanosegundos. No solo importa qué libros tienes (los datos), sino cómo los ordenas en los estantes (la estructura). Rust te permite diseñar estantes personalizados donde los libros más usados están al frente, evitando pasillos innecesarios (cache misses), y asegurando que cada estante tenga exactamente el tamaño óptimo (alignment).
Cómo funciona en la práctica
Veamos un ejemplo paso a paso de cómo optimizar una estructura para procesamiento de paquetes de red, donde cada nanosegundo cuenta:
// Versión inicial (subóptima)
struct PacketV1 {
    timestamp: u64,      // 8 bytes
    source_ip: [u8; 4],  // 4 bytes
    dest_ip: [u8; 4],    // 4 bytes
    protocol: u8,        // 1 byte
    payload: Vec,    // 24 bytes (pointer + capacity + len)
}
// Tamaño: ~41 bytes + padding

// Versión optimizada
#[repr(C, packed)]
struct PacketV2 {
    timestamp: u64,
    source_ip: u32,      // Empaquetado como u32 en lugar de [u8;4]
    dest_ip: u32,
    protocol: u8,
    // payload se maneja separadamente para evitar indirección
}
// Tamaño: 17 bytes, sin padding, alineación óptima para lectura secuencial
La optimización clave aquí es:
- Usar
#[repr(C, packed)]para eliminar padding y garantizar layout predecible - Convertir arrays de bytes a enteros cuando sea posible para operaciones más rápidas
- Separar datos críticos (metadatos) del payload para mejorar localidad
Caso de estudio
Consideremos un sistema de trading de alta frecuencia que procesa 100,000 órdenes por segundo. Cada orden tiene estos campos:
| Campo | Tipo inicial | Tipo optimizado | Impacto |
|---|---|---|---|
| Order ID | String (24 bytes) | [u8;16] (UUID) | -8 bytes, comparación directa |
| Price | f64 (8 bytes) | i64 (centavos) | Evita floats, precisión exacta |
| Quantity | u32 (4 bytes) | u32 (4 bytes) | Sin cambio |
| Timestamp | u128 (16 bytes) | u64 (nanosegundos desde epoch) | -8 bytes, suficiente precisión |
| Flags | Vec | u8 (bitflags) | -23 bytes, operaciones bit a bit |
Resultado: De ~76 bytes a 33 bytes por orden. En 100,000 órdenes/segundo, esto significa ~4.3MB vs ~1.9MB de tráfico de memoria, reduciendo latencia de cache y ancho de banda.
Errores comunes
- Usar Vec o String para datos pequeños y fijos: La sobrecarga de heap allocation (24 bytes) domina el tamaño de datos pequeños. Solución: Usar arrays en stack o
Box<[T]>para ownership sin overhead. - Ignorar alignment y padding: Rust añade padding automático para alineación, aumentando tamaño de estructuras. Solución: Usar
#[repr(C)]o#[repr(packed)]conscientemente, y ordenar campos de mayor a menor tamaño. - Abusar de enums con payload grande:
Result<T, E>donde E es grande duplica el tamaño máximo. Solución: UsarBox<E>o tipos de error lean. - No considerar cache locality: Estructuras que acceden a datos dispersos causan cache misses. Solución: Agrupar datos accedidos juntos (struct of arrays vs array of structs).
- Usar tipos genéricos sin restricciones:
T: Debugpuede añadir overhead innecesario. Solución: Usar trait bounds específicos y#[inline]selectivamente.
Checklist de dominio
- ¿Puedes calcular el tamaño real (con padding) de cualquier struct usando std::mem::size_of?
- ¿Sabes cuándo usar #[repr(C)], #[repr(packed)], o #[repr(transparent)]?
- ¿Puedes convertir entre ArrayVec, SmallVec, y Vec basado en patrones de uso?
- ¿Entiendes la diferencia entre cache-friendly (struct of arrays) y programmer-friendly (array of structs)?
- ¿Dominas el uso de MaybeUninit para inicialización diferida y evitar ceros innecesarios?
- ¿Puedes identificar y eliminar heap allocations en hot paths?
- ¿Sabes medir el impacto de tus decisiones con cargo bench y perf?
Optimización de Estructura para Procesamiento de Logs de Seguridad
Implementa una estructura optimizada para procesar eventos de seguridad en tiempo real. Sigue estos pasos:
- Crea un struct
SecurityEventque represente un evento con estos campos:- event_id: identificador único (16 bytes máximo)
- timestamp: marca de tiempo en nanosegundos
- severity: nivel de severidad (Critical, High, Medium, Low)
- source_ip: dirección IP origen
- dest_ip: dirección IP destino
- event_type: tipo de evento (10 categorías máximo)
- description: descripción breve (50 caracteres máximo)
- Optimiza el struct considerando:
- Minimizar tamaño total
- Garantizar alineación óptima para lectura secuencial
- Evitar heap allocations innecesarias
- Usar tipos que permitan comparaciones rápidas
- Implementa una función
process_batch(events: &[SecurityEvent])que:- Cuente eventos por severidad
- Encuentre el evento más reciente
- Devuelva estadísticas sin allocations adicionales
- Mide el desempeño con 100,000 eventos y compara con una versión no optimizada.
Pistas
- Considera usar un enum repr(u8) para severity en lugar de String
- Para las IPs, u32 puede ser más eficiente que [u8;4] para comparaciones
- Event type podría ser otro enum con repr(u8) en lugar de String
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Rust para Trading: Concurrencia, Seguridad y Baja Latencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.