

Lección 22 de 24 · Lectura y práctica
Optimización de Latencia y Throughput
Tipo de lección: VideoConcepto claveEn sistemas de trading de baja latencia, la optimización de latencia se refiere a minimizar el tiempo entre la recepción de datos de mercado y la ejecución de órdenes, mientras que el.
Del concepto a la práctica
Taller de esta lección
Latencia y throughput pueden mejorar en direcciones distintas. Procesar por lotes puede aumentar registros por segundo, pero esperar a llenar el lote añade demora al primer registro. Por eso compara una política de uno en uno con lotes de tamaño dos usando los mismos cuatro eventos y reporta ambas unidades.
Ejemplo resuelto
Eventos: A, B, C, D
Lote 1: [A] [B] [C] [D] -> 4 lotes
Lote 2: [A,B] [C,D] -> 2 lotes
Si cada lote tarda 2 ms y no se cuenta espera de llenado, el trabajo serial nominal es 8 ms para cuatro lotes de uno y 4 ms para dos lotes de dos; la latencia observada por evento puede cambiar por la espera.
Pruébalo
Define cuándo se cierra un lote.
Mide tiempo hasta A.
Mide tiempo total hasta D.
Conserva el mismo conjunto de eventos.
Comprueba tu resultado
Error frecuente: llamar throughput al tiempo del primer resultado. Corrección: throughput es eventos por unidad de tiempo; latencia es espera de un evento.
Ejercicio: con cuatro eventos y lotes de dos, deben existir exactamente dos lotes; con lotes de uno, cuatro. No afirmes una mejora sin medir los tiempos.
La hipótesis fija2 ms por lote, no2 ms por evento. Con los cuatro eventos disponibles desde el inicio y procesamiento serial, lote1 entrega A a2ms y D a8ms; lote2 entrega A/B a2ms y C/D a4ms. Throughputs nominales son500 y1000 eventos/s. Si cada evento tarda2ms independientemente, ambos suman8ms: sería otro modelo. Con llegadas separadas la espera de llenado altera latencia; usa un timeout y registra esa espera antes de comparar.
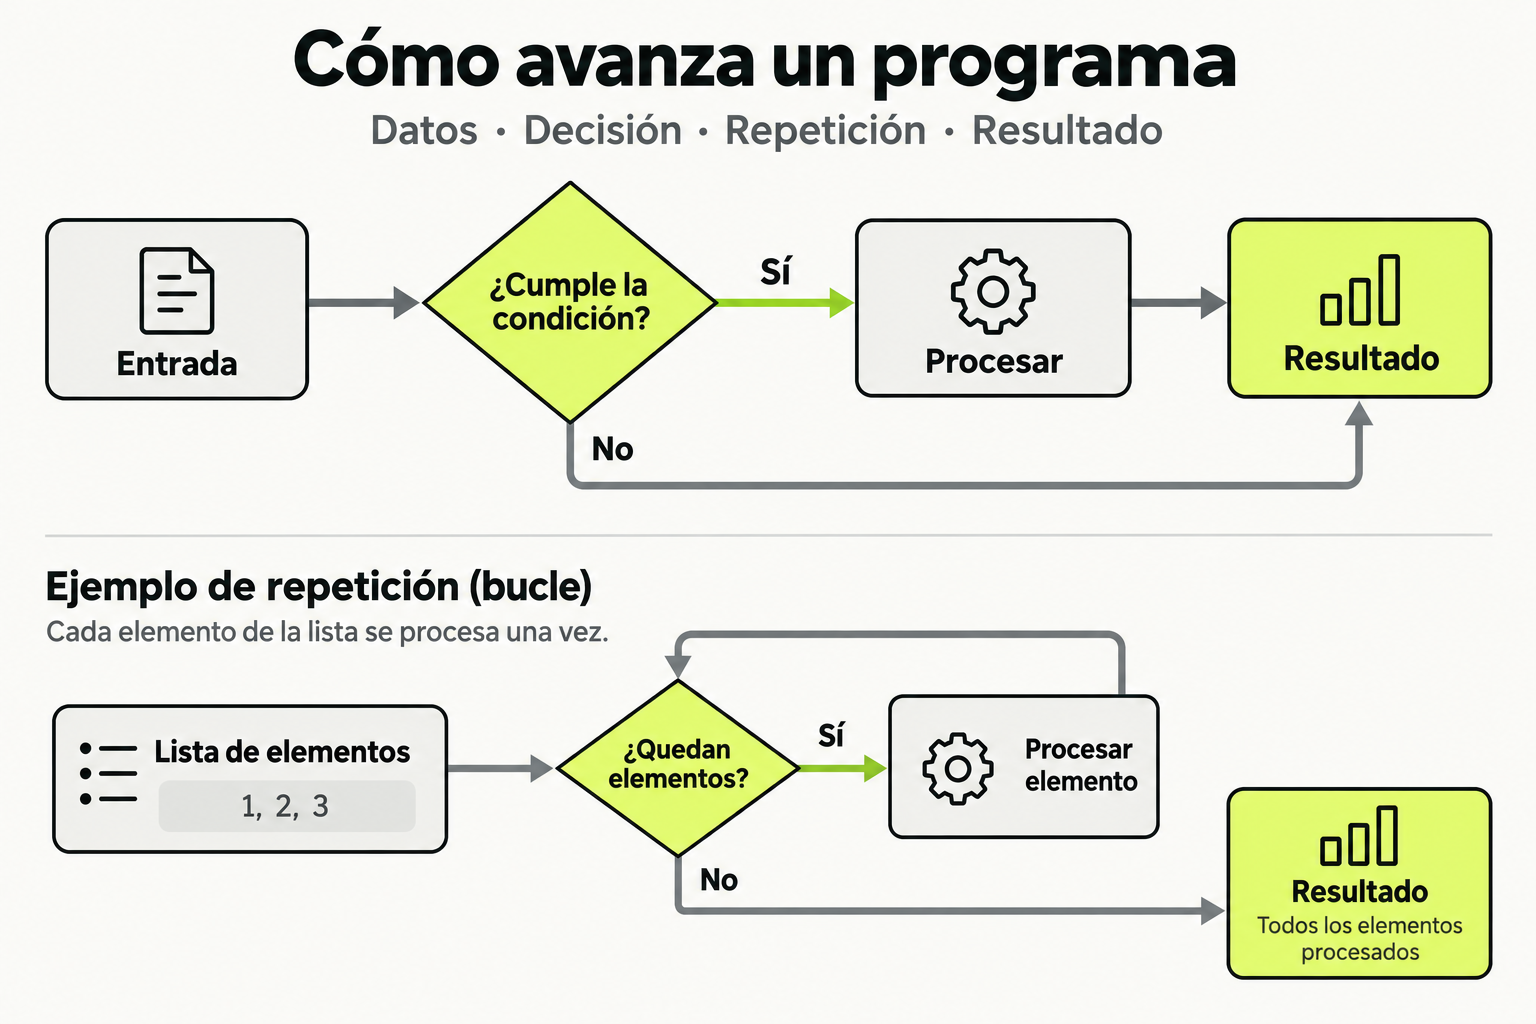
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
En sistemas de trading de baja latencia, la optimización de latencia se refiere a minimizar el tiempo entre la recepción de datos de mercado y la ejecución de órdenes, mientras que el throughput es la cantidad de operaciones procesadas por unidad de tiempo. Piensa en un sistema de semáforos inteligentes: la latencia es el tiempo que tarda en cambiar de rojo a verde tras detectar un coche, y el throughput es cuántos coches pasan por hora. En trading, latencias de microsegundos determinan ganancias o pérdidas.
Rust es ideal para esto porque su sistema de ownership elimina garbage collection (fuente de latencia impredecible), y su compilador optimiza agresivamente. La seguridad de memoria previa vulnerabilidades críticas en sistemas financieros.
En HFT (High-Frequency Trading), reducir 1 microsegundo de latencia puede valer millones anuales.
Cómo funciona en la práctica
Vamos a optimizar un componente de procesamiento de ticks de mercado. Paso 1: Medir latencia base con herramientas como criterion o mediciones hardware. Paso 2: Identificar cuellos de botella con perfiles como perf o flamegraph. Paso 3: Aplicar técnicas específicas.
// Ejemplo: Procesamiento de ticks con zero-copy
struct Tick {
    symbol: [u8; 8],
    price: f64,
    volume: u32,
}

fn process_ticks(ticks: &[Tick]) -> Vec {
    ticks.iter()
        .filter(|t| t.volume > 1000)
        .map(|t| Order::new(t.symbol, t.price))
        .collect()
}
// Optimización: Usar iteradores sin allocations intermedias
Tabla de técnicas comunes:
| Técnica | Impacto latencia | Impacto throughput |
|---|---|---|
| Zero-copy deserialization | Alto | Medio |
| Lock-free estructuras de datos | Alto | Alto |
| SIMD con std::simd | Medio | Alto |
| Memory pooling | Medio | Alto |
Caso de estudio
Un sistema de trading procesa 100,000 ticks/segundo con latencia p95 de 50 microsegundos. Objetivo: reducir a 20 microsegundos manteniendo throughput. Análisis mostró:
- Deserialización JSON consumía 30 microsegundos por tick.
- Colas de mensajes usaban mutexes con contención.
Solución en Rust:
- Reemplazar JSON con binary protocol (Protocol Buffers) y zero-copy parsing.
- Implementar ring buffer lock-free con
crossbeam. - Resultado: latencia p95 de 18 microsegundos, throughput aumentó a 150,000 ticks/segundo.
Errores comunes
- Premature optimization: Optimizar sin medir primero. Usa benchmarks realistas con datos de producción.
- Ignorar cache locality: Estructuras de datos mal alineadas causan cache misses. Usa
#[repr(C)]o#[repr(align(64))]para alineación. - Abuso de allocations: Crear
VecoStringen loops críticos. Reutiliza buffers conclear()o pools. - Blocking en async code: Llamadas bloqueantes en runtimes async como Tokio. Usa
spawn_blockingpara CPU-bound. - No considerar NUMA: En servidores multi-socket, memoria asignada en socket incorrecto añade latencia. Usa
numa-rspara afinidad.
Checklist de dominio
- Medir latencia y throughput con herramientas como criterion, perf, o hardware counters.
- Implementar zero-copy deserialization con serde o custom parsers.
- Usar estructuras lock-free (ej., crossbeam::queue) para datos compartidos.
- Aplicar SIMD a operaciones batch con std::simd o packed_simd.
- Configurar afinidad de hilos y memoria para NUMA.
- Validar seguridad sin overhead (ej., bounds checks elided por el compilador).
- Documentar trade-offs entre latencia y throughput en decisiones de diseño.
Optimizar un procesador de ticks con lock-free ring buffer
Implementa un sistema que procese ticks de mercado desde múltiples hilos productores a un consumidor, minimizando latencia.
- Crea una estructura
Tickcon symbol (String), price (f64), timestamp (u64). - Implementa un ring buffer lock-free usando
crossbeam::queue::ArrayQueuecon capacidad para 1024 ticks. - Escribe un productor que genere 10,000 ticks aleatorios y los pushee al buffer desde 2 hilos concurrentes.
- Escribe un consumidor que popee ticks y calcule el precio promedio, registrando latencia (timestamp actual - tick.timestamp).
- Mide la latencia p95 y throughput (ticks/segundo) con
std::time::Instant. - Optimiza: reemplaza String en Tick con
[u8; 8]para symbol, y usa memory pool para reutilizar structs. - Compara métricas antes y después, documenta resultados.
Pistas
- Usa crossbeam::queue::ArrayQueue para el buffer lock-free.
- Para medir latencia p95, almacena mediciones en un Vec y ordena.
- Considera usar #[repr(C)] para alinear Tick a 64 bytes y mejorar cache locality.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Rust para Trading: Concurrencia, Seguridad y Baja Latencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.