

Lección 6 de 21 · Lectura y práctica
Implementar Cache en una API REST con Redis
Concepto claveImplementar cache con Redis en una API REST es una estrategia fundamental para mejorar el rendimiento de aplicaciones backend. En esencia, el cache actúa como una capa de almacenamiento temporal de alta velocidad.
Del concepto a la práctica
Taller de esta lección
En una API REST, cache-aside debe conservar la semántica de la respuesta aunque Redis falle. La clave incluye método lógico, recurso e identificador; una respuesta de producto no debe colisionar con una lista filtrada. Serializar el cuerpo completo facilita devolver exactamente los mismos campos.
Ejemplo resuelto
Para GET /productos/7, la clave puede ser api:producto:7. El flujo es: buscar, si existe devolver el JSON, si falta consultar la fuente, guardar durante 30 segundos y devolver. Si Redis produce un error, se consulta directamente la fuente y se registra el fallo.
Con client conectado y fuente local, el ejemplo secuencial puede ser:
const fuente = new Map([[7,{id:7,precioCentavos:1200}]]);
async function producto(id) {
  const key = `lab:api:producto:${id}`;
  try {
    const cached = await client.get(key);
    if (cached !== null) return JSON.parse(cached);
  } catch { console.error('cache_read_failed'); }
  const value = fuente.get(id);
  if (!value) return null;
  try { await client.set(key, JSON.stringify(value), {EX:30}); }
  catch { console.error('cache_write_failed'); }
  return value;
}
El try de escritura no debe convertir una respuesta válida de la fuente en500. El ejemplo requiere timeouts del cliente para no esperar eternamente antes del fallback. Para datos privados incluye tenant/permiso/versionado en la clave o evita cache compartida; no cachees un403/401 como producto público. Durante caída protege la base de una avalancha mediante límites y circuit breaker.
Pruébalo
Solicita el producto 7 con cache vacía.
Registra un miss y guarda el cuerpo.
Repite la solicitud y registra un hit.
Simula Redis no disponible y verifica el camino directo.
Comprueba tu resultado
Error frecuente: devolver null cuando falla Redis aunque la fuente esté disponible. Corrige tratando Redis como acelerador, no como única fuente. Resultado esperado: primera solicitud miss, segunda hit, mismo cuerpo JSON en ambas y respuesta de la fuente durante la caída controlada.
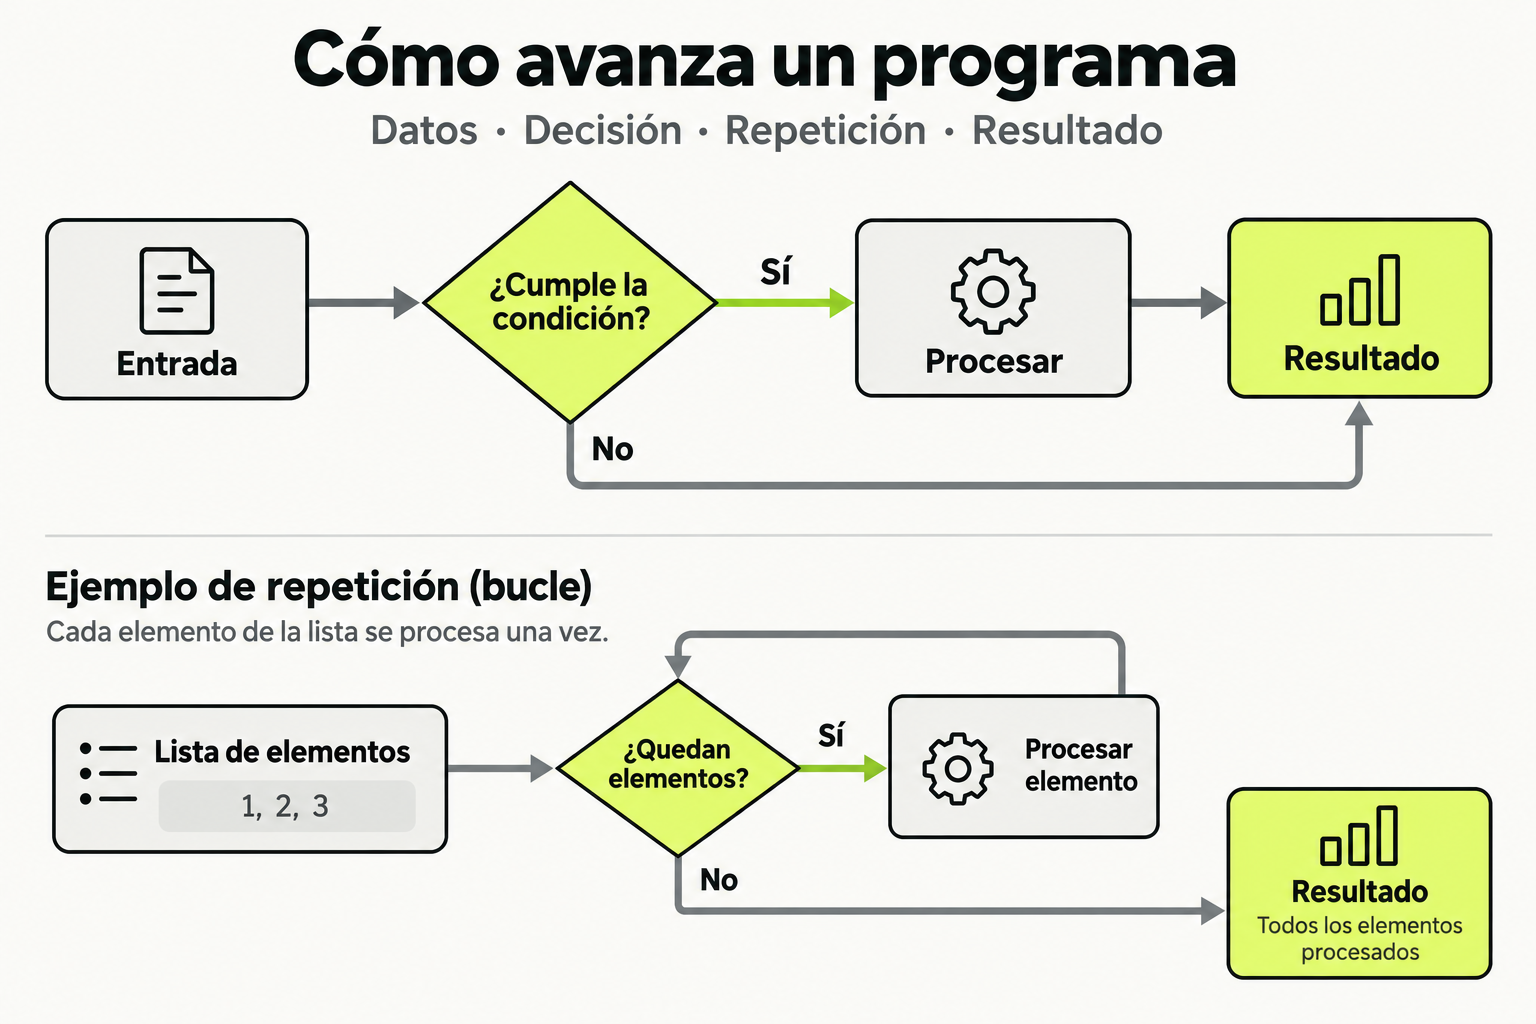
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Concepto clave
Implementar cache con Redis en una API REST es una estrategia fundamental para mejorar el rendimiento de aplicaciones backend. En esencia, el cache actúa como una capa de almacenamiento temporal de alta velocidad que guarda respuestas frecuentemente solicitadas, reduciendo la carga en bases de datos primarias y acelerando los tiempos de respuesta.
Imagina un restaurante muy concurrido donde los platos más populares se preparan en pequeñas cantidades y se mantienen listos para servir, en lugar de cocinarlos desde cero para cada pedido. Redis funciona de manera similar: almacena datos como respuestas JSON de endpoints API, evitando costosas consultas a bases de datos para solicitudes idénticas. Esto es especialmente crítico en escenarios de alta concurrencia, donde cada milisegundo cuenta.
El ciclo básico de cache implica: 1) Verificar si la respuesta existe en Redis, 2) Si existe, devolverla inmediatamente, 3) Si no existe, obtener los datos de la fuente original (ej., base de datos), 4) Almacenar la respuesta en Redis con un tiempo de expiración (TTL), y 5) Devolver la respuesta al cliente. Este patrón, conocido como cache-aside o lazy loading, es el más común en APIs REST.
Cómo funciona en la práctica
Veamos un ejemplo paso a paso para implementar cache en un endpoint de API que obtiene detalles de usuario. Supongamos una API REST construida con Node.js y Express, usando Redis como servidor de cache.
- Configuración inicial: Conecta tu aplicación a Redis usando una biblioteca como
ioredisoredis. Establece un cliente Redis que maneje conexiones y reconexiones automáticas. - Diseño de clave: Define una clave única para cada recurso cacheado. Por ejemplo, para un usuario con ID 123, usa
user:123. Esto asegura que no haya colisiones y facilita la invalidación. - Implementación del middleware o lógica de cache: En el controlador del endpoint
GET /users/:id, añade la lógica para verificar primero en Redis. - Manejo de expiración: Configura un TTL (Time To Live) adecuado, como 300 segundos, para que los datos no se vuelvan obsoletos indefinidamente.
- Invalidación: Actualiza o elimina la clave en Redis cuando los datos del usuario cambian (ej., en endpoints
PUT /users/:id), para mantener la consistencia.
Aquí un fragmento de código ilustrativo:
async function getUser(req, res) {
  const userId = req.params.id;
  const cacheKey = `user:${userId}`;

  // Paso 1: Intentar obtener del cache
  const cachedUser = await redisClient.get(cacheKey);
  if (cachedUser) {
    return res.json(JSON.parse(cachedUser));
  }

  // Paso 2: Si no está en cache, consultar base de datos
  const user = await db.users.findById(userId);
  if (!user) {
    return res.status(404).json({ error: 'Usuario no encontrado' });
  }

  // Paso 3: Almacenar en cache con TTL
  await redisClient.setex(cacheKey, 300, JSON.stringify(user));

  // Paso 4: Devolver respuesta
  res.json(user);
}
Caso de estudio
Considera una plataforma de e-commerce con un endpoint GET /products/:id que muestra detalles de productos. Sin cache, cada solicitud genera una consulta SQL a una base de datos PostgreSQL, lo que bajo carga de 1000 solicitudes por segundo causa latencias de 200ms y alta carga en la BD.
Al implementar cache con Redis:
- Se define una clave como
product:${id}para cada producto. - Se configura un TTL de 600 segundos, ya que los productos cambian ocasionalmente.
- Se añade lógica para invalidar el cache cuando un producto se actualiza (ej., en
PUT /products/:id).
Resultados medidos en producción:
| Métrica | Sin Cache | Con Cache |
|---|---|---|
| Tiempo de respuesta promedio | 200ms | 5ms |
| Carga en base de datos | 1000 consultas/seg | 50 consultas/seg |
| Disponibilidad API | 95% | 99.9% |
En este caso, el cache redujo la latencia en un 97.5% y liberó recursos críticos de la base de datos, mejorando la escalabilidad general del sistema.
Errores comunes
- TTL demasiado largo o infinito: Almacenar datos en cache sin expiración puede llevar a datos obsoletos. Solución: Define TTLs basados en la frecuencia de cambio de los datos (ej., 300 segundos para datos semi-estáticos).
- Falta de invalidación: No actualizar o eliminar el cache cuando los datos cambian, causando inconsistencias. Solución: Invalida las claves relevantes en operaciones de escritura (ej., al actualizar un recurso).
- Claves mal diseñadas: Usar claves genéricas que causan colisiones o dificultan la gestión. Solución: Usa un esquema jerárquico como
tipo:id(ej.,user:123). - Cache de respuestas con errores: Almacenar respuestas de error (ej., 404) puede llenar el cache con datos inútiles. Solución: Solo cachea respuestas exitosas (códigos 2xx).
- Ignorar el costo de serialización: Serializar/deserializar JSON en cada operación de cache añade overhead. Solución: Usa formatos eficientes o considera bibliotecas optimizadas.
Checklist de dominio
- ¿Puedes configurar una conexión a Redis desde tu backend y manejar errores de conexión?
- ¿Sabes diseñar claves de cache únicas y descriptivas para diferentes recursos de tu API?
- ¿Implementas correctamente el patrón cache-aside en al menos un endpoint REST?
- ¿Defines TTLs apropiados basados en la naturaleza de los datos (ej., corto para datos dinámicos, largo para estáticos)?
- ¿Invalidas el cache automáticamente cuando los datos se actualizan o eliminan?
- ¿Mides el impacto del cache en métricas como latencia y carga de base de datos?
- ¿Manejas edge cases como fallos de Redis sin afectar la funcionalidad principal de la API?
Implementa Cache en un Endpoint de API para Lista de Productos
En este ejercicio, implementaras cache con Redis en un endpoint de API REST que devuelve una lista de productos. Sigue estos pasos:
- Configura un proyecto Node.js con Express y conecta a un servidor Redis local o en la nube. Usa la biblioteca
ioredispara la conexion. - Crea un endpoint
GET /productsque simule obtener una lista de productos desde una base de datos (puedes usar un array en memoria como simulacion). - Implementa la logica de cache: Antes de devolver la lista, verifica si existe una clave
products:listen Redis. Si existe, devuelve los datos cacheados; si no, obten los productos, almacenalos en Redis con un TTL de 60 segundos, y luego devuelvelos. - Añade un endpoint
POST /productspara agregar un nuevo producto. En este endpoint, despues de agregar el producto, invalida la claveproducts:listen Redis para mantener la consistencia. - Prueba tu implementacion: Realiza solicitudes GET para ver el cache en accion, y luego POST para ver como se invalida. Usa herramientas como curl o Postman.
Objetivo: Reducir el tiempo de respuesta del endpoint GET en solicitudes repetidas y asegurar que los datos siempre esten actualizados.
Pistas
- Recuerda usar JSON.stringify() para almacenar objetos en Redis y JSON.parse() para recuperarlos.
- Configura un manejador de errores para la conexion a Redis, para que tu API siga funcionando incluso si Redis falla.
- Considera usar un patron de retry para la conexion a Redis en entornos de produccion.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Redis en Producción: Cache, Sesiones y Colas para Backend Engineers
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.