

Lección 10 de 25 · Lectura y práctica
Quiz de Optimización de Queries
Tipo de lección: QuizConcepto claveEn aplicaciones de alta concurrencia, la optimización de queries va más allá de simplemente hacerlas más rápidas. Se trata de minimizar el bloqueo y maximizar el paralelismo mientras se mantiene.
Del concepto a la práctica
Taller de esta lección
La optimización bajo concurrencia se evalúa con una matriz de decisiones, no con una única cifra. Una consulta puede tener menor latencia aislada pero más escrituras, locks o memoria por ejecución. El criterio debe combinar salida correcta, plan, recursos y comportamiento al repetirla. Las respuestas del quiz deben justificar qué evidencia falta antes de cambiar un parámetro.
Ejemplo resuelto
Una consulta tarda 40 ms aislada con un índice nuevo y 55 ms sin él, pero durante 20 clientes el índice reduce lecturas de 100.000 a 4.000 por ejecución. La decisión favorable requiere confirmar que el coste de mantenerlo no perjudica las escrituras críticas.
Verifica equivalencia de resultados.
Compara filas, buffers y tiempo aislado.
Repite con concurrencia fija.
Mide escrituras y esperas, no solo lecturas.
Error frecuente: elegir la alternativa con menor promedio sin revisar percentiles o errores. Corrección: informa p95, fallos y condiciones del ensayo.
Los40/55 ms y100000/4000 lecturas son cifras sintéticas para razonar, no una mejora observada ni todos los registros de un benchmark. El cálculo reproducible del ejercicio usa solo las cuatro latencias40,42,45,90: suma217, media54,25 y nearest-rank ceil(0,95×4)=4. Cuatro muestras permiten practicar la fórmula, pero son insuficientes para inferir un p95 estable de producción; mide mezcla, errores y repeticiones.
Pruébalo
Para resultados de latencia [40,42,45,90] ms, calcula promedio y p95 usando la convención de rango más cercano y declara la convención.
Comprueba tu resultado
El promedio es 54,25 ms; con rango más cercano, el p95 corresponde al cuarto valor: 90 ms. No confundas ambas medidas.
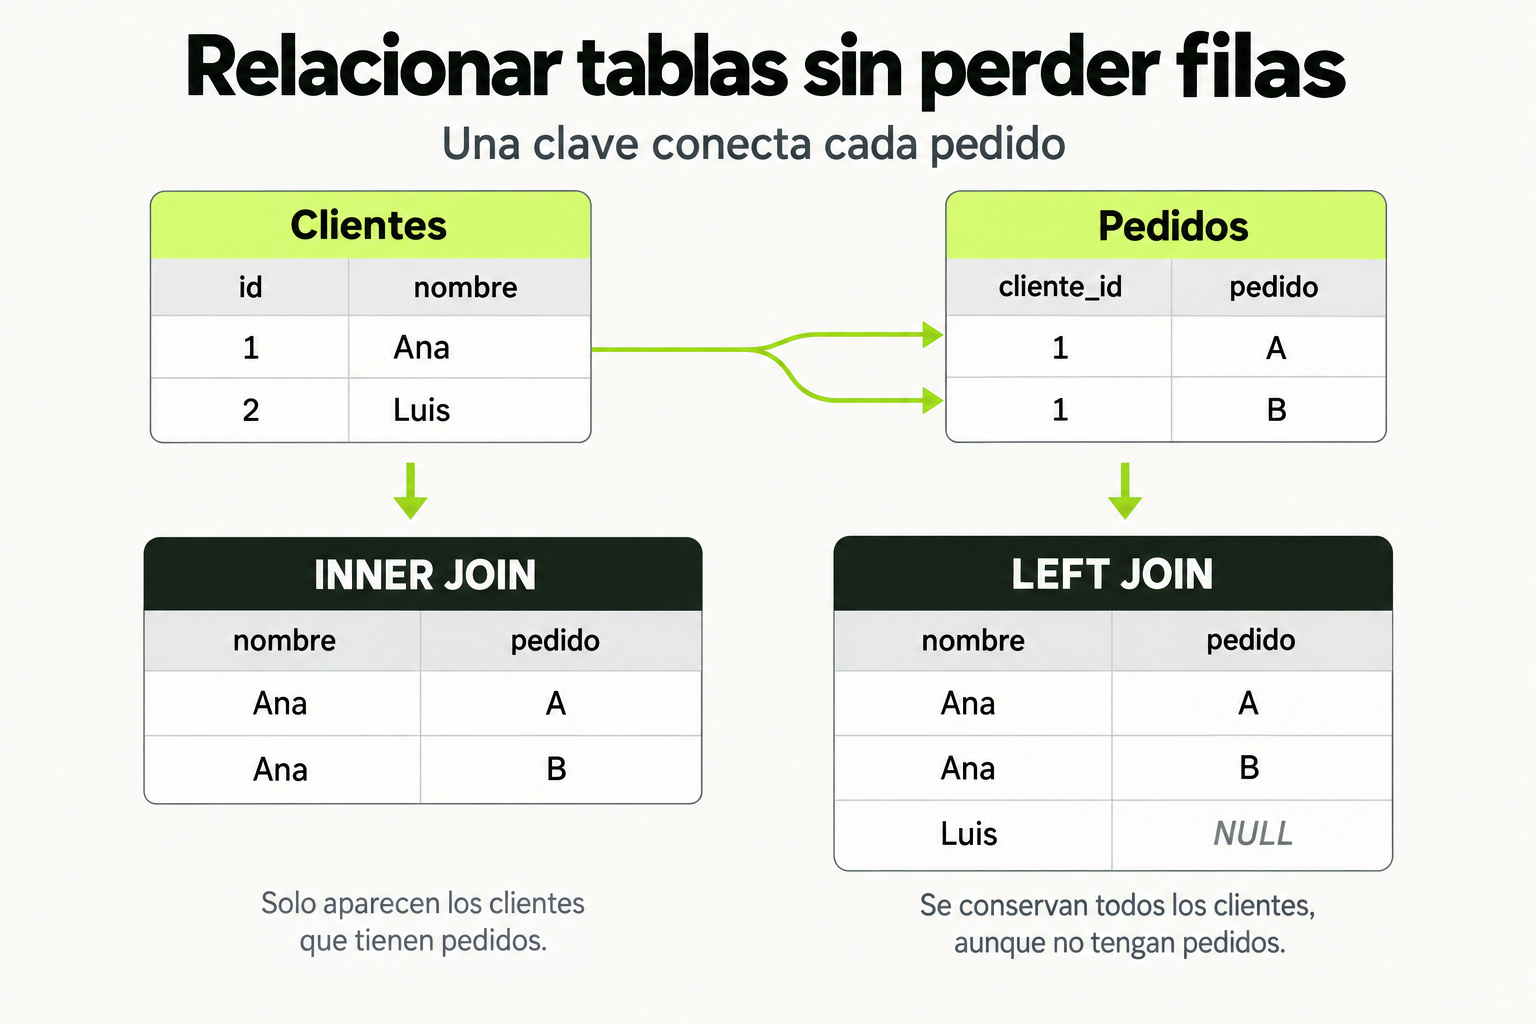
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
En aplicaciones de alta concurrencia, la optimización de queries va más allá de simplemente hacerlas más rápidas. Se trata de minimizar el bloqueo y maximizar el paralelismo mientras se mantiene la consistencia de datos. Imagina una autopista con múltiples carriles: si todos los coches usan el mismo carril, se crean atascos. PostgreSQL permite configurar "carriles" virtuales mediante técnicas avanzadas de indexación y planificación de queries.
El plan de ejecución es el mapa que PostgreSQL crea para procesar tu query. En alta concurrencia, un mal plan no solo afecta a una query, sino que puede bloquear recursos para otras conexiones simultáneas. Es como un chef en un restaurante lleno: si organiza mal los ingredientes, toda la cocina se atasca.
Cómo funciona en la práctica
Veamos un ejemplo real de una aplicación de e-commerce con miles de usuarios concurrentes. Tenemos una tabla de órdenes que crece constantemente:
-- Tabla original con problemas de concurrencia
CREATE TABLE orders (
    id SERIAL PRIMARY KEY,
    user_id INT NOT NULL,
    amount DECIMAL(10,2),
    status VARCHAR(20),
    created_at TIMESTAMP DEFAULT NOW(),
    updated_at TIMESTAMP DEFAULT NOW()
);

-- Índice básico (insuficiente para alta concurrencia)
CREATE INDEX idx_orders_user_id ON orders(user_id);
Cuando múltiples usuarios consultan sus órdenes simultáneamente, PostgreSQL usa el índice en user_id, pero si muchos usuarios tienen muchas órdenes, se producen bloqueos de página y contención de E/S.
Código en acción
Aquí está la optimización completa:
-- ANTES: Query que causa bloqueos en alta concurrencia
SELECT * FROM orders
WHERE user_id = 1234
AND status = 'pending'
ORDER BY created_at DESC
LIMIT 10;

-- DESPUÉS: Optimización con índice compuesto y covering index
-- Primero, creamos un índice optimizado
CREATE INDEX idx_orders_concurrent ON orders(user_id, status, created_at DESC)
INCLUDE (amount, updated_at);

-- Query optimizada que usa el covering index
SELECT id, user_id, amount, status, created_at, updated_at
FROM orders
WHERE user_id = 1234
AND status = 'pending'
ORDER BY created_at DESC
LIMIT 10;
El índice compuesto ordena por user_id, luego status, y finalmente created_at en orden descendente. La cláusula INCLUDE añade columnas adicionales para que la query pueda ser resuelta completamente desde el índice (index-only scan), reduciendo accesos a la tabla principal.
Errores comunes
- Usar SELECT * indiscriminadamente: En alta concurrencia, traer columnas innecesarias aumenta el I/O y bloquea más filas de las necesarias.
- Índices redundantes: Crear múltiples índices que se solapan consume memoria y ralentiza las operaciones de escritura concurrentes.
- Olvidar el orden en índices compuestos: El orden de las columnas en un índice compuesto es crucial para el rendimiento concurrente.
- Ignorar el fillfactor: No ajustar el fillfactor en tablas con muchas actualizaciones concurrentes causa fragmentación y bloqueos.
- Consultas sin LIMIT en resultados grandes: Procesar miles de filas simultáneamente bloquea recursos para otras conexiones.
Checklist de dominio
- ¿Analizas regularmente los planes de ejecución con EXPLAIN ANALYZE en carga real?
- ¿Usas índices compuestos en lugar de múltiples índices simples?
- ¿Implementas covering indexes para queries frecuentes?
- ¿Ajustas el fillfactor según los patrones de escritura concurrente?
- ¿Minimizas el tiempo de bloqueo con transacciones cortas?
- ¿Monitorizas las waits y locks en tiempo real?
- ¿Pruebas el rendimiento con cargas concurrentes simuladas?
Optimización de Query para Dashboard en Tiempo Real
Eres el backend engineer de una plataforma de trading con 10,000 usuarios concurrentes. La siguiente query se ejecuta cada 5 segundos por usuario para mostrar su dashboard:
SELECT t.id, t.symbol, t.price, t.volume, t.timestamp, u.balance
FROM trades t
JOIN users u ON t.user_id = u.id
WHERE t.user_id = $1
AND t.timestamp > NOW() - INTERVAL '24 hours'
ORDER BY t.timestamp DESC
LIMIT 50;
Pasos a seguir:
- Analiza la estructura actual de las tablas (puedes asumir índices básicos en las claves primarias)
- Identifica los cuellos de botella para alta concurrencia
- Diseña un índice optimizado que minimice bloqueos
- Reescribe la query para aprovechar el nuevo índice
- Propone una estrategia de mantenimiento del índice
Entrega tu solución en un archivo SQL con comentarios explicando cada decisión.
Pistas
- Considera un índice compuesto que cubra todos los filtros y el ordenamiento
- Piensa en cómo reducir los JOINs en queries de alta frecuencia
- Investiga el uso de índices parciales para datos recientes
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.