

Lección 14 de 25 · Lectura y práctica
Práctica: Diseño de Estrategia de Indexing
Concepto claveEl diseño de estrategia de indexing en PostgreSQL para aplicaciones de alta concurrencia no se trata solo de agregar indices, sino de crear un ecosistema de indices que equilibre velocidad de lectura, costo de.
Del concepto a la práctica
Taller de esta lección
Diseñar una estrategia consiste en relacionar consultas, frecuencia, selectividad y coste de escritura. Una tabla de pedidos puede recibir muchas inserciones y pocas consultas administrativas; en ese caso un índice útil pero pesado quizá no merezca existir. La matriz debe registrar cobertura, condición, columnas y evidencia, no solo nombres de índices.
Ejemplo resuelto
Consultas: buscar pedidos de un usuario ordenados por fecha y contar pedidos abiertos. Se proponen (usuario_id, creado_en DESC) y un parcial sobre estado='abierto'. Se descarta un índice separado solo sobre estado si la distribución es 95% abierta y filtra poco.
Anota cada consulta y su frecuencia relativa.
Estima selectividad con conteos reales.
Propón el menor conjunto de índices.
Mide lectura y penalización de inserción.
Error frecuente: crear un índice para cada columna mencionada. Corrección: diseña para patrones completos y elimina redundancias justificadas.
80/100=80% de filas devueltas y20% eliminadas: eso describe selectividad, sin garantizar el plan elegido. Un parcial con predicado abierto necesita una CLAVE concreta, por ejemplo creado_en para contar/examinar abiertos; COUNT aún recorre las entradas y revisa visibilidad según plan. Antes de descartar estado compara variantes bajo carga y costo de inserción; no deduzcas solo del95% ilustrativo que todo parcial sea inútil.
Pruébalo
Con 100 pedidos, 80 abiertos, 15 cerrados y 5 cancelados, decide si estado aislado es selectivo y propone el índice del usuario.
Comprueba tu resultado
estado='abierto' devuelve 80%; su selectividad es baja. El patrón de usuario-fecha justifica (usuario_id, creado_en DESC) si la consulta es frecuente.
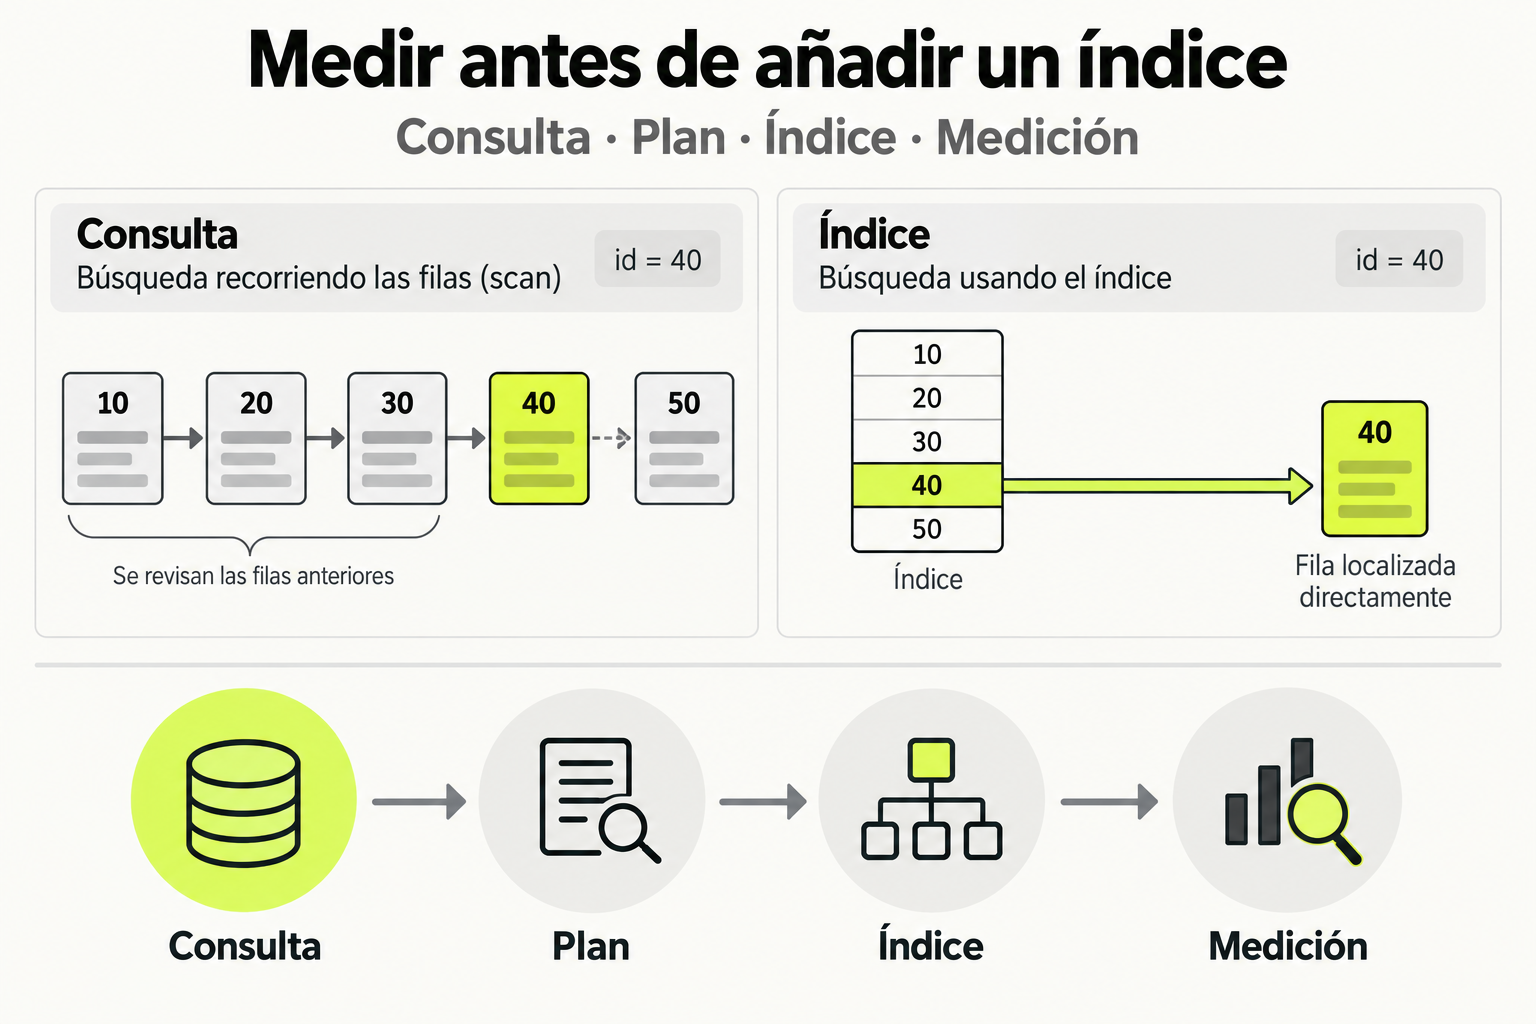
 Mapa de práctica
Un índice puede ayudar a localizar las filas que necesita una consulta. Su utilidad depende del patrón de acceso y del coste de mantenerlo. Mide la consulta, revisa el plan y vuelve a medir después del cambio en lugar de suponer una mejora.
Ver la infografía en tamaño completo ↗Concepto clave
El diseño de estrategia de indexing en PostgreSQL para aplicaciones de alta concurrencia no se trata solo de agregar indices, sino de crear un ecosistema de indices que equilibre velocidad de lectura, costo de escritura y mantenimiento del sistema. Piensa en esto como el sistema de transporte de una gran ciudad: no basta con tener muchas calles (indices), necesitas avenidas principales (indices compuestos), rutas alternativas (indices parciales) y regulacion del trafico (monitoreo de uso).
En entornos de alta concurrencia, cada indice adicional representa un compromiso: acelera las consultas SELECT pero ralentiza las operaciones INSERT, UPDATE y DELETE, ya que PostgreSQL debe mantener todos los indices sincronizados. La clave esta en identificar los patrones de acceso mas frecuentes y diseñar indices que maximicen el rendimiento para el 80% de las consultas criticas, aceptando que el 20% restante puede ser menos optimo.
Como funciona en la practica
Imagina una plataforma de e-commerce con 10 millones de usuarios y 100 transacciones por segundo. Tu tabla principal orders tiene esta estructura inicial:
CREATE TABLE orders (
    id SERIAL PRIMARY KEY,
    user_id INTEGER NOT NULL,
    product_id INTEGER NOT NULL,
    status VARCHAR(20) NOT NULL,
    amount DECIMAL(10,2) NOT NULL,
    created_at TIMESTAMP DEFAULT NOW(),
    updated_at TIMESTAMP DEFAULT NOW()
);
El problema: las consultas mas frecuentes buscan ordenes por usuario y estado, pero tambien necesitas reportes por fecha. Sin indices especificos, PostgreSQL realiza secuencias completas de la tabla, causando bloqueos y lentitud.
Paso 1: Analiza las consultas con EXPLAIN ANALYZE. Paso 2: Identifica que el 70% de las consultas son SELECT * FROM orders WHERE user_id = ? AND status = ? ORDER BY created_at DESC. Paso 3: Crea un indice compuesto que cubra exactamente este patron. Paso 4: Monitorea el impacto en las escrituras.
Codigo en accion
Antes: Solo el indice primario en id, consultas lentas:
-- Consulta tipica sin indice optimo
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE user_id = 12345
AND status = 'completed'
ORDER BY created_at DESC
LIMIT 10;

-- Resultado: Seq Scan en orders, costo: 250000
Despues: Estrategia de indexing multicapa:
-- 1. Indice compuesto para el patron principal
CREATE INDEX idx_orders_user_status_created
ON orders(user_id, status, created_at DESC);

-- 2. Indice parcial para estados activos (solo 5% de las filas)
CREATE INDEX idx_orders_active
ON orders(user_id, created_at)
WHERE status IN ('pending', 'processing');

-- 3. Indice para reportes administrativos
CREATE INDEX idx_orders_daily_report
ON orders(date(created_at), status, amount);

-- Ahora la misma consulta
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE user_id = 12345
AND status = 'completed'
ORDER BY created_at DESC
LIMIT 10;

-- Resultado: Index Scan usando idx_orders_user_status_created, costo: 4.2
Errores comunes
- Sobre-indexar tablas de alta escritura: Agregar indices a tablas con mas de 100 escrituras/segundo sin evaluar el impacto en INSERT/UPDATE. Solucion: Usa
pg_stat_user_indexespara monitorear el uso real. - Ignorar el orden de columnas en indices compuestos: Crear
(status, user_id)cuando las consultas usanWHERE user_id = ? AND status = ?. PostgreSQL no puede usar eficientemente la segunda columna si la primera no esta en el WHERE. Solucion: Ordena las columnas por cardinalidad (de menor a mayor). - No considerar indices parciales: Indexar toda la tabla cuando solo necesitas un subconjunto (ej: ordenes activas). Esto desperdicia espacio y ralentiza mantenimiento. Solucion: Usa WHERE en CREATE INDEX para filtrar filas irrelevantes.
- Olvidar el mantenimiento periodico: Los indices se fragmentan con el tiempo en tablas con muchas actualizaciones. Solucion: Programa
REINDEXoVACUUMen horas de baja actividad. - Indexar columnas con baja selectividad: Como "gender" con solo 2 valores distintos. El optimizador puede ignorar estos indices. Solucion: Solo indexa columnas con alta selectividad (> 10% valores unicos).
Checklist de dominio
- He identificado las 5-10 consultas mas frecuentes en mi aplicacion usando
pg_stat_statements - He ejecutado EXPLAIN ANALYZE en cada consulta critica para entender el plan de ejecucion actual
- He creado indices compuestos que cubren exactamente los patrones WHERE y ORDER BY juntos
- He implementado al menos un indice parcial para filtrar subconjuntos de datos relevantes
- He monitoreado el tamaño de indices vs datos con
\di+ypg_relation_size - He verificado que los nuevos indices no aumenten el tiempo de escritura en mas del 15%
- Tengo un proceso automatizado para revisar y eliminar indices no utilizados mensualmente
Optimizacion de Indices para Sistema de Mensajeria en Tiempo Real
Eres el ingeniero de backend de una aplicacion de mensajeria con 5 millones de usuarios activos. La tabla messages tiene problemas de rendimiento durante horas pico.
Estructura actual:
CREATE TABLE messages (
    id BIGSERIAL PRIMARY KEY,
    sender_id INTEGER NOT NULL,
    receiver_id INTEGER NOT NULL,
    conversation_id INTEGER NOT NULL,
    content TEXT NOT NULL,
    is_read BOOLEAN DEFAULT false,
    created_at TIMESTAMP DEFAULT NOW()
);
Patrones de consulta identificados:
- Obtener mensajes no leidos de una conversacion especifica (80% de las consultas):
SELECT * FROM messages WHERE conversation_id = ? AND is_read = false ORDER BY created_at DESC - Buscar mensajes entre dos usuarios en un rango de fechas (15%):
SELECT * FROM messages WHERE (sender_id = ? AND receiver_id = ?) OR (sender_id = ? AND receiver_id = ?) AND created_at BETWEEN ? AND ? - Reporte administrativo: conteo de mensajes por dia (5%)
Tarea:
- Analiza los patrones y propone una estrategia de indexing con al menos 3 indices diferentes
- Escribe los comandos CREATE INDEX completos con sintaxis correcta
- Justifica cada indice explicando que patron cubre y por que es optimo
- Incluye un indice parcial para optimizar espacio
- Muestra como verificarias el rendimiento con EXPLAIN ANALYZE
Pistas
- Considera que is_read = false solo aplica a una fraccion de los mensajes (indice parcial)
- Para la busqueda entre dos usuarios, piensa en como PostgreSQL usa indices con condiciones OR
- Los reportes administrativos pueden usar indices sobre funciones como date(created_at)
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.