

Lección 4 de 25 · Lectura y práctica
Práctica: Diagnóstico de Cuellos de Botella
Concepto claveLos cuellos de botella en PostgreSQL son puntos de estrangulamiento que limitan el rendimiento de tu base de datos bajo alta concurrencia. Imagina una autopista con múltiples carriles que se reduce a uno: aunque.
Del concepto a la práctica
Taller de esta lección
Diagnosticar un cuello de botella exige separar síntoma, recurso y causa. Una cola de consultas puede provenir de CPU, lectura de disco, locks o conexiones ocupadas; el tiempo total por sí solo no distingue esas posibilidades. pg_stat_activity ayuda a observar estado y espera, mientras que pg_locks relaciona objetos y modos de bloqueo. La captura debe ser puntual y anonimizada.
Ejemplo resuelto
Tres sesiones muestran: A ejecutando un UPDATE desde hace 18 s, B en espera de bloqueo sobre la misma relación y C activa leyendo otra tabla. El cuello inmediato es la transacción larga de A, no necesariamente la consulta de B.
Registra hora, estado y duración.
Identifica si la sesión espera lock, I/O o cliente.
Relaciona bloqueador y bloqueado mediante el objeto común.
Corrige la causa y repite la observación.
Error frecuente: cancelar siempre al proceso bloqueado. Corrección: inspecciona primero al bloqueador y verifica si la cancelación es segura.
No basta con ver el mismo objeto en pg_locks para atribuir causalidad. Consulta pg_blocking_pids(pid) para la sesión esperadora y vincula el PID a pg_stat_activity; compara xact_start con query_start. Una A idle in transaction puede seguir reteniendo locks aunque su última consulta acabó. El fixture bloquea la MISMA fila, no solo la misma relación. No canceles/termines procesos de una base compartida desde este ejercicio; confirma o revierte tu propia transacción local.
Pruébalo
Construye tres sesiones locales con una actualización sin commit y otra actualización sobre la misma fila. Dibuja la relación bloqueador-esperador.
Comprueba tu resultado
La segunda sesión debe aparecer esperando y la primera como bloqueadora; al confirmar o revertir A, B puede continuar.
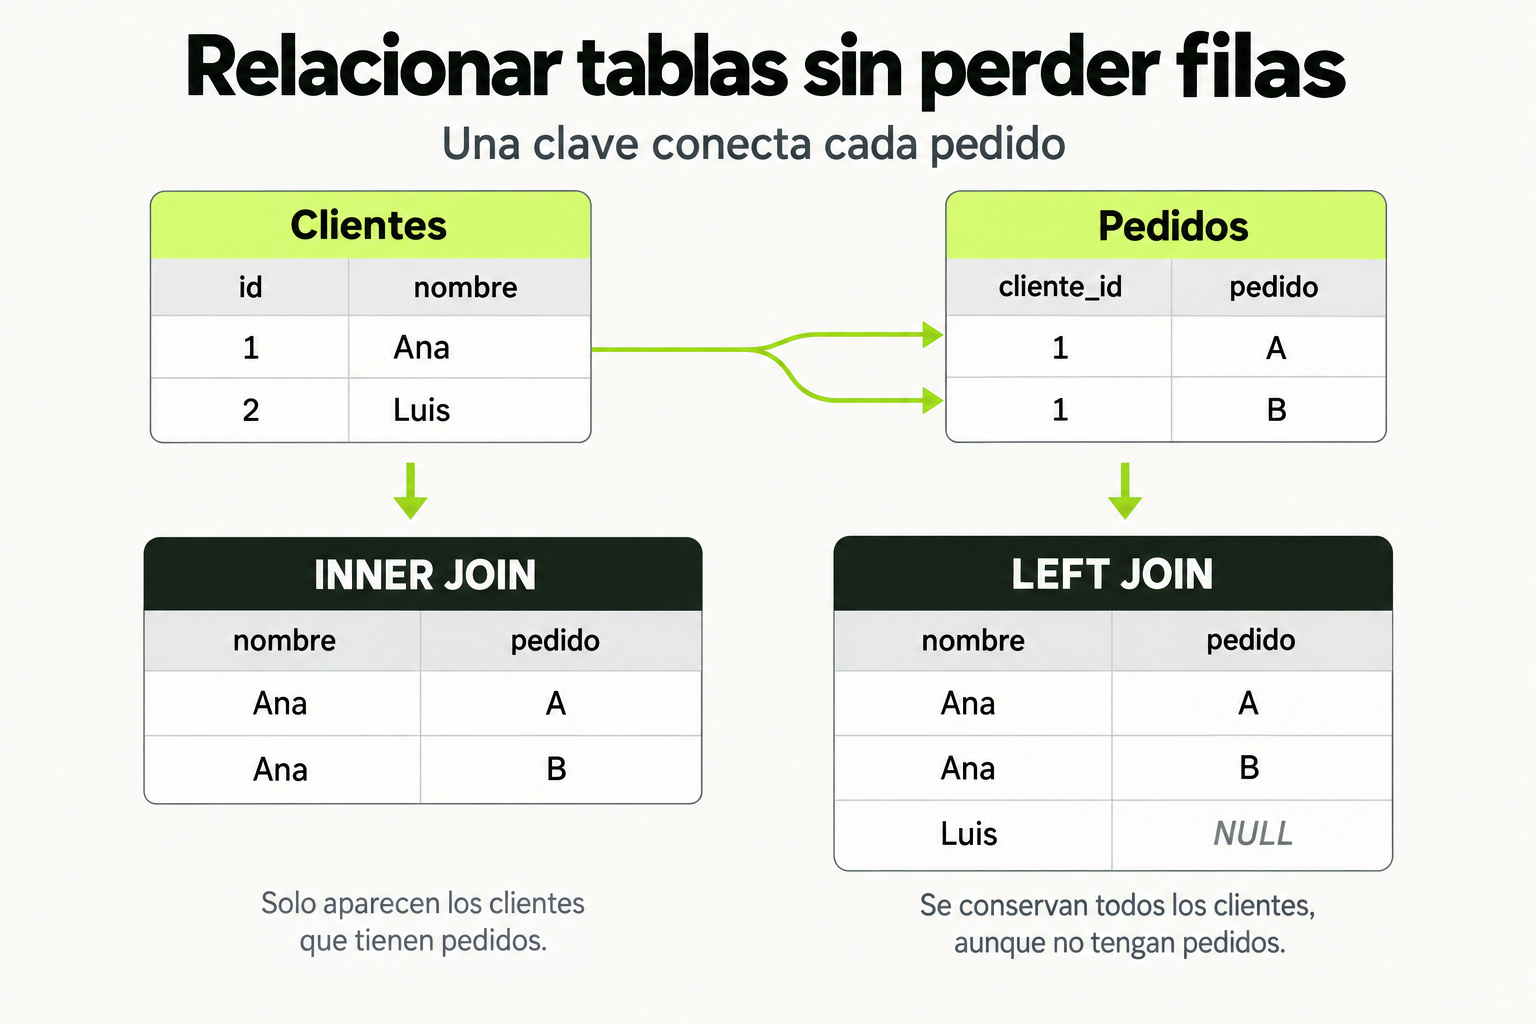
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Concepto clave
Los cuellos de botella en PostgreSQL son puntos de estrangulamiento que limitan el rendimiento de tu base de datos bajo alta concurrencia. Imagina una autopista con múltiples carriles que se reduce a uno: aunque tengas muchos vehículos (consultas) listos para avanzar, solo uno puede pasar a la vez, creando un embotellamiento. En PostgreSQL, estos cuellos de botella suelen manifestarse como esperas excesivas en locks, I/O del disco, o uso intensivo de CPU.
Diagnosticar cuellos de botella no es solo identificar consultas lentas, sino entender por qué son lentas bajo carga concurrente. Un query que funciona bien en aislamiento puede colapsar cuando 100 usuarios lo ejecutan simultáneamente debido a contención de recursos. La clave está en monitorear métricas en tiempo real y correlacionarlas con el comportamiento de la aplicación.
Cómo funciona en la práctica
El diagnóstico sigue un flujo sistemático: primero, identifica síntomas como alto tiempo de respuesta o aumento de conexiones inactivas. Luego, usa herramientas nativas de PostgreSQL para profundizar. Por ejemplo, si notas que las transacciones se bloquean, consulta la vista pg_stat_activity para ver qué procesos están esperando y por qué.
Paso a paso: 1) Monitorea el sistema con pg_stat_database para ver tasas de transacciones y bloqueos. 2) Identifica queries problemáticos con pg_stat_statements. 3) Analiza esperas con pg_locks y pg_stat_activity. 4) Correlaciona con métricas del sistema como uso de CPU y I/O. Un caso típico: muchas sesiones esperando en Lock: transactionid indica contención por actualizaciones frecuentes en las mismas filas.
Código en acción
Consulta para identificar las 5 consultas más costosas bajo concurrencia, usando la extensión pg_stat_statements (debes habilitarla primero):
-- Habilitar pg_stat_statements en postgresql.conf (requiere reinicio)
-- shared_preload_libraries = 'pg_stat_statements'
-- Luego en la base de datos:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;

-- Consulta para top 5 queries por tiempo total ejecutado
SELECT queryid, query, calls, total_exec_time, mean_exec_time,
       rows / calls as avg_rows, shared_blks_hit, shared_blks_read
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 5;
Antes y después de optimizar un índice: Antes, un query sin índice adecuado causa escaneos secuenciales; después, con un índice B-tree, se reduce drásticamente el tiempo. Ejemplo de mejora:
-- ANTES: Query lento por falta de índice
SELECT * FROM orders WHERE user_id = 123 AND status = 'pending';
-- Explicación muestra Seq Scan
EXPLAIN ANALYZE SELECT * FROM orders WHERE user_id = 123 AND status = 'pending';

-- DESPUÉS: Crear índice compuesto
CREATE INDEX idx_orders_user_status ON orders(user_id, status);
-- Explicación ahora muestra Index Scan
EXPLAIN ANALYZE SELECT * FROM orders WHERE user_id = 123 AND status = 'pending';
Errores comunes
- No monitorear en producción: asumir que el rendimiento en desarrollo refleja la carga real. Solución: implementa monitoreo continuo con herramientas como pg_stat_statements y exporta métricas a sistemas como Prometheus.
- Ignorar la contención de locks: enfocarse solo en tiempo de CPU y dejar que las transacciones largas bloqueen otras. Solución: usa
LOCK_TIMEOUTy diseña transacciones cortas. - Sobrecargar índices: crear índices para cada query sin considerar el overhead en escrituras. Solución: analiza el balance entre lectura y escritura con
pg_stat_user_indexes. - No considerar el plan de ejecución bajo concurrencia: un plan óptimo para un solo usuario puede degradarse con múltiples sesiones. Solución: usa
EXPLAIN ANALYZEcon cargas simuladas. - Descuidar la configuración de memoria: valores bajos en
shared_buffersowork_memcausan I/O excesivo. Solución: ajusta según la carga y hardware, monitoreando hit ratios.
Checklist de dominio
- ¿Puedes identificar las 3 consultas más costosas en tu base de datos usando pg_stat_statements?
- ¿Sabes interpretar la salida de
EXPLAIN ANALYZEpara detectar escaneos secuenciales o joins ineficientes? - ¿Puedes listar las sesiones bloqueadas y el tipo de lock involucrado usando pg_locks?
- ¿Has ajustado parámetros de memoria (shared_buffers, work_mem) basado en métricas de hit ratio?
- ¿Implementas timeouts (lock_timeout, statement_timeout) para prevenir bloqueos infinitos?
- ¿Monitoreas tasas de transacciones y rollbacks en pg_stat_database?
- ¿Evalúas el impacto de nuevos índices en el rendimiento de escritura?
Simulación y Diagnóstico de Contención de Locks en una Tabla de Pedidos
En este ejercicio, simularás un escenario de alta concurrencia en una tabla de pedidos y diagnosticarás cuellos de botella causados por locks. Sigue estos pasos:
- Crea una base de datos de prueba llamada
diagnostico_locksy una tablapedidoscon columnas:id (SERIAL PRIMARY KEY),usuario_id (INT),monto (DECIMAL),estado (VARCHAR). - Inserta 1000 filas de datos de ejemplo con estados variados ('pendiente', 'completado', 'cancelado').
- En dos sesiones de psql simultáneas, ejecuta transacciones que actualicen el mismo pedido (ej:
UPDATE pedidos SET monto = monto + 10 WHERE id = 1;) y observa el bloqueo. - Usa la consulta
SELECT * FROM pg_locks WHERE NOT granted;para identificar locks en espera. - Analiza
pg_stat_activitypara ver las sesiones bloqueadas y sus queries. - Propón una solución, como usar
LOCK_TIMEOUTo rediseñar la transacción, y prueba su impacto.
Pistas
- Usa
BEGIN;yCOMMIT;para manejar transacciones explícitas en las sesiones. - Consulta la documentación de PostgreSQL sobre lock modes para entender los tipos de locks mostrados.
- Considera usar índices para reducir el tiempo de búsqueda en updates frecuentes.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.