

Lección 23 de 25 · Lectura y práctica
Configuración de Replicación para el Proyecto
Concepto claveLa replicación en PostgreSQL es el proceso de mantener copias sincronizadas de una base de datos principal (master) en uno o más servidores secundarios (réplicas). Imagina una cadena de restaurantes: la cocina.
Del concepto a la práctica
Taller de esta lección
En el proyecto, la réplica no debe recibir indiscriminadamente todas las consultas. Primero se define qué datos puede leer con retraso y cómo se verifica la posición aplicada. La configuración física conserva el estado transaccional del conjunto, pero no elimina la necesidad de monitorizar WAL, capacidad de almacenamiento y reconexión.
Ejemplo resuelto
El mapa público de asientos puede consultar una réplica si acepta unos segundos de retraso; la confirmación de una reserva recién creada debe consultar el primary. La aplicación registra el nodo usado y una marca de lectura para poder explicar una discrepancia.
Enumera consultas de lectura del proyecto.
Marca las que requieren lectura posterior a escritura.
Verifica retraso antes de habilitar la ruta secundaria.
Prueba caída de la réplica sin perder la ruta primaria.
Error frecuente: considerar que una réplica disponible siempre está actualizada. Corrección: combina estado de conexión con posición o tiempo de aplicación.
El mapa público representa disponibilidad aproximada y la respuesta debe declararlo. El usuario no obtiene una garantía de compra porque la réplica mostró libre. Define un umbral de lag para retirar la réplica del balanceador y un fallback a primary acotado para no sobrecargarlo. Fija cada tolerancia como requisito del ejercicio, no como una regla universal de unos segundos.
Pruébalo
Clasifica “mapa público”, “mis reservas tras pagar” y “contador administrativo diario”. Define nodo y tolerancia para cada uno.
Comprueba tu resultado
El mapa puede usar réplica; “mis reservas” debe usar primary o una garantía de lectura; el contador puede usar réplica si documenta retraso aceptable.
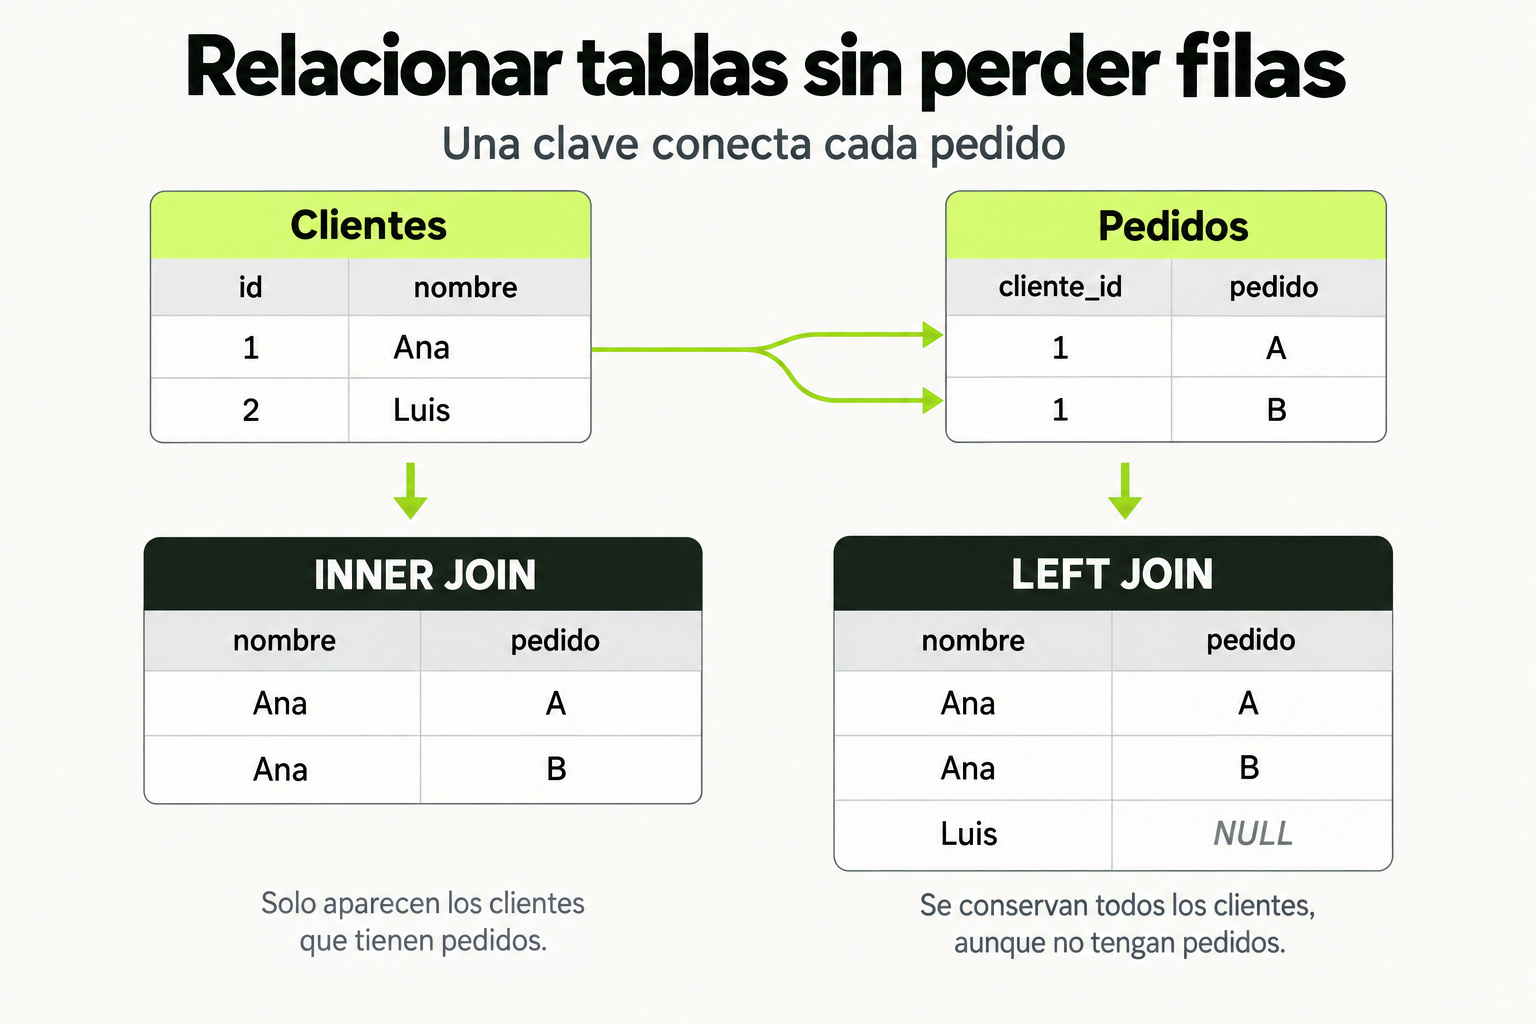
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Concepto clave
La replicación en PostgreSQL es el proceso de mantener copias sincronizadas de una base de datos principal (master) en uno o más servidores secundarios (réplicas). Imagina una cadena de restaurantes: la cocina central (master) prepara los platos, y las sucursales (réplicas) reciben copias exactas para servir a los clientes locales. En sistemas de reservas de alta demanda, esto permite distribuir la carga de lectura, mejorar la disponibilidad y crear copias de seguridad en tiempo real.
Existen dos enfoques principales: replicación física (streaming replication) que copia los cambios a nivel de archivos WAL, y replicación lógica que replica cambios específicos de tablas. Para nuestro proyecto de reservas, usaremos replicación física por su eficiencia y consistencia transaccional. La analogía sería transmitir en vivo un evento deportivo: cada acción se envía inmediatamente a todas las pantallas (réplicas) manteniendo sincronización perfecta.
Cómo funciona en la práctica
Configurar replicación en PostgreSQL implica tres pasos principales: preparar el servidor principal, configurar las réplicas y establecer la conexión. Primero, en el master, habilitamos la replicación modificando postgresql.conf y pg_hba.conf. Luego, creamos un usuario de replicación y tomamos un backup base. Finalmente, en cada réplica, restauramos ese backup y configuramos recovery.conf para conectarse al master.
Para nuestro sistema de reservas, implementaremos una topología de 1 master y 2 réplicas. El master manejará todas las escrituras (crear/modificar reservas), mientras las réplicas servirán consultas de lectura (listar reservas, ver disponibilidad). Esto distribuye la carga durante picos de demanda, como cuando miles de usuarios consultan disponibilidad simultáneamente.
Código en acción
Configuración del servidor principal (master):
-- En el master, crear usuario de replicación
CREATE USER replicator WITH REPLICATION ENCRYPTED PASSWORD 'SecurePass123!';

-- Verificar configuración actual
SELECT name, setting FROM pg_settings WHERE name LIKE '%wal%' OR name LIKE '%max_wal_senders%';

-- Modificar postgresql.conf (ejemplo de líneas clave)
# listen_addresses = '*'
# wal_level = replica
# max_wal_senders = 3
# wal_keep_size = 1GB

-- Modificar pg_hba.conf para permitir conexiones de réplicas
# host replication replicator 192.168.1.0/24 md5
Configuración de una réplica:
# En la réplica, detener PostgreSQL si está corriendo
sudo systemctl stop postgresql

# Eliminar directorio de datos existente
sudo rm -rf /var/lib/postgresql/14/main/*

# Tomar backup base desde el master
pg_basebackup -h 192.168.1.100 -D /var/lib/postgresql/14/main -U replicator -P -v -R -X stream -C -S replica_1

# Verificar archivo standby.signal generado automáticamente
ls -la /var/lib/postgresql/14/main/standby.signal

# Iniciar PostgreSQL en modo réplica
sudo systemctl start postgresql

# Verificar estado de replicación
SELECT client_addr, state, sync_state FROM pg_stat_replication;
Errores comunes
- No configurar wal_keep_size adecuadamente: Si el master elimina archivos WAL antes de que las réplicas los reciban, se rompe la replicación. Solución: calcular wal_keep_size basado en el tráfico esperado (mínimo 1GB para sistemas activos).
- Permisos incorrectos en pg_hba.conf: Error típico "no pg_hba.conf entry for host". Verificar que la dirección IP de la réplica esté correctamente listada y con método md5.
- Olvidar el parámetro -R en pg_basebackup: Sin -R, no se crea standby.signal y la réplica no inicia en modo standby. Siempre incluir -R o crear el archivo manualmente.
- No monitorear el lag de replicación: Las réplicas pueden desincronizarse sin alertas. Implementar monitoreo con:
SELECT pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replication_lag FROM pg_stat_replication; - Usar la misma configuración de memoria en master y réplicas: Las réplicas necesitan menos shared_buffers ya que solo manejan lecturas. Ajustar según el rol: master para escrituras, réplicas para lecturas.
Checklist de dominio
- Puedo explicar la diferencia entre replicación física y lógica y cuándo usar cada una
- He configurado exitosamente un entorno con 1 master y al menos 2 réplicas funcionando
- Sé cómo diagnosticar y resolver un lag de replicación mayor a 1MB
- Puedo promover una réplica a master en caso de falla del servidor principal
- Implementé monitoreo básico que alerta cuando la replicación se detiene
- Optimicé parámetros de memoria (shared_buffers, work_mem) diferenciando entre master y réplicas
- Documenté el procedimiento de recuperación ante desastres incluyendo replicación
Configuración de un entorno de replicación para el sistema de reservas
Implementa un entorno de replicación PostgreSQL para simular el sistema de reservas de alta demanda. Sigue estos pasos:
- Configura un servidor PostgreSQL como master en tu entorno local o en contenedores Docker
- Crea la base de datos
reservas_sistemacon una tablareservasque incluya: id, usuario_id, fecha_reserva, estado - Configura dos servidores adicionales como réplicas del master
- Inserta 1000 registros de prueba en el master y verifica que se repliquen en ambas réplicas
- Simula una carga de lectura: ejecuta consultas SELECT concurrentes en las réplicas mientras insertas datos en el master
- Mide el performance comparando tiempos de respuesta con y sin replicación
- Documenta el proceso completo incluyendo problemas encontrados y soluciones aplicadas
Pistas
- Usa Docker para crear rápidamente múltiples instancias de PostgreSQL
- Para medir performance, considera usar pgbench o scripts simples con tiempos de ejecución
- No olvides configurar la autenticación correctamente entre servidores
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.