

Lección 18 de 25 · Lectura y práctica
Balanceo de Carga con Lecturas Replicadas
Concepto claveEl balanceo de carga con lecturas replicadas es una estrategia de arquitectura que distribuye las consultas de lectura entre múltiples réplicas de PostgreSQL, mientras mantiene todas las escrituras en un nodo.
Del concepto a la práctica
Taller de esta lección
Enviar lecturas a réplicas distribuye trabajo, pero introduce consistencia eventual. Una lectura inmediatamente posterior a una escritura puede regresar datos antiguos si cae en un standby que aún no aplicó el WAL. La aplicación debe clasificar operaciones: lecturas tolerantes a retraso pueden balancearse; confirmaciones, disponibilidad y decisiones monetarias deben usar una fuente consistente.
Ejemplo resuelto
Un usuario crea una reserva en el primary y luego consulta “mis reservas”. La aplicación mantiene afinidad temporal con el primary durante esa sesión; en cambio, una página pública de eventos puede leer desde una réplica si muestra su marca de retraso.
Clasifica cada endpoint por consistencia.
Mide retraso antes de elegir réplica.
Enruta escrituras y lecturas sensibles al primary.
Expone una política para lecturas antiguas.
Error frecuente: repartir todas las lecturas por igual. Corrección: balancea solo las que toleran retraso y conserva ruta consistente para las demás.
Afinidad temporal por sí sola no ofrece read-your-writes después de expirar el plazo: el lag puede durar más. Para una garantía fuerte sigue en primary o usa un mecanismo que espere una posición aplicada correspondiente a la escritura y tenga timeout/fallback. Un mapa de asientos leído de réplica es informativo, nunca autoriza disponibilidad final; reserva se decide atómicamente en primary.
Pruébalo
Define cuatro operaciones: crear reserva, consultar mapa público, confirmar pago y listar historial. Clasifica cada una y justifica el nodo.
Comprueba tu resultado
Mapa público puede ir a réplica; creación, pago e historial inmediatamente posterior deben ir al primary o usar una garantía equivalente.
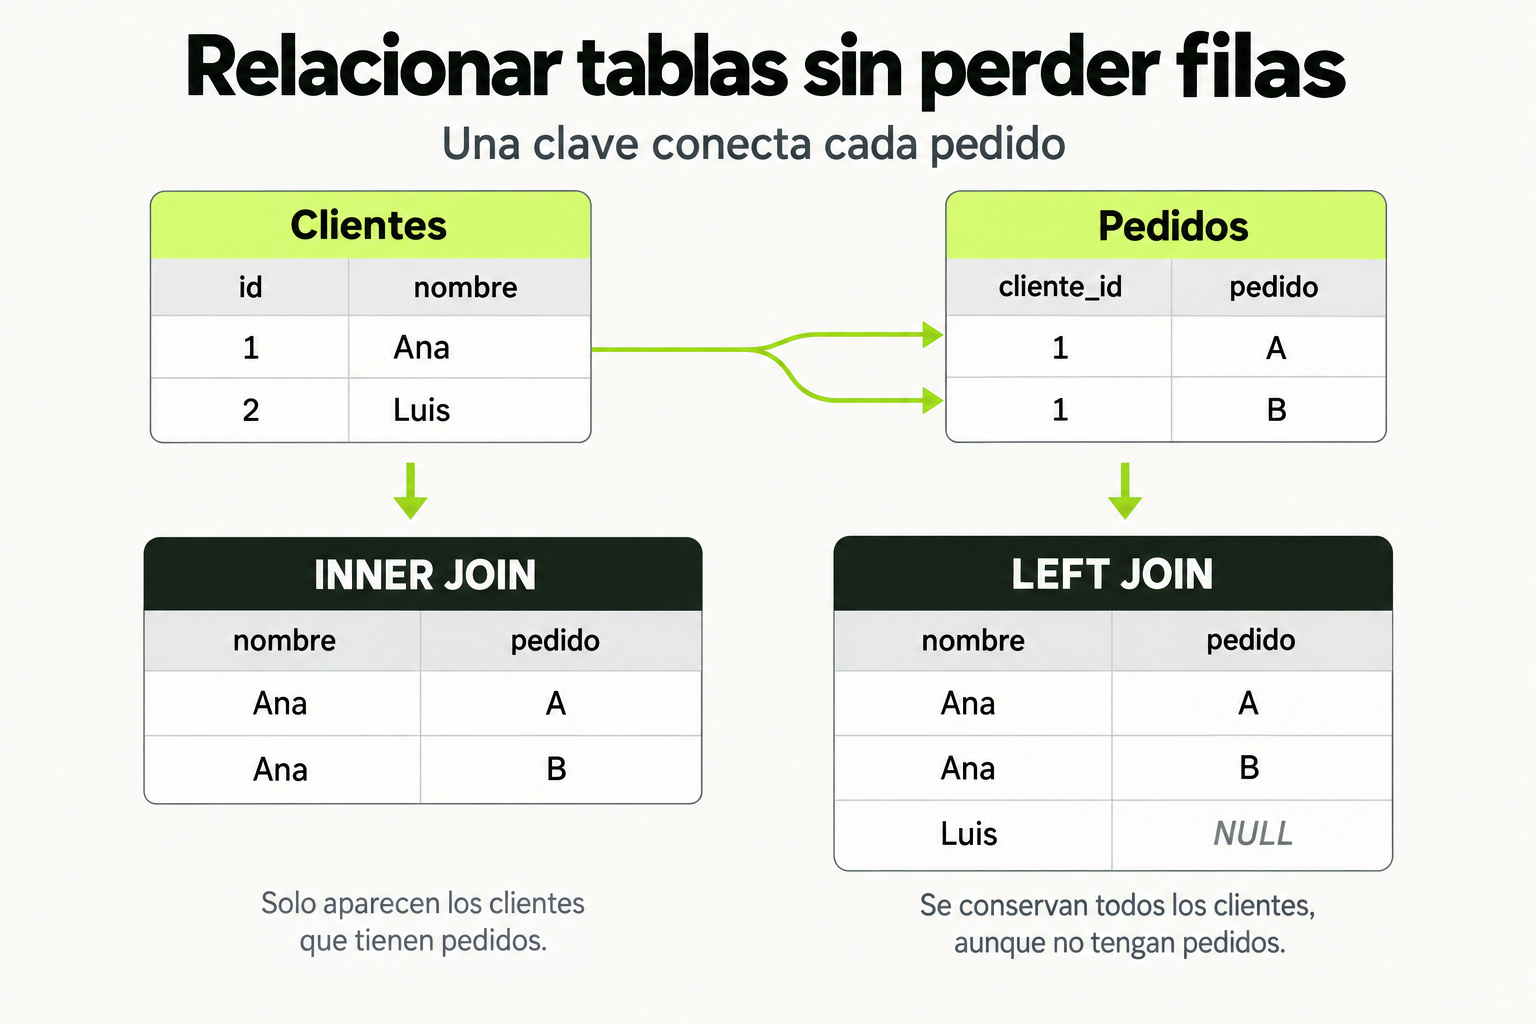
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Concepto clave
El balanceo de carga con lecturas replicadas es una estrategia de arquitectura que distribuye las consultas de lectura entre múltiples réplicas de PostgreSQL, mientras mantiene todas las escrituras en un nodo primario. Imagina una biblioteca muy concurrida: en lugar de tener un solo mostrador donde todos piden libros (lecturas) y devuelven libros (escrituras), separas las tareas. Un mostrador central maneja todas las devoluciones (escrituras para mantener consistencia), mientras que varios mostradores secundarios atienden solo préstamos (lecturas). Esto reduce la cola principal y acelera el servicio.
En aplicaciones de alta concurrencia, como plataformas de e-commerce o redes sociales, el 80-90% de las operaciones suelen ser lecturas (mostrar productos, ver perfiles). Al dirigir estas lecturas a réplicas, descargas al primario, evitando cuellos de botella y mejorando la escalabilidad horizontal. La clave está en garantizar que las réplicas estén sincronizadas (replication lag mínimo) para que los usuarios vean datos actualizados, aunque aceptando cierta latencia eventual en casos extremos.
Cómo funciona en la práctica
Implementar balanceo de carga con lecturas replicadas sigue un flujo paso a paso. Primero, configuras la replicación en PostgreSQL usando streaming replication (ej., con wal_level = replica y un standby). Luego, en tu aplicación, separas la lógica de conexión: las escrituras (INSERT, UPDATE, DELETE) van al primario, mientras las lecturas (SELECT) se distribuyen entre réplicas usando un balanceador como pgpool-II o HAProxy.
Por ejemplo, en una app web, defines dos pools de conexión en el código backend: uno para escrituras (apuntando al primario) y otro para lecturas (apuntando a una lista de réplicas). Un middleware o librería (como Spring en Java o Django en Python) enruta automáticamente las queries basándose en su tipo. Para monitoreo, herramientas como pg_stat_replication te permiten ver el lag y ajustar la distribución.
Codigo en accion
Configuración básica con pgpool-II para balancear lecturas:
# Instalación y configuración de pgpool-II en Ubuntu
sudo apt-get install pgpool2
# Editar /etc/pgpool2/pgpool.conf
backend_hostname0 = 'primary-db'
backend_port0 = 5432
backend_weight0 = 0  # Solo escrituras
backend_hostname1 = 'replica1-db'
backend_port1 = 5432
backend_weight1 = 1  # Para lecturas
backend_hostname2 = 'replica2-db'
backend_port2 = 5432
backend_weight2 = 1
load_balance_mode = on  # Habilita balanceo
# Reiniciar servicio
sudo systemctl restart pgpool2
Ejemplo en una aplicación Python con Django, usando múltiples bases de datos:
# settings.py
DATABASES = {
    'default': {
        'ENGINE': 'django.db.backends.postgresql',
        'NAME': 'mydb',
        'HOST': 'primary-db',  # Para escrituras
        'PORT': 5432,
    },
    'replicas': {
        'ENGINE': 'django.db.backends.postgresql',
        'NAME': 'mydb',
        'HOST': 'pgpool-host',  # Balanceador que apunta a réplicas
        'PORT': 9999,
    }
}
# views.py
from django.db import connections

def get_user_data(user_id):
    # Lectura desde réplica
    with connections['replicas'].cursor() as cursor:
        cursor.execute("SELECT * FROM users WHERE id = %s", [user_id])
        return cursor.fetchone()

def update_user(user_id, data):
    # Escritura en primario
    with connections['default'].cursor() as cursor:
        cursor.execute("UPDATE users SET name = %s WHERE id = %s", [data['name'], user_id])
Errores comunes
- Ignorar el replication lag: Si las réplicas están desactualizadas, los usuarios pueden ver datos obsoletos. Solución: monitorea
pg_stat_replicationy ajusta la carga o añade más réplicas. - Balancear escrituras por error: Enviar INSERT/UPDATE a una réplica causa errores, ya que son de solo lectura. Solución: configura reglas estrictas en el balanceador (ej., pgpool-II con
write_function_list). - No probar la conmutación por fallo: Si el primario cae, las réplicas deben poder promoverse. Solución: realiza drills regulares con herramientas como repmgr.
- Sobrecargar una réplica: Asignar todo el tráfico a una sola réplica anula el balanceo. Solución: usa pesos dinámicos y health checks.
- Olvidar la consistencia de sesión: En aplicaciones donde un usuario realiza lecturas y escrituras rápidas, puede haber inconsistencia si cambia de réplica. Solución: implementa sticky sessions o retrasos controlados.
Checklist de dominio
- Configurar streaming replication en PostgreSQL con al menos una réplica sincrónica.
- Implementar un balanceador (pgpool-II o HAProxy) que distinga entre tráfico de lectura y escritura.
- Modificar la aplicación para usar múltiples conexiones a bases de datos basadas en el tipo de query.
- Monitorear el lag de replicación y el rendimiento usando
pg_stat_replicationy herramientas como Prometheus. - Probar la conmutación por fallo y la redistribución de carga automática.
- Optimizar queries de lectura para evitar bloqueos que afecten a las réplicas.
- Documentar la estrategia de balanceo y los procedimientos de recuperación ante desastres.
Implementar balanceo de carga en una app existente
En este ejercicio, tomarás una aplicación PostgreSQL existente y configurarás balanceo de carga con lecturas replicadas. Sigue estos pasos:
- Prepara el entorno: Asegúrate de tener al menos dos instancias de PostgreSQL (una primaria y una réplica) corriendo. Usa contenedores Docker o máquinas virtuales para simularlo.
- Configura la replicación: En el primario, habilita la replicación streaming ajustando
postgresql.conf(wal_level, max_wal_senders) y crea un usuario de replicación. En la réplica, configurarecovery.confpara conectarse al primario. - Instala y configura pgpool-II: Instala pgpool-II en un nodo separado o en el mismo que la aplicación. Edita
pgpool.confpara definir los backends (primario y réplica) y habilitaload_balance_mode. - Modifica la aplicación: En el código de la app (ej., en Python con psycopg2 o Django), separa las conexiones. Usa el primario para escrituras y pgpool-II para lecturas. Implementa un middleware que detecte el tipo de query.
- Prueba y monitorea: Ejecuta consultas de lectura y escritura, verificando que se dirijan a los nodos correctos. Usa
pg_stat_activitypara confirmar. Mide el rendimiento antes y después.
Pistas
- Usa Docker Compose para levantar rápidamente múltiples instancias de PostgreSQL.
- En pgpool-II, configura backend_weight0 = 0 para el primario si solo quieres que maneje escrituras.
- Prueba con una herramienta como pgbench para generar carga y ver el balanceo en acción.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.