

Lección 14 de 20 · Lectura y práctica
Manejo de errores y flujos de fallback
Concepto claveEn el desarrollo de agentes de IA con LangGraph, el manejo de errores y flujos de fallback no es solo una característica opcional, sino el sistema nervioso que permite a tu agente adaptarse a un mundo imperfecto..
Del concepto a la práctica
Taller de esta lección
Un fallback útil conserva el contexto suficiente para diagnosticar, limita los reintentos y ofrece una salida segura. No debe ocultar un error como si fuera una respuesta correcta. En este patrón, un fallo transitorio permite un segundo intento; un fallo de validación deriva directamente.
Ejemplo resuelto
def siguiente(s):
    if s["resultado"] == "ok":
        return "continuar"
    if s["error"] == "transitorio" and s["reintentos"] < 1:
        return "reintentar"
    return "derivar"

print(siguiente({"resultado": "error", "error": "transitorio", "reintentos": 0}))
# reintentar
La llamada inicial no cuenta como reintento: inicial+un reintento suman dos llamadas. Incrementa reintentos al programar el segundo intento y limita también tiempo total/recursión del grafo. Reintenta lecturas idempotentes transitorias; una mutación de resultado desconocido necesita ID estable y reconciliación, no una segunda ejecución ciega.
Pruébalo
Registra el tipo de error y el contador.
Permite solo un reintento transitorio.
Envía errores permanentes a derivación.
Conserva la entrada original en la traza.
Un error frecuente es reintentar cualquier excepción indefinidamente. Corrígelo clasificando errores y aplicando una condición de parada explícita.
Comprueba tu resultado
Un error transitorio con cero reintentos ya usados produce reintentar; con un reintento ya usado produce derivar. Un error validacion produce derivar desde el primer intento.
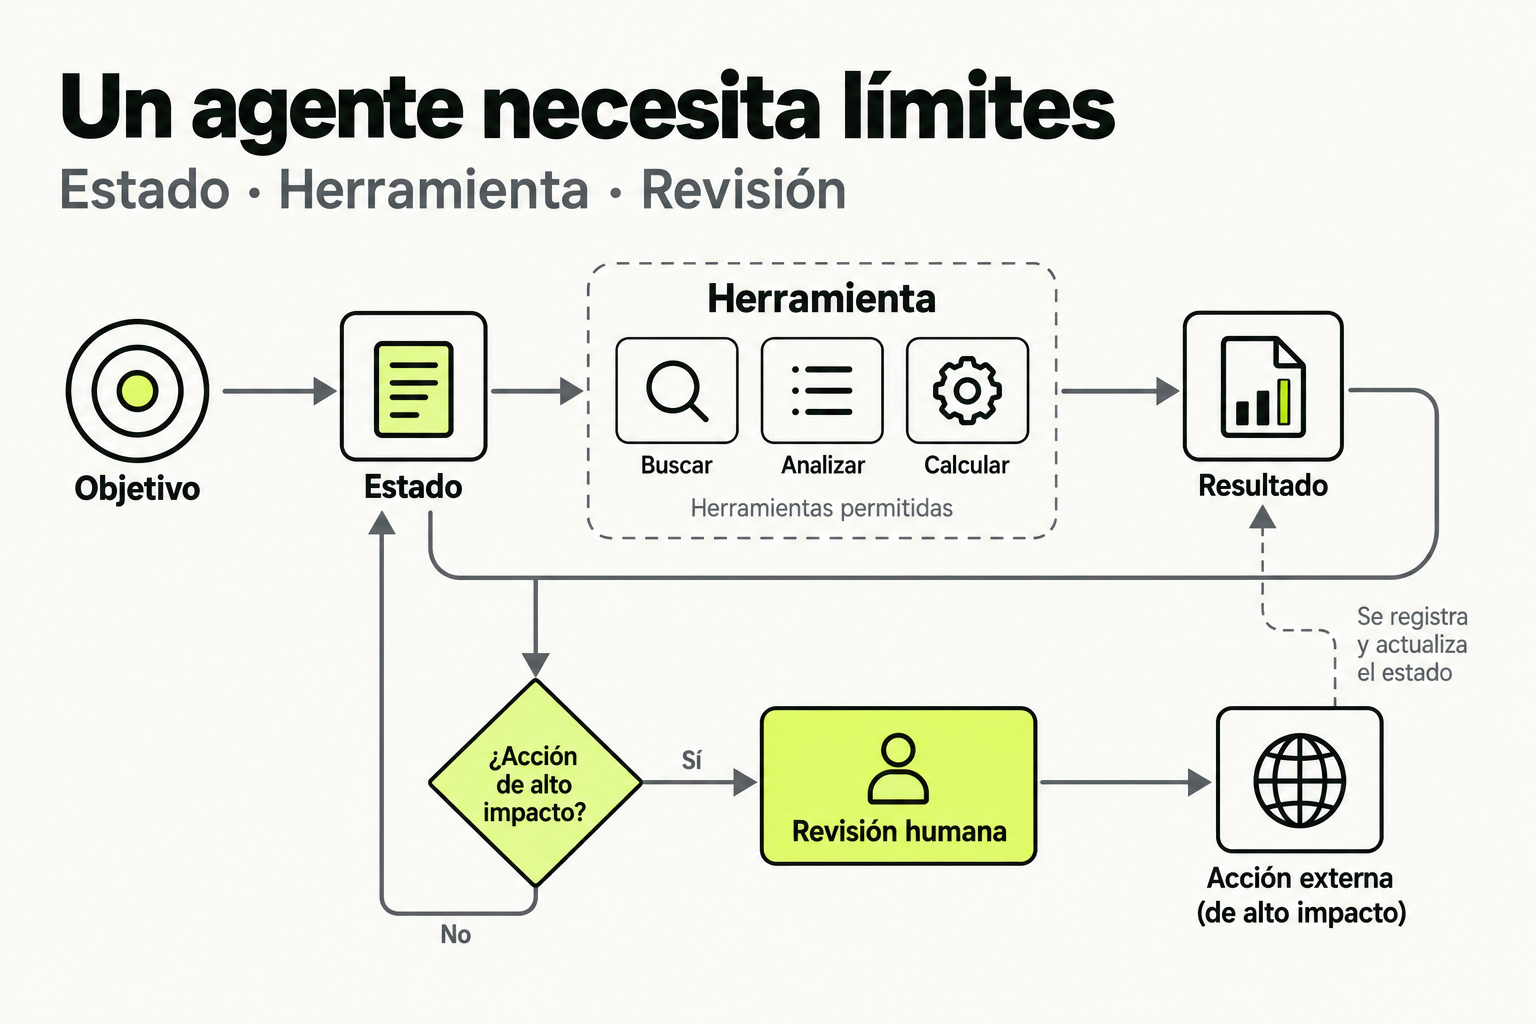
 Mapa de práctica
Un agente mantiene un estado y utiliza herramientas dentro de límites definidos. El resultado de cada herramienta actualiza ese estado para decidir el siguiente paso. Las acciones de alto impacto deben pasar por una revisión humana antes de ejecutarse.
Ver la infografía en tamaño completo ↗Concepto clave
En el desarrollo de agentes de IA con LangGraph, el manejo de errores y flujos de fallback no es solo una característica opcional, sino el sistema nervioso que permite a tu agente adaptarse a un mundo imperfecto. Piensa en un conductor experto: no solo sabe seguir la ruta ideal, sino que tambien anticipa desvíos, fallos mecánicos o condiciones climáticas adversas, teniendo siempre un plan B, C y D listo para ejecutar.
En LangGraph, esto se traduce en diseñar grafos que no se rompan ante errores de herramientas, respuestas inesperadas de modelos de lenguaje, o estados de memoria corruptos. Un flujo de fallback efectivo actúa como un paracaídas de contingencia: cuando una rama del grafo falla, el sistema redirige el flujo hacia una ruta alternativa que puede recuperar, registrar o reiniciar la operación sin perder el contexto completo.
"Un agente sin manejo de errores es como un barco sin botes salvavidas: puede navegar en aguas tranquilas, pero un solo fallo lo hunde."
Cómo funciona en la práctica
Imagina que estás construyendo un agente que analiza informes financieros usando herramientas de búsqueda en bases de datos y APIs externas. El grafo básico podría verse así:
- Recibir consulta del usuario
- Buscar en memoria histórica
- Ejecutar herramienta de búsqueda en base de datos
- Procesar resultados con LLM
- Generar respuesta
Ahora, añadimos manejo de errores:
from langgraph.graph import StateGraph, END
from typing import TypedDict

class AgentState(TypedDict):
    query: str
    memory: list
    tool_results: dict
    error: str
    fallback_activated: bool

def tool_execution(state):
    try:
        # Lógica de herramienta
        result = call_external_api(state['query'])
        return {'tool_results': result, 'error': None}
    except Exception as e:
        return {'tool_results': None, 'error': str(e), 'fallback_activated': True}

def fallback_strategy(state):
    if state['error']:
        # 1. Registrar error en memoria
        # 2. Usar datos cacheados
        # 3. Reformular consulta
        return {'response': 'Usando datos alternativos...', 'fallback_activated': False}
    return {'response': state['tool_results']}

workflow = StateGraph(AgentState)
workflow.add_node('tool_execution', tool_execution)
workflow.add_node('fallback', fallback_strategy)
workflow.add_conditional_edges(
    'tool_execution',
    lambda state: 'fallback' if state['error'] else END,
    {'fallback': 'fallback', END: END}
)
workflow.set_entry_point('tool_execution')
Este diseño permite que cuando la API falle, el grafo automáticamente redirija a una estrategia de fallback que puede usar datos cacheados o reformular la consulta.
Caso de estudio
Vamos a examinar un agente de soporte técnico para una plataforma SaaS. Este agente usa:
- Memoria: Historial de tickets del usuario
- Herramientas: Base de conocimiento, API de monitoreo, sistema de tickets
- Lógica condicional: Decide qué herramienta usar basado en la urgencia
Implementamos un sistema de fallback de tres niveles:
| Nivel | Error | Acción de fallback | Tiempo de recuperación |
|---|---|---|---|
| 1 | API de monitoreo caída | Usar último estado cacheado + notificar | < 2 segundos |
| 2 | Base de conocimiento no responde | Buscar en documentación local + escalar a humano | < 5 segundos |
| 3 | LLM produce respuesta inválida | Reintentar con prompt modificado + límite de intentos | < 10 segundos |
La implementación en LangGraph incluye nodos condicionales que evalúan códigos de error y redirigen el flujo hacia el nivel apropiado de fallback, manteniendo siempre una respuesta al usuario dentro de los límites de SLA.
Errores comunes
- Fallback infinito: Crear ciclos donde el fallback llama a otra función que también falla. Solución: Implementar contadores de intentos y límites máximos de recursión.
- Pérdida de contexto: Al activar fallback, no preservar la información útil ya obtenida. Solución: Diseñar estados que retengan datos parciales y metadatos de error.
- Silenciar errores críticos: Usar try-catch demasiado amplio que oculta problemas de infraestructura. Solución: Diferenciar entre errores recuperables (timeouts) y no recuperables (autenticación).
- Fallback demasiado genérico: Respuestas como "Ha ocurrido un error" sin valor para el usuario. Solución: Personalizar mensajes de fallback con información específica del contexto.
- No probar caminos de fallback: Asumir que funcionarán sin pruebas reales. Solución: Implementar pruebas que simulen fallos de cada herramienta y validen los flujos alternativos.
Checklist de dominio
- ¿Tu grafo maneja al menos tres tipos diferentes de errores (herramientas, LLM, memoria)?
- ¿Los flujos de fallback mantienen coherencia con el estado anterior del agente?
- ¿Has implementado límites de reintentos para evitar loops infinitos?
- ¿Los mensajes de error son informativos para debugging pero seguros para usuarios finales?
- ¿Has probado cada camino de fallback con datos realistas de error?
- ¿El sistema registra métricas de activación de fallback para monitoreo?
- ¿Existe una ruta de escalación final cuando todos los fallbacks fallan?
Implementación de un sistema de fallback multi-nivel para agente de reservas
Construye un agente de reservas de vuelos con LangGraph que implemente un sistema de fallback de tres niveles. Sigue estos pasos:
- Define el estado del agente: Crea una clase TypedDict que incluya: query_usuario, resultados_busqueda, error_actual, nivel_fallback_activado, intentos_realizados.
- Implementa tres herramientas simuladas:
- busqueda_vuelos_directos(): Simula búsqueda en API principal (falla 30% del tiempo)
- busqueda_vuelos_alternativos(): Simula búsqueda en API secundaria
- busqueda_historico(): Usa datos cacheados de últimas 24h
- Diseña el grafo con nodos condicionales:
- Nodo principal intenta busqueda_vuelos_directos
- Si falla (error o timeout), activa nivel 1: busqueda_vuelos_alternativos
- Si nivel 1 falla, activa nivel 2: busqueda_historico
- Si nivel 2 falla, nivel 3: respuesta predefinida + escalar a humano
- Añade mecanismos de seguridad:
- Límite de 2 intentos por nivel
- Registro de errores en memoria del agente
- Tiempo máximo de 10 segundos por búsqueda
- Prueba con casos específicos:
- Simula fallo en API principal pero éxito en secundaria
- Simula fallo en ambas APIs pero éxito en histórico
- Simula fallo total y verifica escalación correcta
Entrega el código completo del grafo y muestra cómo maneja al menos dos escenarios de error diferentes.
Pistas
- Usa decoradores @retry para implementar límites de reintentos de forma limpia
- Considera usar un enum para los niveles de fallback en lugar de strings
- No olvides que el estado debe preservar información entre niveles de fallback
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con LangGraph para Automatización: Memoria, Estado y Decisiones
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.