

Lección 20 de 20 · Lectura y práctica
Quiz: Evaluar la solución completa y optimizaciones
Tipo de lección: QuizConcepto claveEn un sistema de microservicios con gRPC y Protocol Buffers desplegado en Kubernetes, la evaluación de la solución completa implica analizar la eficiencia de la comunicación, la gestión de.
Del concepto a la práctica
Taller de esta lección
Optimizar una solución distribuida requiere comparar una línea base con una modificación bajo las mismas entradas. Una latencia menor no compensa errores nuevos, reintentos duplicados o un consumo que excede el recurso disponible.
Ejemplo resuelto
Base: 10 llamadas, 9 OK, 1 error, 20 ms promedio
Cambio: 10 llamadas, 10 OK, 24 ms promedio
El cambio mejora la tasa de éxito de 90% a 100%, pero aumenta 4 ms; ambas variaciones deben informarse, no ocultarse bajo una sola cifra.
Registros completos del ejemplo: base duraciones [10,10,10,10,10,10,10,10,10,110] ms, primeras nueve OK y última error; total200/10=20. Cambio: diez duraciones24 ms, todas OK; total240/10=24. Incluye los errores en esta definición del promedio y declara ese criterio. Son datos sintéticos para el quiz, no un benchmark real ni una conclusión causal; la tasa mejora10 puntos porcentuales y la latencia media aumenta20% relativo.
Pruébalo
Ejecuta exactamente diez solicitudes en la línea base.
Repite con un solo cambio documentado.
Calcula éxitos, errores y promedio usando los mismos registros.
Error frecuente: comparar ejecuciones con distinta carga y atribuir toda diferencia a la optimización. Corrección: fija entradas, duración, recursos y criterio de medición.
Comprueba tu resultado
Ejercicio: analiza los datos anteriores. Resultado esperado: mejora de 10 puntos porcentuales en éxito, aumento absoluto de 4 ms en latencia y ninguna afirmación sobre rendimiento fuera de ese laboratorio.
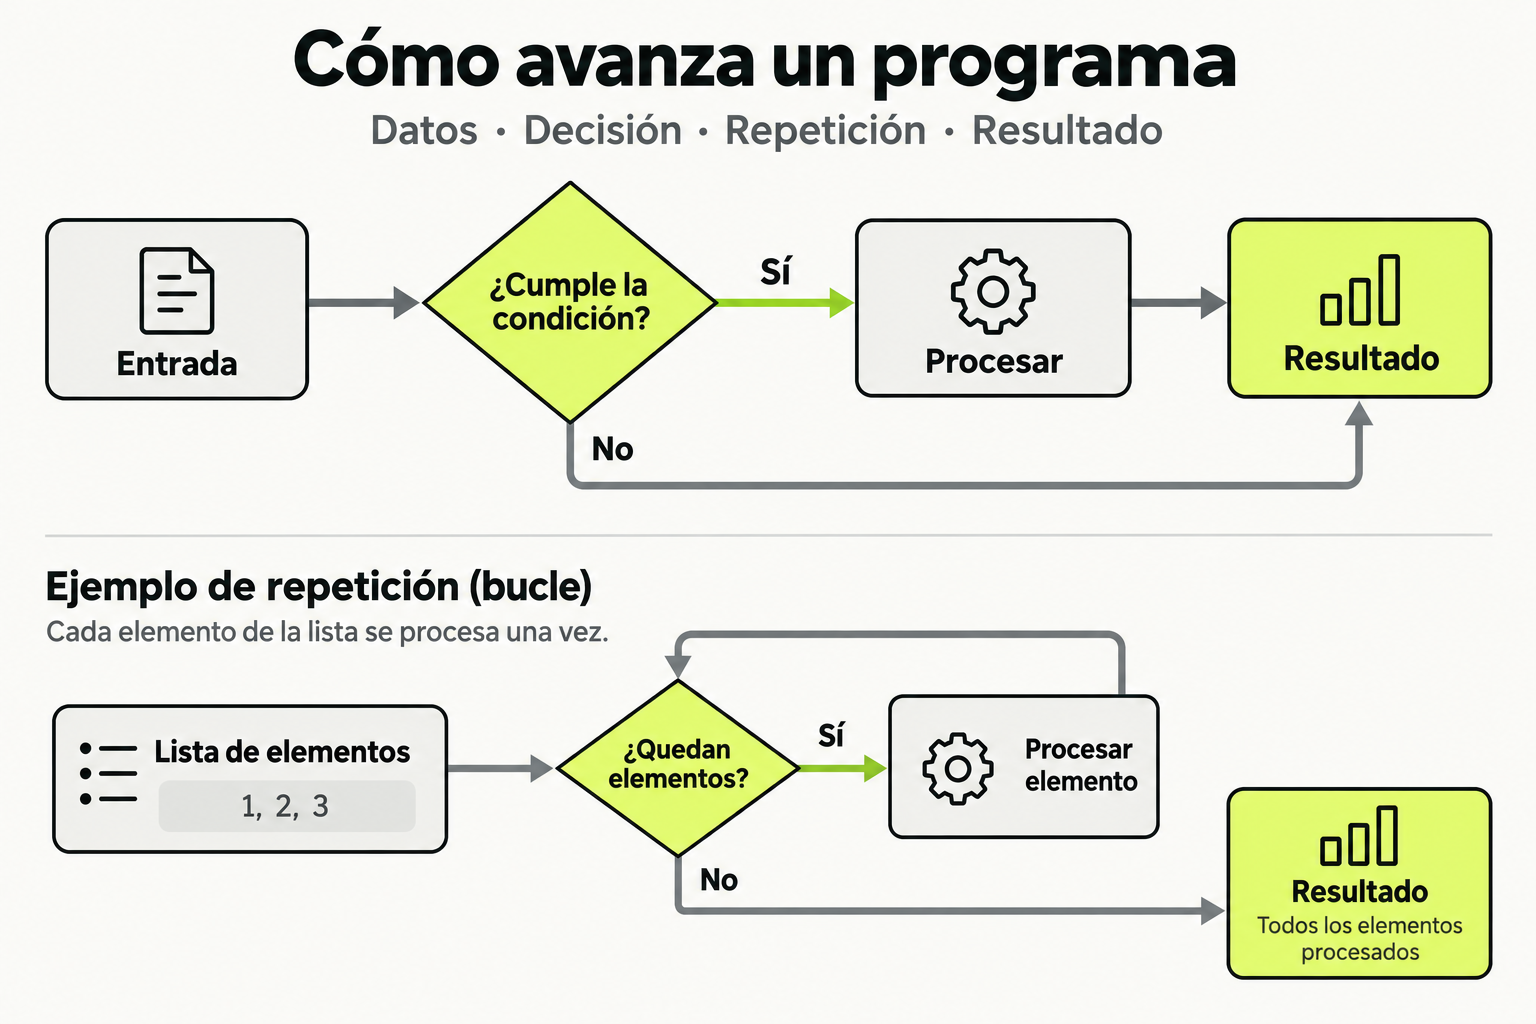
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
En un sistema de microservicios con gRPC y Protocol Buffers desplegado en Kubernetes, la evaluación de la solución completa implica analizar la eficiencia de la comunicación, la gestión de recursos y la resiliencia del sistema. Imagina una red de mensajería entre oficinas: cada oficina (microservicio) envía paquetes (llamadas gRPC) con instrucciones precisas (protobufs) a través de rutas optimizadas (Kubernetes). La optimización busca reducir la latencia, minimizar el uso de CPU/memoria y garantizar que los paquetes lleguen incluso si una ruta falla.
La clave está en el balance entre rendimiento y complejidad. Un sistema bien optimizado usa streaming bidireccional para flujos de datos continuos, timeouts y retries configurados para manejar fallos, y compresión de protobufs para reducir el tamaño de los mensajes. En Kubernetes, esto se traduce en configurar liveness probes para monitorear la salud de los servicios y ajustar los recursos (CPU/memoria) según la carga.
Cómo funciona en la práctica
Para evaluar y optimizar, sigue estos pasos:
- Monitorear métricas: Usa herramientas como Prometheus para rastrear latencia de gRPC, tasa de errores y uso de recursos por pod en Kubernetes.
- Analizar protobufs: Revisa las definiciones de mensajes en archivos .proto; optimiza eliminando campos innecesarios o usando tipos más eficientes (ej., int32 en lugar de string para IDs).
- Configurar gRPC: Ajusta parámetros como max_message_size y enable_http2 en el servidor y cliente para evitar cuellos de botella.
- Ajustar Kubernetes: Define requests y limits de recursos en los deployments, y configura liveness/readiness probes basadas en endpoints gRPC.
- Probar resiliencia: Simula fallos con chaos engineering (ej., matar pods) y verifica que los retries y circuit breakers funcionen.
Ejemplo de métricas clave en una tabla:
| Métrica | Valor objetivo | Herramienta |
|---|---|---|
| Latencia gRPC p95 | < 100ms | Prometheus |
| Error rate | < 0.1% | Grafana |
| CPU uso por pod | < 70% | Kubernetes Dashboard |
Caso de estudio
Una plataforma de e-commerce con microservicios para pedidos, inventario y pagos usa gRPC sobre Kubernetes. El problema: alta latencia en picos de tráfico (Black Friday).
Solución aplicada:
- Optimización de protobufs: Se redujo el tamaño de mensajes de pedidos en un 30% usando campos opcionales y enums.
- Configuración gRPC: Se implementó streaming para actualizaciones de inventario en tiempo real, reduciendo llamadas HTTP repetitivas.
- Kubernetes tuning: Se ajustaron los HPA (Horizontal Pod Autoscalers) basados en métricas gRPC, escalando de 5 a 20 pods bajo carga.
- Resultado: Latencia reducida de 200ms a 50ms, y cero downtime durante el evento.
En sistemas avanzados, la optimización continua es clave; revisa métricas semanalmente y ajusta basado en datos reales.
Errores comunes
- No configurar timeouts en gRPC: Causa bloqueos indefinidos en clientes. Solución: Define timeouts apropiados (ej., 5s para operaciones críticas).
- Usar protobufs no versionados: Rompe compatibilidad entre servicios. Solución: Usa versiones semánticas en los archivos .proto y evita cambiar campos requeridos.
- Ignorar liveness probes en Kubernetes: Los pods muertos no se reinician automáticamente. Solución: Configura probes que llamen a un endpoint gRPC de salud.
- Sobredimensionar recursos en Kubernetes: Desperdicia costos. Solución: Basa requests/limits en profiling real con herramientas como kubectl top.
- No implementar retries con backoff: Aumenta errores en fallos transitorios. Solución: Usa bibliotecas como grpc-retry con exponential backoff.
Checklist de dominio
- ¿Has monitoreado latencia y errores de gRPC con Prometheus/Grafana?
- ¿Optimizaste los archivos .proto para tamaño y eficiencia?
- ¿Configuraste timeouts, retries y circuit breakers en el cliente gRPC?
- ¿Ajustaste los recursos de Kubernetes (CPU/memoria) basado en métricas reales?
- ¿Implementaste liveness/readiness probes para servicios gRPC?
- ¿Probaste la resiliencia con chaos engineering en el cluster?
- ¿Documentaste los cambios y métricas para revisión continua?
Optimizar un microservicio gRPC en Kubernetes
En este ejercicio, optimizarás un microservicio existente que usa gRPC y Protocol Buffers, desplegado en un cluster Kubernetes. Sigue estos pasos:
- Clona el repositorio: Descarga el código desde
https://github.com/example/grpc-microservice. Contiene un servicio de pedidos con alta latencia. - Analiza las métricas: Usa Prometheus (preconfigurado) para identificar cuellos de botella: revisa latencia gRPC y uso de CPU por pod.
- Optimiza los protobufs: Edita el archivo
order.proto: cambia campos string a int32 donde sea posible, y marca campos opcionales si no son esenciales. - Ajusta la configuración gRPC: En
server.go, configuraMaxConcurrentStreamsa 100 yInitialWindowSizea 65535 para mejor rendimiento. - Tunea Kubernetes: Modifica el deployment en
k8s/deployment.yaml: ajusta los límites de CPU a 500m y memoria a 512Mi basado en métricas, y agrega un liveness probe que llame al endpoint gRPC/health. - Prueba y mide: Despliega los cambios con
kubectl apply, genera carga con una herramienta como ghz, y compara métricas antes/después.
Pistas
- Usa el comando kubectl top pods para ver uso de recursos en tiempo real.
- Revisa la documentación de gRPC para parámetros de optimización como keepalive.
- Considera usar grpc-middleware para agregar retries automáticamente.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Implementación Avanzada de gRPC y Protocol Buffers para Microservicios
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.