

Lección 15 de 20 · Lectura y práctica
Quiz: Evaluación de conceptos de agregaciones
Tipo de lección: QuizConcepto claveLas agregaciones en Elasticsearch son el mecanismo fundamental para realizar análisis en tiempo real sobre grandes volúmenes de datos indexados. A diferencia de las consultas de búsqueda que.
Del concepto a la práctica
Taller de esta lección
La evaluación consiste en elegir la agregación según la pregunta. Usa tres documentos: A, categoría libros, importe 12; B, libros, importe 18; C, juegos, importe 25. El total debe derivarse de esos registros y no de una cifra supuesta.
Ejemplo resuelto
sum(importe) responde ingreso total: 55. terms(categoria) crea libros y juegos; una suma anidada produce 30 y 25. avg(importe) produce 55/3 = 18.33 periódico, mientras count responde tres documentos.
Pruébalo
Escribe la métrica total.
Añade buckets por categoría.
Calcula media y conteo por separado.
Indica qué métrica usarías para comparar ingresos y cuál para volumen de registros.
Comprueba tu resultado
Error frecuente: usar count como ingreso. Corrige asociando cada pregunta con su unidad. La solución debe contener total 55, libros 30, juegos 25, media 18.33 y conteo 3.
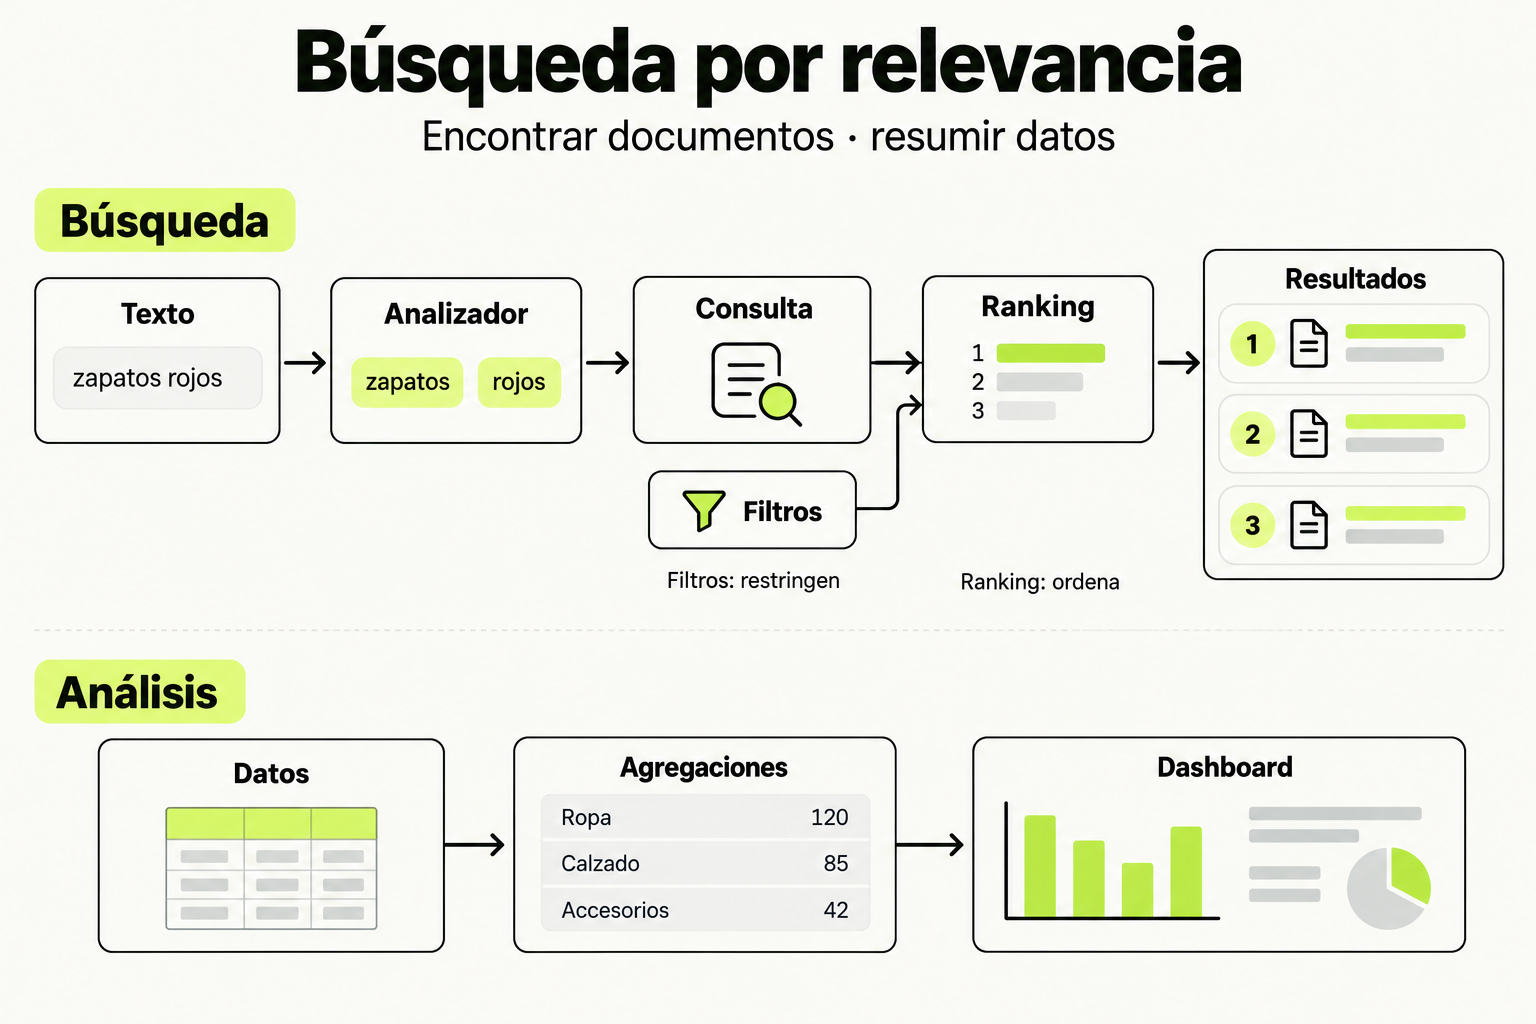
 Mapa de práctica
El analizador convierte texto en términos que la consulta utiliza para buscar documentos. Los filtros restringen qué documentos pueden aparecer y el ranking ordena los resultados según relevancia; filtrar no significa aumentar la puntuación. En un recorrido independiente, las agregaciones resumen grupos de datos para un dashboard. Las cifras y gráficos de ese recorrido son ilustrativos, no una medición de rendimiento.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
Las agregaciones en Elasticsearch son el mecanismo fundamental para realizar análisis en tiempo real sobre grandes volúmenes de datos indexados. A diferencia de las consultas de búsqueda que devuelven documentos específicos, las agregaciones procesan y resumen datos para extraer métricas, estadísticas y patrones. Piensa en ellas como el equivalente a las funciones GROUP BY y agregadas de SQL, pero diseñadas para escalar horizontalmente en entornos distribuidos.
En el contexto de un Search Engineer, dominar las agregaciones significa poder responder preguntas de negocio complejas en milisegundos: ¿Cuál es el producto más vendido por región este trimestre? ¿Cómo ha evolucionado el tiempo de respuesta promedio de la API en las últimas 24 horas? Las agregaciones se ejecutan en paralelo con las búsquedas, aprovechando la estructura de segmentos de Lucene para calcular resultados sin necesidad de recorrer todos los documentos individualmente.
Cómo funciona en la práctica
Una agregación típica en Elasticsearch consta de tres componentes principales: el tipo de agregación (métrica, bucket, pipeline), los campos sobre los que opera, y opcionalmente sub-agregaciones para análisis anidados. Por ejemplo, para analizar ventas por categoría:
GET /ventas/_search
{
  "size": 0,
  "aggs": {
    "ventas_por_categoria": {
      "terms": {
        "field": "categoria.keyword",
        "size": 10
      },
      "aggs": {
        "total_ventas": {
          "sum": {
            "field": "monto"
          }
        },
        "venta_promedio": {
          "avg": {
            "field": "monto"
          }
        }
      }
    }
  }
}
Este ejemplo usa una agregación de tipo terms (bucket) para agrupar documentos por categoría, y dentro de cada bucket calcula dos agregaciones métricas: suma y promedio del campo monto. El parámetro "size": 0 indica que no queremos documentos de resultado, solo las agregaciones.
Caso de estudio
Imagina que eres Search Engineer en una plataforma de e-commerce que maneja 10 millones de transacciones diarias. El equipo de marketing necesita un dashboard en Kibana que muestre:
- Las 5 categorías con mayor crecimiento en ventas mes a mes
- El valor promedio del carrito por grupo de edad de usuarios
- La distribución geográfica de pedidos con tiempo de entrega superior a 48 horas
Para implementar esto, diseñarías un índice con mapping optimizado para agregaciones (usando campos keyword para agrupaciones, numéricos para métricas) y crearías una consulta con múltiples niveles de agregación:
| Requisito | Tipo de agregación | Campo clave |
|---|---|---|
| Crecimiento por categoría | Date histogram + terms + derivative pipeline | fecha, categoria.keyword |
| Valor por grupo de edad | Range + avg | edad_usuario, monto_carrito |
| Distribución geográfica | Geohash grid + filter | ubicacion, tiempo_entrega |
Las agregaciones pipeline como derivative requieren que los buckets estén ordenados cronológicamente y pueden impactar el rendimiento en series temporales largas.
Errores comunes
- Usar campos text para agrupaciones: Los campos analizados con tokenizers no son adecuados para agregaciones terms. Siempre usa campos .keyword o define multi-fields.
- Ignorar la cardinalidad: Agrupar por campos con alta cardinalidad (como user_id) puede consumir memoria excesiva. Usa parámetros como "size" y considera agregaciones cardinality para estimaciones.
- No optimizar el mapping: Campos que solo se usan para agregaciones deben tener doc_values habilitado y formatos numéricos apropiados (integer vs float).
- Subestimar el costo de sub-agregaciones: Cada nivel de agregación anidada multiplica la complejidad computacional. Evalúa si necesitas todos los niveles en tiempo real.
- Olvidar el contexto de ejecución: Las agregaciones se calculan sobre los documentos que coinciden con la query. Si necesitas agregar sobre todo el índice, usa "match_all" explícitamente.
Checklist de dominio
- Puedo explicar la diferencia entre agregaciones métricas, de bucket y pipeline
- He implementado agregaciones multi-nivel con sub-agregaciones anidadas
- Sé cuándo usar scripted_metric vs agregaciones estándar
- Puedo optimizar el mapping de un índice específicamente para consultas de agregación
- He depurado problemas de rendimiento en agregaciones complejas usando el perfil de ejecución
- Puedo integrar resultados de agregaciones en dashboards de Kibana con visualizaciones apropiadas
- Sé implementar agregaciones en tiempo real sobre streams de datos usando índices de rollup o transform
Optimización de agregaciones para análisis de logs de aplicaciones
Como Search Engineer en una empresa de SaaS, debes optimizar las agregaciones sobre logs de aplicaciones para un dashboard de monitorización en tiempo real. Sigue estos pasos:
- Crea un índice llamado "logs_app_prod" con mapping optimizado para los siguientes campos: timestamp (date), nivel_error (keyword), usuario_id (keyword), respuesta_ms (integer), endpoint (text con subcampo keyword).
- Indexa al menos 100 documentos de ejemplo que representen logs de una API web con variación en los campos anteriores.
- Implementa una consulta que devuelva: el promedio de tiempo de respuesta por endpoint, los 3 endpoints con más errores (nivel_error = "ERROR") en la última hora, y la distribución percentil 95 del tiempo de respuesta por usuario.
- Ejecuta la consulta con el parámetro "profile": true y analiza los tiempos de ejecución de cada agregación.
- Basado en el análisis, propone dos optimizaciones específicas al mapping o a la consulta para mejorar el rendimiento.
Pistas
- Considera usar doc_values: false para campos que solo aparecen en logs pero no en agregaciones
- Para la agregación de percentiles, evalúa si necesitas el algoritmo TDigest o HDRHistogram según la distribución de tus datos
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Implementación Avanzada de Búsqueda Full-Text y Analytics con Elasticsearch y Kibana
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.