

Lección 8 de 20 · Lectura y práctica
Crear consultas con funciones de scoring personalizadas
Tipo de lección: VideoConcepto claveEl scoring personalizado en Elasticsearch te permite controlar cómo se calcula la relevancia de los documentos en tus búsquedas full-text. Mientras que el algoritmo por defecto (BM25) funciona.
Del concepto a la práctica
Taller de esta lección
El scoring personalizado debe añadir una señal de negocio sin borrar la relevancia textual. Si dos artículos coinciden con la consulta, una valoración puede desempatar, pero no debería convertir un artículo irrelevante en el primero. field_value_factor permite expresar esa preferencia con un campo numérico.
Ejemplo resuelto
{"query":{"function_score":{"query":{"match":{"titulo":"linterna"}},"field_value_factor":{"field":"valoracion","factor":0.2,"missing":0},"boost_mode":"sum"}}}En un cálculo hipotético separado de la consulta real, si los scores textuales fueran2 y1 y las valoraciones5 y4, los scores ajustados son 3 y 1.8: el primer documento conserva ventaja.
Pruébalo
Indexa L1={titulo:"linterna compacta",valoracion:5} y L2={titulo:"linterna portátil",valoracion:4}. Los scores textuales2 y1 no se insertan como propiedades ni se fuerzan por el título: lee sus valores reales en explain.
Ejecuta la consulta con
explainpara observar contribuciones.Cambia
factora 1 y compara el efecto.Decide un límite razonable antes de usarlo en el proyecto.
Comprueba tu resultado
Error frecuente: multiplicar por un campo ausente y obtener resultados imprevisibles. Corrige con missing. El ejercicio debe conservar dos documentos y mostrar que el ajuste depende de la valoración, sin afirmar una latencia concreta.
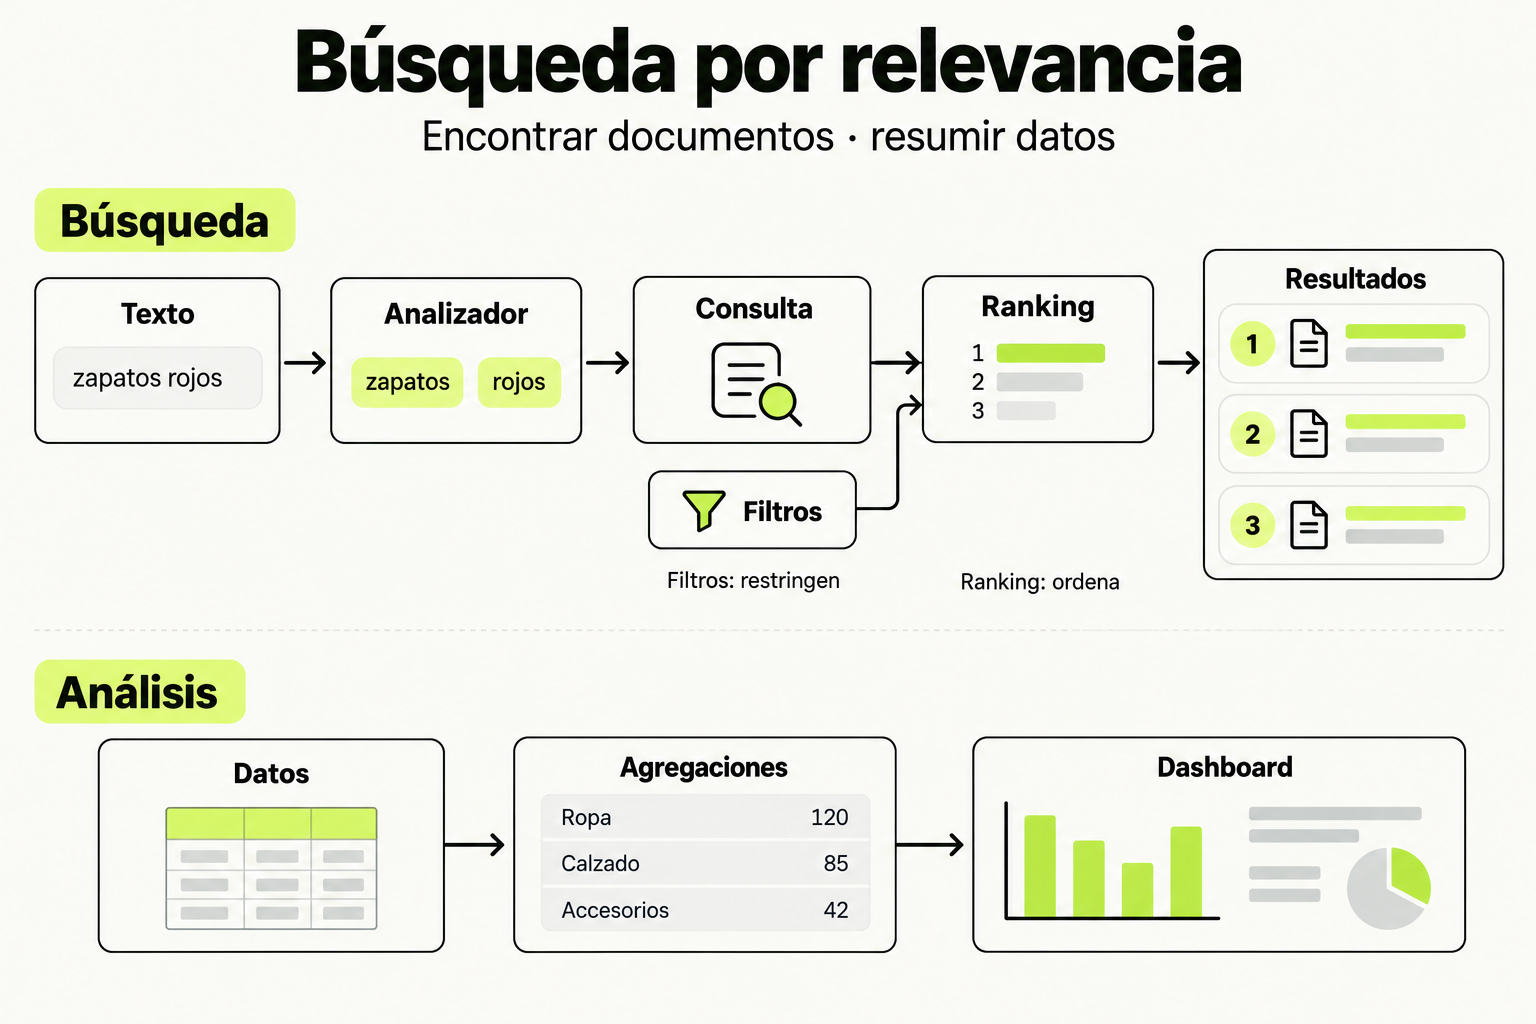
 Mapa de práctica
El analizador convierte texto en términos que la consulta utiliza para buscar documentos. Los filtros restringen qué documentos pueden aparecer y el ranking ordena los resultados según relevancia; filtrar no significa aumentar la puntuación. En un recorrido independiente, las agregaciones resumen grupos de datos para un dashboard. Las cifras y gráficos de ese recorrido son ilustrativos, no una medición de rendimiento.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
El scoring personalizado en Elasticsearch te permite controlar cómo se calcula la relevancia de los documentos en tus búsquedas full-text. Mientras que el algoritmo por defecto (BM25) funciona bien en muchos casos, hay situaciones donde necesitas ajustar la lógica de ranking según reglas de negocio específicas.
Imagina que trabajas en un e-commerce: quieres que los productos con mejor calificación de usuarios aparezcan primero, incluso si coinciden menos con los términos de búsqueda. O en un sistema de noticias, donde las publicaciones más recientes deben tener prioridad. El Query DSL de Elasticsearch ofrece funciones como function_score que permiten modificar el score original aplicando factores como boost por campo, funciones matemáticas, o incluso scripts personalizados.
El scoring personalizado no reemplaza BM25, sino que lo complementa con lógica de negocio.
Cómo funciona en la práctica
La función principal es function_score, que envuelve una consulta base y aplica una o más funciones de scoring. Cada función puede usar:
- weight: Multiplica el score por un factor constante
- field_value_factor: Usa el valor de un campo numérico (ej: rating, popularity)
- decay functions: Reduce el score basado en distancia (ej: fecha, ubicación)
- script_score: Cálculo completamente personalizado con Painless scripting
Ejemplo básico: buscar productos electrónicos donde los mejor calificados tengan más relevancia:
{
  "query": {
    "function_score": {
      "query": {
        "match": {
          "category": "electronics"
        }
      },
      "functions": [
        {
          "field_value_factor": {
            "field": "user_rating",
            "factor": 1.2,
            "modifier": "sqrt"
          }
        }
      ],
      "boost_mode": "multiply"
    }
  }
}
Aquí, el score original se multiplica por la raíz cuadrada del rating, dando más peso a productos mejor evaluados.
Caso de estudio
Implementemos un sistema de búsqueda para una plataforma de hoteles. Requerimientos:
- Los hoteles deben coincidir con términos como "playa" o "centro"
- Los mejor calificados (campo
ratingde 1-5) deben rankear más alto - Los más cercanos a una ubicación (campo
distance_km) deben tener ventaja - Los precios más bajos (campo
price_night) deben favorecerse moderadamente
Consulta resultante:
{
  "query": {
    "function_score": {
      "query": {
        "multi_match": {
          "query": "playa vista al mar",
          "fields": ["name", "description", "location"]
        }
      },
      "functions": [
        {
          "field_value_factor": {
            "field": "rating",
            "factor": 2.0,
            "modifier": "log1p"
          }
        },
        {
          "gauss": {
            "distance_km": {
              "origin": 0,
              "scale": 10
            }
          }
        },
        {
          "script_score": {
            "script": {
              "source": "return 1000 / (doc['price_night'].value + 1)"
            }
          }
        }
      ],
      "score_mode": "sum",
      "boost_mode": "multiply"
    }
  }
}
Esta consulta combina tres funciones: rating con transformación logarítmica, decaimiento gaussiano por distancia, y un script que favorece precios bajos. El score_mode define cómo se combinan las funciones (suma), y boost_mode cómo se aplican al query original (multiplicación).
Errores comunes
- Usar boost excesivo: Valores como 1000 distorsionan los resultados. Mantén factores entre 1-5 para ajustes sutiles.
- Ignorar la normalización: Campos como
pricepueden variar mucho (10 vs 10000). Usa modificadores comolog1po normaliza en el mapping. - Combinar funciones incorrectamente: Si usas
score_mode: "multiply"con funciones que devuelven 0, el score final será 0. Prefiere"sum"o"avg". - Olvidar el impacto en performance: Los scripts y funciones complejas ralentizan búsquedas. Usa
"explain": truepara depurar y perfilar. - No probar con datos reales: Los scores teóricos pueden comportarse distinto con tus datos. Siempre valida con una muestra representativa.
Checklist de dominio
- Entiendo la diferencia entre
boost_modeyscore_mode - Puedo implementar al menos tres tipos de funciones de scoring
- Sé cuándo usar
field_value_factorvsscript_score - He probado mis consultas con
"explain": truepara validar cálculos - Puedo ajustar parámetros de decaimiento (scale, decay, offset) para casos de uso
- He considerado el impacto en performance de mis funciones personalizadas
- Sé cómo normalizar campos numéricos para evitar dominancia en el scoring
Optimizar ranking de productos en un e-commerce
Configura una consulta con scoring personalizado para un catálogo de productos. Usa el dataset de ejemplo ecommerce_products con estos campos: name (texto), description (texto), price (float), sales_last_month (integer), rating (float 1-5), in_stock (boolean).
- Crea una consulta base que busque en
nameydescriptionusandomulti_matchcon el query "camara digital 4k" - Añade una función
field_value_factorque boostee productos con mayor rating, usandomodifier: "log1p"yfactor: 1.5 - Añade una segunda función que favorezca productos con más ventas recientes (
sales_last_month), usandoweight: 2.0 - Añade una tercera función con
script_scoreque asigne un bonus de 100 puntos siin_stockes true - Configura
score_mode: "sum"yboost_mode: "multiply" - Ejecuta la consulta y verifica que los productos mejor rankeados combinen relevancia textual con estos factores de negocio
Pistas
- Recuerda que weight multiplica el score de la función, no el score total
- Usa doc['in_stock'].value en el script para acceder al valor booleano
- Prueba con explain:true para ver cómo contribuye cada función
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Implementación Avanzada de Búsqueda Full-Text y Analytics con Elasticsearch y Kibana
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.