

Lección 1 de 20 · Lectura y práctica
Configurar mapeos dinámicos y estáticos para datos complejos
Concepto claveEn Elasticsearch, el mapeo define cómo los documentos y sus campos son indexados y almacenados. Existen dos enfoques principales: mapeo dinámico, donde Elasticsearch infiere automáticamente los tipos de datos al.
Del concepto a la práctica
Taller de esta lección
Un mapping estático protege la semántica cuando un mismo campo puede llegar con valores distintos. Para un pedido, importe debe ser numérico, estado una categoría exacta y cliente un objeto; no conviene dejar que la primera carga decida por accidente.
Ejemplo resuelto
{"mappings":{"properties":{"importe":{"type":"scaled_float","scaling_factor":100},"estado":{"type":"keyword"},"cliente":{"properties":{"id":{"type":"keyword"},"pais":{"type":"keyword"}}}}}}Con scaling_factor 100, 19,95 se representa como 1995 centésimas. Así se evitan agregaciones sobre texto y se conserva la unidad monetaria.
Para el cliente singular, object sirve. Si incorporas una lista de pares como [{id:"A",pais:"ES"},{id:"B",pais:"MX"}], un object puede perder la relación de cada pareja al indexar campos; usa nested y una consulta nested cuando necesitas exigir idA y paisES en el mismo elemento. No declare nested solamente por tener un objeto simple.
Pruébalo
Define el mapping anterior.
Inserta pedidos con
importe19.95 y 8.50.Intenta enviar
estadocomo objeto y observa el rechazo esperado.Consulta sum sobre importe y lee directamente euros en la respuesta de la API; no dividas otra vez entre100.
Comprueba tu resultado
Error frecuente: aceptar el mapping dinámico y terminar con importe como text. Corrige creando un índice nuevo con mapping explícito. El ejercicio debe producir 28,45 euros; la representación interna puede sumar 2845 centésimas, pero la agregación pública sum devuelve28,45 en las unidades originales. scaled_float redondea a la precisión configurada y no vuelve exacta cualquier suma de floats para cálculos contables; para un libro contable considera centavos enteros y límites adecuados.
 Mapa de práctica
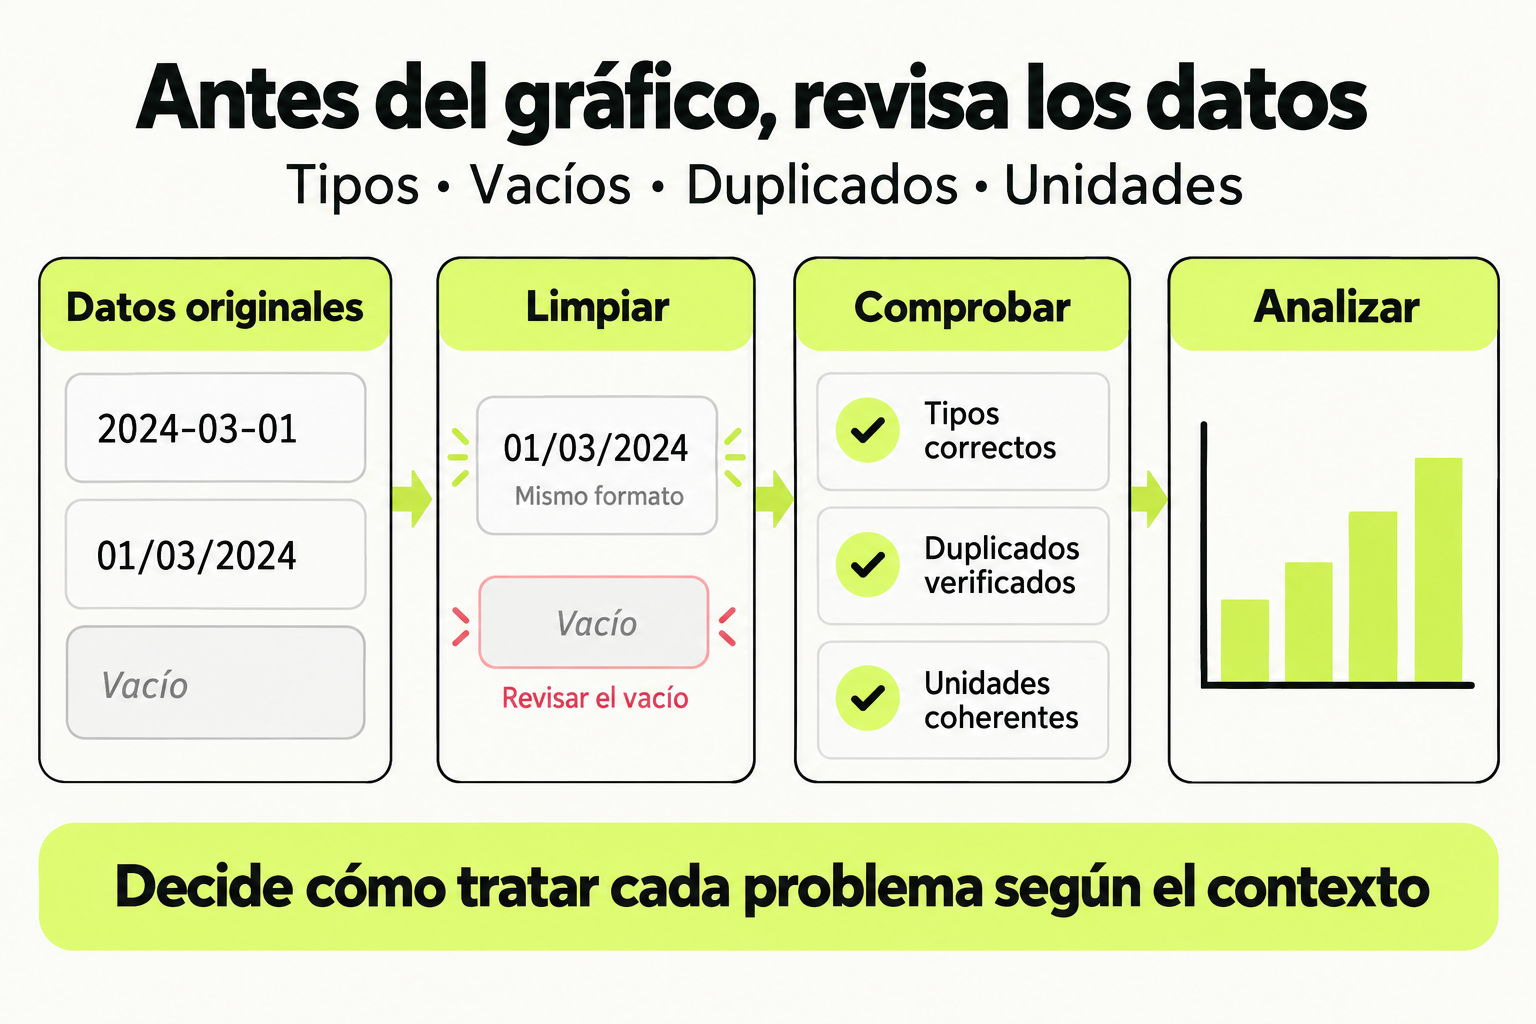
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Concepto clave
En Elasticsearch, el mapeo define cómo los documentos y sus campos son indexados y almacenados. Existen dos enfoques principales: mapeo dinámico, donde Elasticsearch infiere automáticamente los tipos de datos al indexar documentos nuevos, y mapeo estático, donde defines explícitamente la estructura de los campos antes de indexar. Para datos complejos, como objetos anidados, arrays o campos con múltiples tipos, elegir el enfoque correcto es crucial para el rendimiento y la precisión de las búsquedas.
Imagina que estás organizando una biblioteca. El mapeo dinámico sería como dejar que los libros se coloquen en estantes según su tamaño y tema automáticamente, lo que puede ser rápido pero desordenado. El mapeo estático sería como diseñar un plano detallado de la biblioteca con secciones específicas para novelas, manuales y revistas, asegurando que cada libro tenga un lugar óptimo. En Elasticsearch, los datos complejos, como productos con múltiples variantes o usuarios con historiales de actividad, requieren este tipo de planificación para evitar problemas como conflicto de tipos o búsquedas lentas.
Cómo funciona en la práctica
Para configurar mapeos, primero define un índice con un mapeo estático para campos críticos. Por ejemplo, en un sistema de e-commerce, podrías crear un índice para productos:
PUT /productos
{
  "mappings": {
    "properties": {
      "nombre": { "type": "text" },
      "precio": { "type": "float" },
      "categorias": { "type": "keyword" },
      "especificaciones": {
        "type": "nested",
        "properties": {
          "clave": { "type": "keyword" },
          "valor": { "type": "text" }
        }
      }
    }
  }
}
Aquí, especificaciones es un campo nested que permite búsquedas precisas en objetos dentro de arrays. Para habilitar mapeo dinámico en campos menos críticos, como comentarios de usuarios, puedes usar "dynamic": "true" en el nivel raíz o en campos específicos. Esto permite que Elasticsearch maneje datos impredecibles sin romper el índice.
Caso de estudio
Considera una plataforma de análisis de logs donde los datos incluyen eventos de usuarios con estructuras variables. Un evento típico podría ser:
| Campo | Tipo | Descripción |
|---|---|---|
| timestamp | date | Fecha y hora del evento |
| user_id | keyword | Identificador del usuario |
| event_type | keyword | Tipo de evento (ej., click, view) |
| metadata | object | Datos dinámicos específicos del evento |
Para esto, configura un mapeo híbrido:
PUT /logs
{
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "timestamp": { "type": "date" },
      "user_id": { "type": "keyword" },
      "event_type": { "type": "keyword" },
      "metadata": {
        "type": "object",
        "dynamic": true
      }
    }
  }
}
Esto asegura que los campos principales sean estáticos para consistencia, mientras que metadata acepta datos dinámicos sin errores. En producción, esto mejora la eficiencia de las consultas de analytics en Kibana, ya que los campos clave están optimizados.
Errores comunes
- Conflicto de tipos: Ocurre cuando Elasticsearch infiere tipos diferentes para un mismo campo en documentos distintos, debido al mapeo dinámico. Solución: Usa mapeo estático para campos críticos o configura
"dynamic": "strict"para evitar inferencias no deseadas. - Sobrecarga de campos: El mapeo dinámico puede crear miles de campos si los datos son muy variables, aumentando el uso de memoria. Solución: Limita campos dinámicos con patrones o usa
"dynamic": false"para ignorar campos no mapeados. - Mala indexación de arrays: Tratar arrays de objetos como tipos simples puede llevar a búsquedas incorrectas. Solución: Usa tipo
nestedpara arrays de objetos cuando necesites consultas precisas. - Ignorar análisis de texto: No configurar analizadores para campos de texto puede reducir la relevancia en búsquedas full-text. Solución: Define analizadores personalizados en el mapeo estático para idiomas o dominios específicos.
Checklist de dominio
- ¿Has identificado campos críticos que requieren mapeo estático para evitar conflictos de tipos?
- ¿Has usado tipos
nestedpara arrays de objetos en consultas complejas? - ¿Has configurado
dynamicapropiadamente (true, false, strict) según la variabilidad de los datos? - ¿Has optimizado campos de texto con analizadores para mejorar búsquedas full-text?
- ¿Has probado el mapeo con datos de ejemplo antes de implementar en producción?
- ¿Has documentado la estructura del mapeo para el equipo de desarrollo?
- ¿Has considerado el impacto en el rendimiento al agregar nuevos campos dinámicos?
Configurar un mapeo híbrido para un sistema de reseñas de productos
En este ejercicio, crearás un índice en Elasticsearch para manejar reseñas de productos con datos complejos. Sigue estos pasos:
- Crea un índice llamado
reseñas_productoscon un mapeo estático para campos esenciales:producto_id(keyword),fecha(date),puntuacion(integer). - Añade un campo
comentariode tipo text con un analizador en español para búsquedas full-text. - Define un campo
metadatoscomo objeto con mapeo dinámico ("dynamic": true) para capturar datos adicionales como ubicación del usuario o dispositivo. - Indexa un documento de ejemplo que incluya un array en
metadatoscon al menos dos elementos. - Verifica el mapeo resultante usando la API de Elasticsearch y ejecuta una consulta para buscar reseñas con puntuacion mayor a 3.
Pistas
- Usa el tipo 'text' con 'analyzer': 'spanish' para el campo comentario.
- Recuerda que los arrays en objetos dinámicos no requieren tipo 'nested' a menos que necesites consultas complejas.
- Puedes usar el comando GET /reseñas_productos/_mapping para verificar tu configuración.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Práctica acompañada: Datos pequeños, preguntas claras
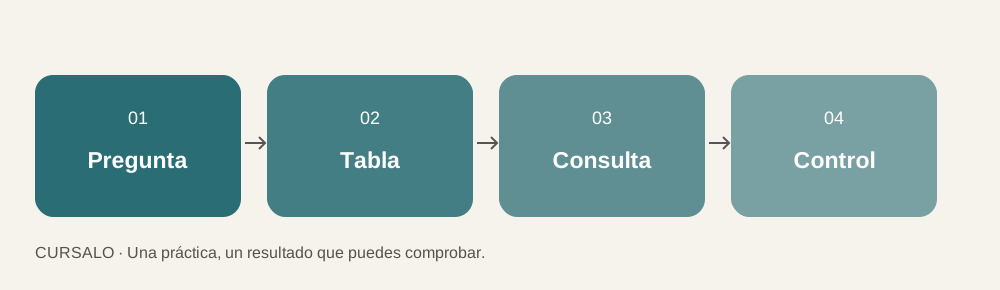
Consultas SQL y control de calidad. Usa este cuaderno como práctica complementaria de la ruta; el material original de la lección continúa siendo tu referencia.
Práctica: modifica una condición
Filtra ahora las ventas del día 2026-09-02. Debes obtener 3 unidades y 2800 centavos. Después agrega otra fila de Papelería: una unidad a 500 centavos. Antes de ejecutar, predice cómo cambiarán el total y el resultado por categoría.
Repite el análisis en una tabla dinámica o con fórmulas de tu hoja de cálculo. Las dos herramientas deben producir el mismo resultado a partir de las mismas filas. Guarda por separado el archivo original y tu variante. Anota también una pregunta que estos datos no permiten responder; por ejemplo, margen de beneficio sin conocer el costo de cada producto.
Comprueba tu entrega
Entrega la consulta, el conjunto de datos y una tabla pequeña con los resultados. Incluye tres controles: número de filas, suma total y comprobación manual de una categoría. Evita gráficos tridimensionales o ejes que oculten la escala.
Sigue con Implementación Avanzada de Búsqueda Full-Text y Analytics con Elasticsearch y Kibana
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.