

Lección 13 de 25 · Lectura y práctica
Optimización de bases de datos y conexiones en Go
Aprende optimización de bases de datos y conexiones en go con esta lectura y práctica de APIs REST en Go: Concurrencia, Despliegue y Monitoreo.
Del concepto a la práctica
Taller de esta lección
Optimizar una base de datos empieza por limitar el recurso compartido. Si el pool permite 2 conexiones y llegan 5 operaciones de 50 ms, como máximo dos avanzan simultáneamente; las demás esperan. Una consulta que devuelve solo id,title también reduce transferencia frente a SELECT *. El objetivo es medir saturación, no adivinarla.
Ejemplo resuelto
Configura un pool local con máximo 2 conexiones.
Distingue una simulación de tareas de 50 ms de consultas reales; registra duración y espera de cada una.
Cuando uses sql.Conn, ejecuta defer conn.Close tras adquirirla; con sql.DB libera filas y transacciones según su ciclo de vida.
Compara con un pool de 5 y observa el coste del recurso.
Para el handle compartido sql.DB, configura SetMaxOpenConns(2) y observa DB.Stats() (WaitCount y WaitDuration). Usa QueryContext con timeout, cierra rows y comprueba rows.Err tras iterar. No crees ni cierres el handle global por petición. Cinco tareas de 50 ms con capacidad 2 dan un modelo ideal de tres tandas y unos 150 ms; una medición real añade planificación, consulta y transferencia.
Pruébalo
Usa cinco tareas idénticas y registra cuántas terminan por cada intervalo de 50 ms.
Comprueba tu resultado
Con capacidad 2, el trabajo se completa en al menos tres tandas; con capacidad 5, en una tanda si el entorno lo permite.
Error frecuente: adquirir una conexión y devolverla solo al final de una función larga. Corrección: reduce el ámbito, libera pronto y define un timeout de contexto para evitar esperas indefinidas.
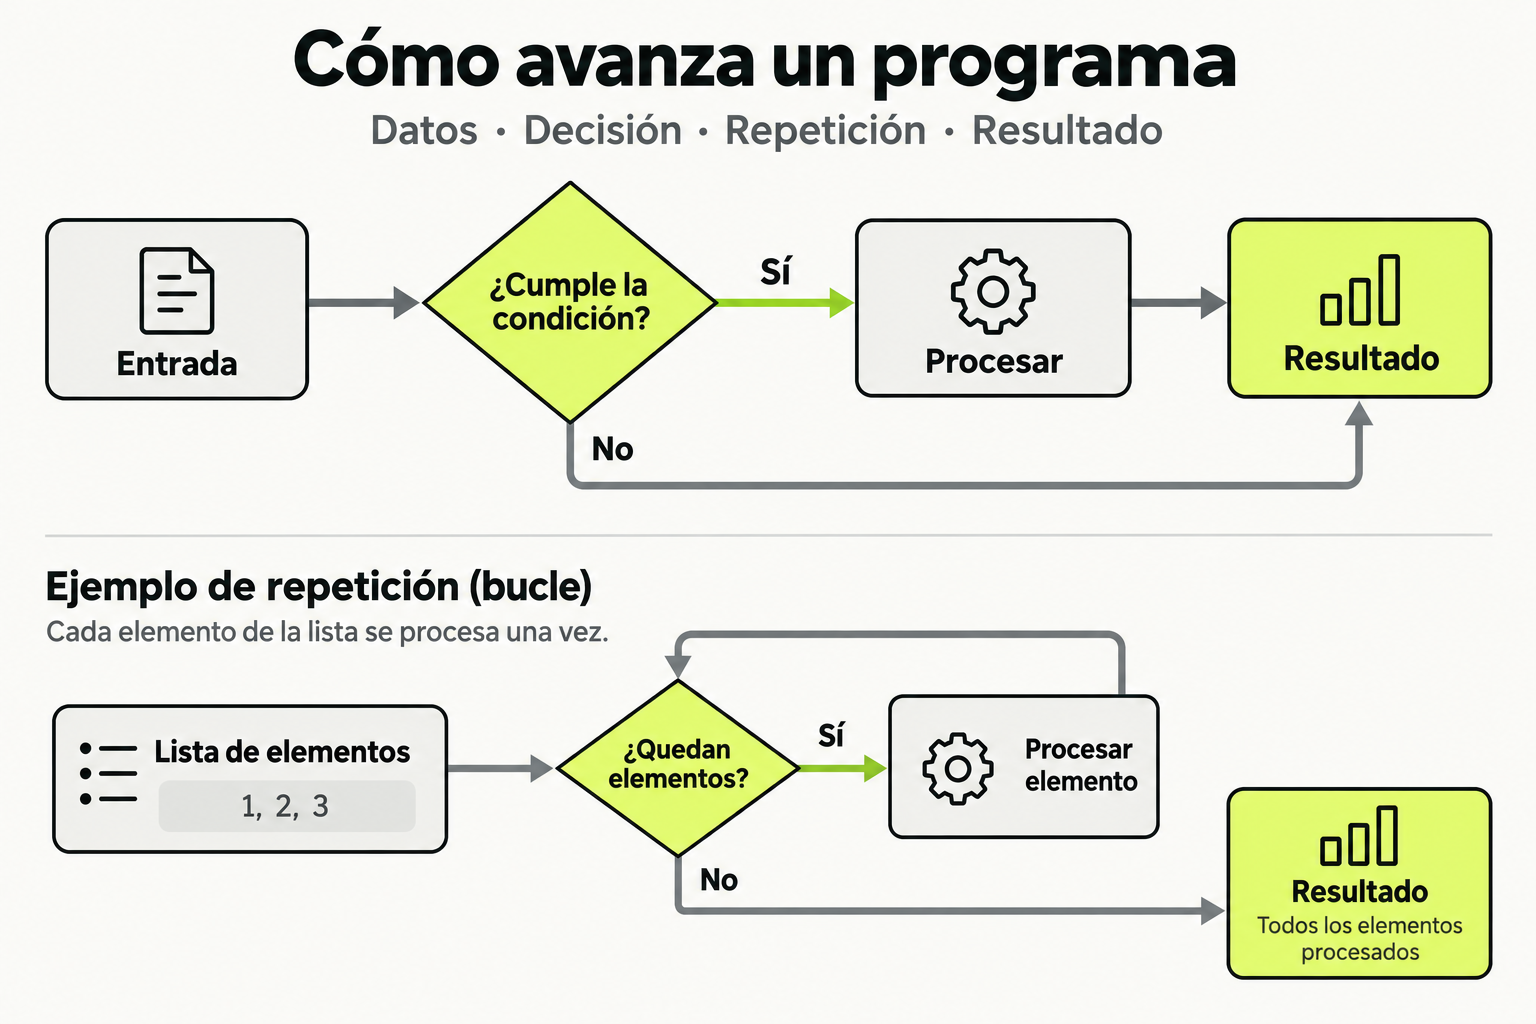
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Introducción: El Cuello de Botella de la Persistencia
En la arquitectura de microservicios de alto rendimiento, la base de datos suele ser el componente más lento y el principal candidato a convertirse en cuello de botella. Mientras que la lógica de negocio en Go puede ejecutarse en microsegundos, una consulta de base de datos mal optimizada puede tomar decenas o cientos de milisegundos. Esta disparidad de órdenes de magnitud significa que, sin importar cuán eficiente sea tu código Go, el rendimiento general de tu API estará limitado por la velocidad y eficiencia con la que interactúas con tu sistema de persistencia.
La optimización de bases de datos en Go va más allá de simplemente escribir consultas SQL correctas. Se trata de gestionar eficientemente un recurso escaso y costoso: las conexiones de base de datos. Cada conexión abierta consume memoria tanto en el lado del cliente (tu aplicación Go) como en el lado del servidor (la base de datos). Una gestión deficiente puede llevar a un agotamiento de conexiones, latencia elevada o, en el peor de los casos, la caída completa del servicio. Esta lección se centra en los patrones, técnicas y herramientas que te permitirán extraer el máximo rendimiento de tu capa de datos mientras mantienes tu aplicación estable y escalable bajo carga.
Abordaremos este desafío desde múltiples ángulos: la configuración y administración del pool de conexiones, el uso de consultas preparadas para eficiencia y seguridad, la implementación de estrategias de caché para reducir la carga en la base de datos, y el diseño de esquemas y consultas que se alineen con los principios de alto rendimiento. El objetivo es transformar la base de datos de un potencial punto de fallo en un componente robusto y rápido de tu arquitectura de microservicios.
Concepto Clave: El Pool de Conexiones y la Ley del Mínimo Esfuerzo
Imagina una biblioteca muy concurrida con un solo bibliotecario. Si cada persona que necesita un libro tuviera que esperar a que se contrate y entrene un nuevo bibliotecario exclusivamente para ella, el caos sería absoluto. En su lugar, la biblioteca tiene un equipo de bibliotecarios (un "pool") listos para atender las solicitudes. Cuando un usuario llega, se le asigna un bibliotecario disponible. Cuando el usuario termina, el bibliotecario vuelve al pool, listo para ayudar al siguiente. Un pool de conexiones funciona exactamente así: es una caché de conexiones de base de datos establecidas que se mantienen abiertas y se reutilizan entre las diferentes solicitudes HTTP que llegan a tu API.
Crear una conexión de base de datos desde cero es una operación costosa en términos de red (TCP handshake, autenticación, negociación) y recursos del sistema. El pool evita este costo al mantener un conjunto de conexiones "calientes" y listas para usar. Los parámetros clave que gobiernan este pool son: MaxOpenConns (el número máximo de conexiones abiertas simultáneamente), MaxIdleConns (cuántas conexiones pueden permanecer inactivas en el pool), y ConnMaxLifetime (cuánto tiempo puede vivir una conexión antes de ser cerrada y recreada). Configurar estos valores correctamente es crucial para equilibrar el rendimiento con el uso de recursos.
Tip del Experto: No confundas MaxOpenConns con el límite de conexiones de tu base de datos. Tu pool en Go debe estar configurado para estar muy por debajo del límite máximo de tu servidor de base de datos (por ejemplo, PostgreSQL `max_connections`). Deja un margen para otras aplicaciones, conexiones administrativas y picos inesperados. Una regla común es establecer `MaxOpenConns` en aproximadamente el 80% del límite de la base de datos para esa aplicación específica.
Cómo Funciona en la Práctica: Configuración del Pool y Consultas Preparadas
En Go, el pool de conexiones está integrado en el propio `sql.DB` del paquete `database/sql`. No es una estructura separada. Cuando importas un driver (como `pq` para PostgreSQL o `go-sql-driver/mysql` para MySQL) y abres una base de datos con `sql.Open()`, estás creando un manejador que gestiona un pool interno. La función `Open` no establece ninguna conexión inmediatamente; las conexiones se crean bajo demanda, según la configuración del pool. La configuración se realiza mediante métodos en el struct `sql.DB` una vez abierto.
El siguiente paso crítico es el uso de consultas preparadas (prepared statements). Una consulta preparada es una plantilla SQL que se compila una vez en el servidor de base de datos y luego se puede ejecutar múltiples veces con diferentes parámetros. Esto ofrece dos ventajas enormes: seguridad (previene inyecciones SQL al separar claramente la estructura de la consulta de los datos) y rendimiento (el plan de ejecución de la consulta se cachea en el servidor, evitando el overhead de re-analizar y re-planificar la misma consulta repetidamente). En Go, puedes usar `db.Prepare()` para crear un statement preparado, o, de manera más idiomática y segura para el manejo de conexiones, usar `db.Query()` o `db.Exec()` pasando los parámetros directamente, lo que el driver convierte internamente en una consulta preparada.
Veamos un ejemplo práctico de configuración inicial. Supongamos que estamos construyendo un microservicio para un sistema de comercio electrónico que experimenta picos de tráfico durante las ventas flash.
package main

import (
    "database/sql"
    "fmt"
    "log"
    "time"
    _ "github.com/lib/pq" // Driver PostgreSQL
)

func main() {
    // Cadena de conexión. ¡NUNCA la hardcodees en producción!
    connStr := "user=api_user dbname=ecommerce password=secure_pass host=db-primary port=5432 sslmode=disable"

    // Abrir la "base de datos" (realmente, el manejador del pool)
    db, err := sql.Open("postgres", connStr)
    if err != nil {
        log.Fatal("Error al abrir la conexión:", err)
    }
    // Es CRÍTICO cerrar el pool al finalizar la aplicación.
    defer db.Close()

    // CONFIGURACIÓN CRÍTICA DEL POOL
    // Máximo de conexiones abiertas simultáneamente.
    db.SetMaxOpenConns(25)
    // Máximo de conexiones inactivas en el pool.
    db.SetMaxIdleConns(10)
    // Tiempo máximo que una conexión puede ser reutilizada.
    db.SetConnMaxLifetime(1 * time.Hour)
    // Tiempo máximo que una conexión puede estar inactiva antes de ser cerrada.
    db.SetConnMaxIdleTime(5 * time.Minute)

    // Verificar que la conexión es posible (ping).
    err = db.Ping()
    if err != nil {
        log.Fatal("Error al hacer ping a la base de datos:", err)
    }

    fmt.Println("Pool de conexiones configurado y listo.")
}
Código en Acción: Microservicio con Pool, Prepared Statements y Contextos
Ahora integremos estos conceptos en un escenario realista de un microservicio REST usando Gorilla/Mux. Crearemos un endpoint `GET /products/{id}` que obtiene un producto, utilizando un statement preparado explícito para máxima eficiencia en un endpoint de alto tráfico, y aplicaremos un timeout usando contextos para evitar que consultas lentas congestionen todo el pool.
Observa cómo el statement preparado (`stmt`) se crea una vez durante la inicialización y se reutiliza. También usamos `context.WithTimeout` para asegurar que la consulta no se bloquee indefinidamente. Si la consulta tarda más de 3 segundos, será cancelada, liberando la conexión de vuelta al pool para otras solicitudes.
package main

import (
    "context"
    "database/sql"
    "encoding/json"
    "log"
    "net/http"
    "time"
    "github.com/gorilla/mux"
    _ "github.com/lib/pq"
)

// Product representa nuestro modelo de datos.
type Product struct {
    ID          int     `json:"id"`
    Name        string  `json:"name"`
    Price       float64 `json:"price"`
    Stock       int     `json:"stock"`
    LastUpdated string  `json:"last_updated"`
}

// App mantiene las dependencias de la aplicación.
type App struct {
    Router *mux.Router
    DB     *sql.DB
    // Statement preparado cacheado a nivel de aplicación.
    getProductStmt *sql.Stmt
}

// Initialize configura el router y la base de datos.
func (a *App) Initialize(connStr string) {
    var err error

    a.DB, err = sql.Open("postgres", connStr)
    if err != nil {
        log.Fatal(err)
    }
    // Configuración del pool para un servicio web.
    a.DB.SetMaxOpenConns(30)
    a.DB.SetMaxIdleConns(15)
    a.DB.SetConnMaxLifetime(2 * time.Hour)

    // PREPARAMOS la consulta crítica una sola vez.
    // El driver enviará esta plantilla a la DB para su compilación/cacheo.
    a.getProductStmt, err = a.DB.Prepare("SELECT id, name, price, stock, last_updated FROM products WHERE id = $1")
    if err != nil {
        log.Fatal("Error al preparar la consulta:", err)
    }

    a.Router = mux.NewRouter()
    a.initializeRoutes()
}

func (a *App) initializeRoutes() {
    a.Router.HandleFunc("/products/{id:[0-9]+}", a.getProduct).Methods("GET")
}

// getProduct maneja la solicitud GET para un producto.
func (a *App) getProduct(w http.ResponseWriter, r *http.Request) {
    vars := mux.Vars(r)
    productID := vars["id"]

    var p Product

    // Creamos un contexto con timeout de 3 segundos para esta consulta.
    ctx, cancel := context.WithTimeout(r.Context(), 3*time.Second)
    defer cancel() // Libera recursos del contexto.

    // Ejecutamos el statement preparado con el contexto.
    // QueryRowContext es seguro para concurrencia, reutiliza la conexión del pool.
    row := a.getProductStmt.QueryRowContext(ctx, productID)
    err := row.Scan(&p.ID, &p.Name, &p.Price, &p.Stock, &p.LastUpdated)

    if err != nil {
        if err == sql.ErrNoRows {
            respondWithError(w, http.StatusNotFound, "Producto no encontrado")
            return
        }
        // Verificamos si el error fue por timeout del contexto.
        if ctx.Err() == context.DeadlineExceeded {
            log.Printf("Consulta timeout para product ID %s", productID)
            respondWithError(w, http.StatusGatewayTimeout, "Tiempo de espera agotado")
            return
        }
        log.Printf("Error al consultar producto %s: %v", productID, err)
        respondWithError(w, http.StatusInternalServerError, "Error interno del servidor")
        return
    }

    respondWithJSON(w, http.StatusOK, p)
}

func respondWithError(w http.ResponseWriter, code int, message string) {
    respondWithJSON(w, code, map[string]string{"error": message})
}

func respondWithJSON(w http.ResponseWriter, code int, payload interface{}) {
    response, _ := json.Marshal(payload)
    w.Header().Set("Content-Type", "application/json")
    w.WriteHeader(code)
    w.Write(response)
}

func main() {
    a := App{}
    // En producción, usa variables de entorno.
    a.Initialize("user=api_user dbname=ecommerce password=secure_pass host=localhost sslmode=disable")
    log.Fatal(http.ListenAndServe(":8080", a.Router))
}
Errores Comunes y Cómo Evitarlos
La optimización de bases de datos está llena de trampas sutiles. Aquí detallamos los errores más frecuentes que comprometen el rendimiento y la estabilidad.
1. No Configurar el Pool (Dejar los Valores por Defecto): Los valores por defecto de `sql.DB` son a menudo inadecuados para producción (`MaxOpenConns=0` significa ilimitado, lo que puede agotar la base de datos). Solución: Siempre establece `SetMaxOpenConns`, `SetMaxIdleConns` y `SetConnMaxLifetime` basándote en las pruebas de carga y los límites de tu base de datos.
2. No Usar Contextos para Timeouts y Cancelación: Una consulta bloqueada o muy lenta mantendrá una conexión del pool ocupada indefinidamente, acumulándose hasta agotar `MaxOpenConns`. Solución: Usa siempre los métodos `QueryContext`, `ExecContext`, `QueryRowContext` y propaga el contexto de la solicitud HTTP (`r.Context()`). Establece timeouts razonables.
3. Olvidar Cerrar Rows y Transactions: No llamar a `rows.Close()` después de un `Query()` o no finalizar una transacción (`tx.Commit()`/`tx.Rollback()`) dejará la conexión ocupada, impidiendo que vuelva al pool. Solución: Usa `defer rows.Close()` inmediatamente después de comprobar el error de `Query()`. Maneja las transacciones con cuidado, siempre con un `defer` que realice un rollback si no se ha hecho commit.
4. Preparar Statements en Cada Solicitud: Llamar a `db.Prepare()` dentro de cada handler anula el beneficio de rendimiento, ya que incurres en el round-trip de red para preparar la consulta cada vez. Solución: Prepara los statements de alto uso al inicio de la aplicación (como en el ejemplo) o confía en la preparación automática que hacen los drivers cuando usas `db.Query()` con placeholders.
5. N+1 Queries (El Asesino del Rendimiento): Obtener una lista de órdenes y luego, en un bucle, hacer una consulta separada para los items de cada orden. Esto genera una explosión de consultas. Solución: Usa JOINs o consultas batched (con `IN` clause) para obtener todos los datos necesarios en una o pocas consultas. Considera el uso de dataloaders para GraphQL.
Checklist de Dominio
Antes de considerar que has dominado la optimización de bases de datos y conexiones en Go, verifica que puedes afirmar y aplicar cada uno de estos puntos:
- Puedo explicar la diferencia entre MaxOpenConns, MaxIdleConns y ConnMaxLifetime, y sé cómo ajustarlos para mi carga de trabajo específica.
- Configuro sistemáticamente un contexto con timeout para todas las operaciones de base de datos en mis handlers HTTP.
- Uso consultas preparadas de manera efectiva, ya sea mediante `db.Prepare()` para consultas de muy alto tráfico o confiando en la preparación automática del driver.
- Sé cerrar correctamente todos los recursos (Rows, Transactions, Statements) para evitar fugas de conexiones.
- He identificado y eliminado patrones de consulta N+1 en mi código mediante el uso de JOINs o agregación de datos.
- Utilizo herramientas como EXPLAIN ANALYZE en PostgreSQL para entender el plan de ejecución de mis consultas y he añadido índices donde son necesarios.
- He implementado una estrategia básica de caché (por ejemplo, con Redis o memoria en Go) para datos de lectura frecuente y raramente modificados.
- Comprendo cuándo es apropiado usar una transacción y cómo mantenerlas lo más cortas posible para reducir el bloqueo en la base de datos.
Conclusión Final: La optimización de bases de datos es un viaje continuo de medición, ajuste y observación. Configura un pool sólido, escribe consultas inteligentes, maneja los errores y los timeouts con gracia, y siempre perfila tu aplicación bajo carga. Un microservicio Go rápido no es solo código Go rápido; es, sobre todo, una interacción inteligente y eficiente con sus dependencias, siendo la base de datos la más crítica.
Sigue con APIs REST en Go: Concurrencia, Despliegue y Monitoreo
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.