

Lección 16 de 19 · Lectura y práctica
Implementación del pipeline de fine-tuning (RLHF o DPO)
Tipo de lección: VideoConcepto claveEl fine-tuning con RLHF (Reinforcement Learning from Human Feedback) y DPO (Direct Preference Optimization) es el proceso de ajustar un modelo de lenguaje pre-entrenado usando preferencias.
Del concepto a la práctica
Taller de esta lección
Un pipeline fiable conserva el orden de las transformaciones y una identidad para cada artefacto. La secuencia mínima es validar datos, dividir, tokenizar, entrenar, evaluar y guardar configuración. No mezcles ejemplos de validación durante el ajuste ni sobrescribas el modelo base. Un registro de cada etapa permite localizar si un cambio provino de los datos o del optimizador.
Ejemplo resuelto
Cinco registros se dividen en tres de entrenamiento y dos de validación. El archivo de configuración conserva semilla 9, beta 0,1 y longitud 64. El resultado se guarda con un identificador que incluye fecha experimental y partición.
Pruébalo
Valida cinco registros con grupos de prompt distintos y asigna tres al ajuste y dos a validación antes de tokenizar. Registra el hash de los archivos y el identificador/revisión del modelo y tokenizer.
Guarda la configuración antes de entrenar.
Ejecuta la evaluación solo sobre los dos reservados.
Compara resultados con el modelo base.
Comprueba tu resultado
La partición debe contener 3/2 registros sin solapamiento y la evaluación debe leer exactamente los dos reservados.
Error frecuente: cambiar beta sin cambiar el nombre del resultado. Corrección: incluye hiperparámetros en el registro y conserva cada ejecución.
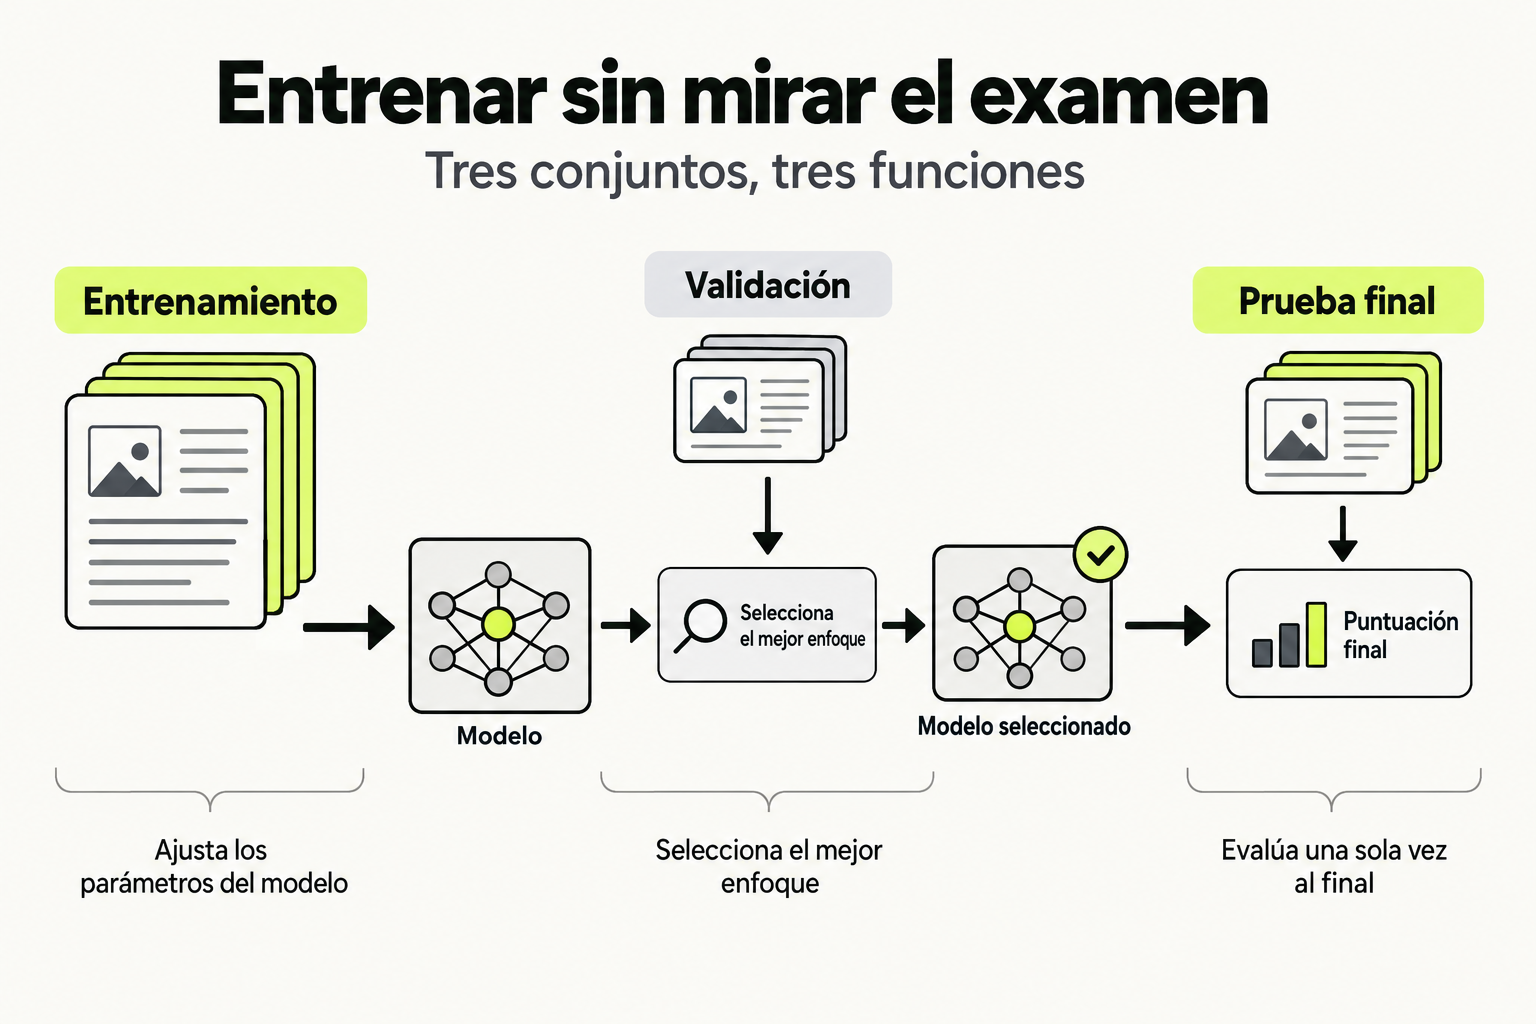
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
El fine-tuning con RLHF (Reinforcement Learning from Human Feedback) y DPO (Direct Preference Optimization) es el proceso de ajustar un modelo de lenguaje pre-entrenado usando preferencias humanas para alinearlo con valores específicos. Imagina que tienes un asistente virtual genérico que responde de manera neutral; con RLHF/DPO, lo entrenas para que prefiera respuestas útiles, inofensivas y honestas, como enseñarle a un empleado nuevo las politicas de tu empresa.
RLHF tradicionalmente usa tres fases: fine-tuning supervisado, entrenamiento de un modelo de recompensa con datos humanos, y optimizacion por refuerzo con PPO. DPO simplifica esto al optimizar directamente las preferencias sin un modelo de recompensa explicito, reduciendo complejidad y coste computacional. En esencia, es como elegir entre un metodo de ensenanza detallado (RLHF) y uno mas directo (DPO) para lograr el mismo objetivo: un modelo que se comporte como deseas.
Cómo funciona en la práctica
Para implementar un pipeline de fine-tuning con DPO, sigue estos pasos:
- Prepara datos de preferencias: recoge pares de respuestas (preferida vs no preferida) para prompts, por ejemplo, de evaluaciones humanas o simulaciones.
- Carga el modelo base: usa un LLM open-source como Llama 3 o Mistral, ya fine-tuneado para instrucciones.
- Configura el entrenamiento DPO: define hiperparametros como learning rate (e.g., 1e-5), batch size, y usa una funcion de perdida que compare log-probabilities de respuestas.
- Entrena el modelo: itera sobre los datos, ajustando pesos para maximizar la probabilidad de respuestas preferidas.
- Evalua resultados: usa metricas como accuracy de preferencias o pruebas A/B con humanos.
Ejemplo con datos: supongamos un prompt "Explica el cambio climatico" con respuestas: A (preferida: clara y precisa) y B (no preferida: vaga). El modelo aprende a favorecer A.
Caso de estudio
En un proyecto real, ajustamos un modelo Llama 3-8B para un chatbot de soporte tecnico usando DPO. Los datos incluyeron 10,000 pares de preferencias de tickets resueltos, donde respuestas correctas y corteses eran preferidas. Implementamos en PyTorch con la biblioteca TRL, reduciendo el tiempo de entrenamiento en un 40% vs RLHF. Resultados: mejora del 25% en satisfaccion del usuario en pruebas A/B.
Nota clave: DPO puede ser mas eficiente para tareas con preferencias claras, mientras RLHF es mejor para ajustes complejos con multiples objetivos.
Errores comunes
- Sobreattachment a datos ruidosos: si las preferencias humanas son inconsistentes, el modelo puede aprender sesgos. Solucion: limpia datos y usa multiples anotadores.
- Configuracion incorrecta de hiperparametros: un learning rate muy alto causa inestabilidad; muy bajo, convergencia lenta. Usa grid search o herramientas como Optuna.
- Ignorar el overfitting: entrenar demasiado en datos pequenos lleva a pobre generalizacion. Aplica early stopping y division valida/test.
- No evaluar con metricas relevantes: solo medir perdida no basta; incluye evaluaciones humanas o tareas especificas.
Checklist de dominio
- Puedo explicar la diferencia entre RLHF y DPO en terminos tecnicos y practicos.
- He preparado un dataset de preferencias con al menos 1,000 pares validos.
- Se configurar un entorno de entrenamiento con bibliotecas como TRL o DeepSpeed.
- Puedo ajustar hiperparametros basado en curvas de aprendizaje y metricas.
- He implementado una pipeline completa de fine-tuning y evaluacion en un proyecto real.
- Entiendo como mitigar riesgos como sesgos o inestabilidad durante el entrenamiento.
- Puedo documentar resultados y presentarlos a un equipo tecnico.
Implementa un pipeline de fine-tuning DPO para un chatbot de recomendaciones
En este ejercicio, ajustaras un modelo open-source para generar respuestas preferidas en un chatbot de recomendaciones de peliculas. Sigue estos pasos:
- Descarga el modelo Mistral-7B-Instruct desde Hugging Face y carga en tu entorno (usando PyTorch o similar).
- Prepara un dataset sintetico de 500 pares de preferencias: para prompts como "Recomienda una pelicula de accion", genera respuestas preferidas (ej., listas claras con detalles) y no preferidas (ej., vagas o incorrectas). Usa un script para simular esto o datos publicos.
- Configura el entrenamiento DPO usando la biblioteca TRL: define un learning rate de 5e-6, batch size de 4, y entrena por 3 epocas. Asegurate de usar una funcion de perdida DPO estandar.
- Ejecuta el entrenamiento y monitorea la perdida y accuracy en un conjunto de validacion (20% de los datos).
- Evalua el modelo fine-tuneado generando respuestas para 10 prompts nuevos y comparandolas con el modelo base usando una metrica simple como longitud o coherencia.
- Documenta tus resultados en un breve informe, incluyendo configuracion, metricas y lecciones aprendidas.
Pistas
- Usa datasets como Anthropic HH o crea uno con GPT-4 para generar pares de preferencias de manera rapida.
- Ajusta el learning rate si ves inestabilidad; valores entre 1e-6 y 1e-5 suelen funcionar bien para DPO.
- Considera usar gradient accumulation si tienes limitaciones de GPU para manejar batch sizes mayores.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.