

Lección 18 de 19 · Lectura y práctica
Despliegue del modelo ajustado como API con FastAPI
Tipo de lección: QuizConcepto claveDesplegar un modelo ajustado como API con FastAPI es el puente entre el desarrollo de ML y la producción. Imagina que tu modelo fine-tuneado es un chef experto que ha aprendido recetas.
Del concepto a la práctica
Taller de esta lección
Una API de inferencia debe declarar qué recibe, qué devuelve y cómo comunica entradas inválidas. Carga el modelo mediante lifespan al iniciar cada proceso de aplicación y reutiliza esa instancia; cargarlo por solicitud añade latencia y puede agotar memoria. El endpoint no debe ocultar una excepción como si fuera una respuesta válida.
Ejemplo resuelto
Entrada válida: {"prompt":"Resume el ticket 7"}. Salida: {"text":"No hay datos suficientes para resumir el ticket 7"}. Entrada inválida: prompt vacío; la API devuelve un error de validación, no una predicción inventada.
Pruébalo
Define un campo prompt obligatorio.
Rechaza cadenas vacías o solo con espacios; fija límite de caracteres y comprueba el presupuesto de tokens con el tokenizer del modelo más la salida reservada. min_length por sí solo no rechaza espacios.
Carga una instancia al iniciar.
Prueba una entrada válida y otra inválida.
Comprueba tu resultado
La entrada válida produce un objeto con text; la vacía produce un error de validación y no llama al modelo.
Error frecuente: inicializar el modelo dentro del endpoint. Corrección: separa inicialización y solicitudes, y registra el fallo sin exponer datos internos.
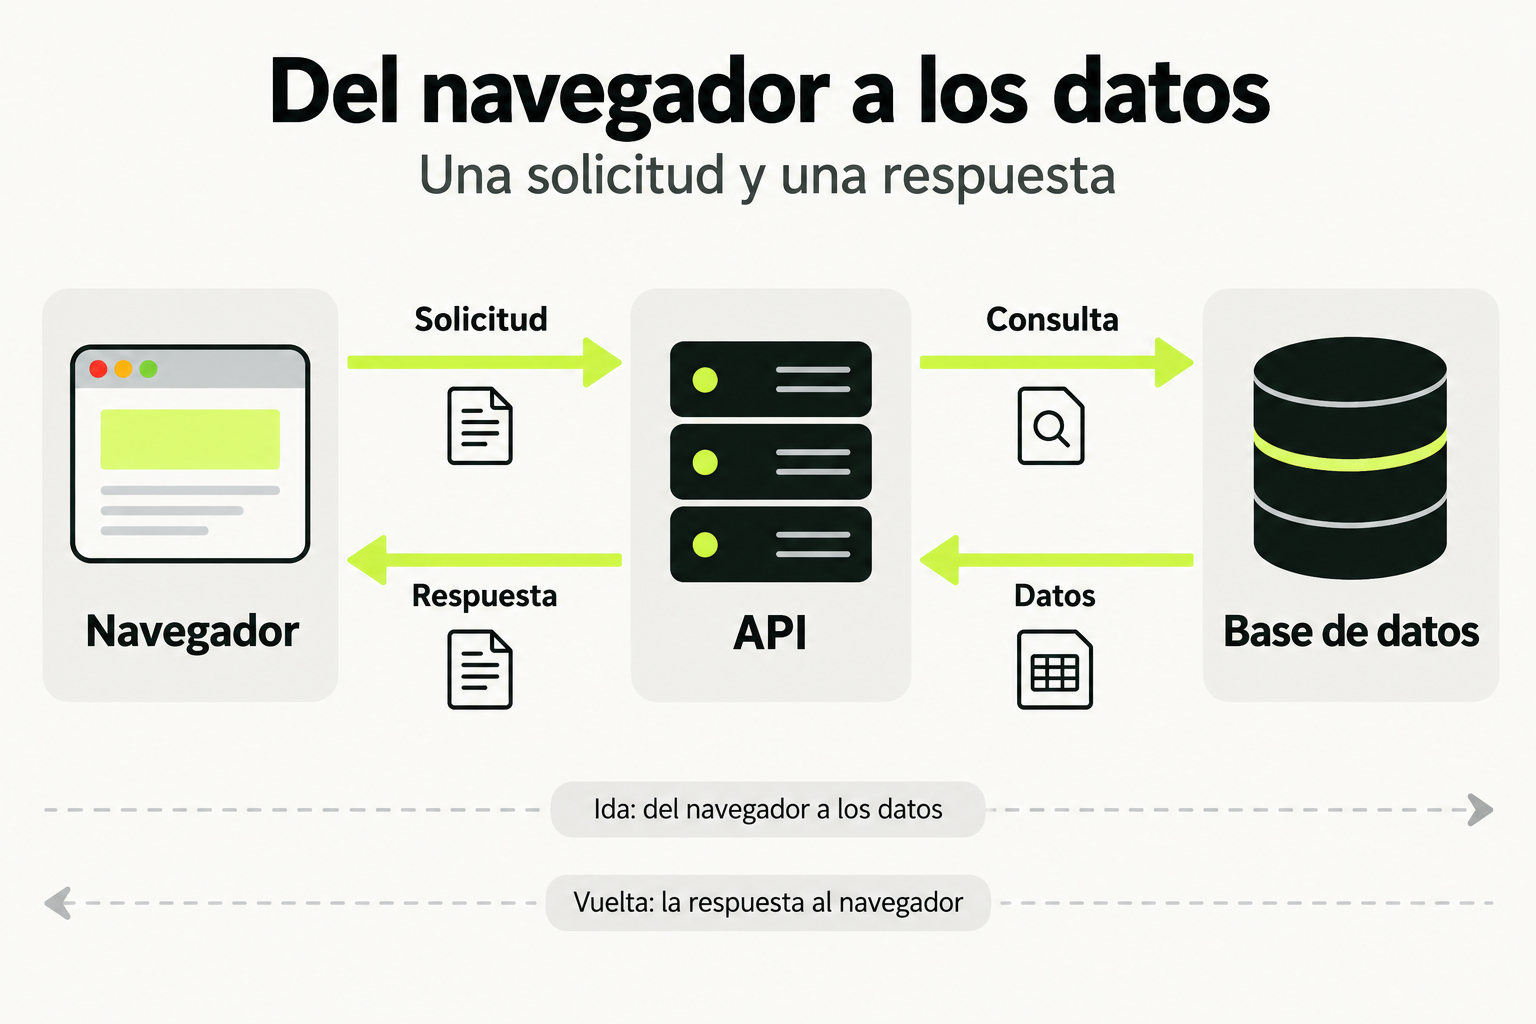
 Mapa de práctica
El navegador envía una solicitud a la API. El servidor valida la operación y consulta los datos; después devuelve una respuesta que el navegador puede mostrar. La base de datos se comunica con el servidor y no directamente con el navegador.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
Desplegar un modelo ajustado como API con FastAPI es el puente entre el desarrollo de ML y la producción. Imagina que tu modelo fine-tuneado es un chef experto que ha aprendido recetas específicas: la API es el restaurante donde los clientes (aplicaciones) piden platos (predicciones) sin conocer la cocina. FastAPI, un framework moderno de Python, actúa como el maître, gestionando solicitudes, validaciones y respuestas de forma eficiente, similar a como un sistema de reservas en un restaurante de alta gama optimiza la experiencia.
En el contexto de RLHF y DPO, desplegar no es solo servir predicciones; implica exponer un modelo que ha sido refinado con retroalimentación humana o preferencias, requiriendo manejo de estados complejos y latencia controlada. Piensa en ello como lanzar un nuevo servicio de atención al cliente basado en IA: la API debe ser robusta para manejar consultas variadas, asegurando que el modelo mantenga su comportamiento ético y efectivo aprendido durante el fine-tuning.
Cómo funciona en la práctica
Para implementar una API con FastAPI, sigue estos pasos clave, usando un modelo fine-tuneado con DPO como ejemplo:
- Preparación del entorno: Instala FastAPI y Uvicorn (servidor ASGI) en un entorno con Python 3.8+. Carga tu modelo ajustado (e.g., usando transformers de Hugging Face) y su tokenizador.
- Diseño de endpoints: Define endpoints RESTful. Por ejemplo,
/generatepara generación de texto, con parámetros comoprompt,max_length, ytemperature. - Implementación de lógica: En la función del endpoint, usa el modelo para generar respuestas. Incluye validación de entrada con Pydantic para evitar prompts maliciosos o largos excesivos.
- Optimización: Utiliza async/await para manejar múltiples solicitudes concurrentes, y considera cachear respuestas frecuentes para reducir latencia.
- Despliegue: Ejecuta con Uvicorn y configura un reverse proxy como Nginx para producción, monitoreando métricas como tiempo de respuesta y uso de GPU.
En un despliegue real, la latencia debe estar por debajo de 200ms para respuestas cortas, y el throughput puede escalar horizontalmente con contenedores Docker.
Caso de estudio
Supongamos que has fine-tuneado un modelo como Llama-3 con DPO para un asistente de código ético. Desplegarlo como API implica:
- Modelo: Llama-3-8B-DPO, ajustado con 10k pares de preferencias de código seguro vs. inseguro.
- Endpoint:
POST /code-reviewque acepta un JSON con{"code": "string", "language": "python"}. - Procesamiento: El API valida el input, tokeniza el código, ejecuta el modelo para generar una revisión (e.g., "Este código tiene riesgos de inyección SQL"), y devuelve un JSON con la revisión y una puntuación de seguridad.
- Resultado: En pruebas, el API maneja 50 solicitudes/segundo con una GPU A10G, integrado en un IDE como extensión que llama al endpoint via HTTPS.
| Métrica | Valor | Objetivo |
|---|---|---|
| Latencia p95 | 150ms | <200ms |
| Disponibilidad | 99.9% | 99.95% |
| Costo por 1M solicitudes | $50 | Minimizar |
Errores comunes
- No validar inputs: Aceptar prompts largos o con caracteres extraños puede causar errores de memoria o inyección. Solución: Usa Pydantic para definir esquemas estrictos y limita la longitud del prompt.
- Ignorar la concurrencia: Servir el modelo de forma síncrona bloquea solicitudes, reduciendo el throughput. Solución: Implementa endpoints async y usa pools de workers con Uvicorn.
- Falta de monitoreo: Desplegar sin métricas lleva a problemas no detectados como degradación del modelo. Solución: Integra herramientas como Prometheus para trackear latencia, errores y uso de recursos.
- Exponer detalles internos Devolver logs o stack traces en errores puede revelar vulnerabilidades. Solución: Configura manejo de excepciones genéricas y usa modos de debug solo en desarrollo.
- No planificar escalabilidad: Asumir que una sola instancia es suficiente para carga alta. Solución: Diseña para escalar horizontalmente con Kubernetes o servicios cloud, y usa balanceo de carga.
Checklist de dominio
- He configurado un entorno con FastAPI y Uvicorn, y cargado mi modelo fine-tuneado correctamente.
- He definido al menos un endpoint RESTful con validación de entrada usando Pydantic.
- He implementado lógica de generación que maneja prompts y devuelve respuestas en formato JSON estructurado.
- He probado la API localmente con herramientas como curl o Postman, verificando latencia y respuestas.
- He configurado un servidor de producción con Nginx como reverse proxy y SSL para seguridad.
- He integrado monitoreo básico (e.g., logs, métricas de salud) para detectar problemas en tiempo real.
- He documentado la API con OpenAPI (generado automáticamente por FastAPI) para que otros equipos la usen.
Implementa una API para un modelo fine-tuneado con RLHF
En este ejercicio, crearás una API con FastAPI para desplegar un modelo ajustado con RLHF, simulando un escenario real de ML Engineer. Sigue estos pasos:
- Prepara tu entorno: En un directorio nuevo, crea un entorno virtual de Python e instala
fastapi,uvicorn,pydantic, ytransformers. Usa un modelo pequeño como distilgpt2 fine-tuneado (puedes simularlo cargando el modelo base) para pruebas. - Diseña el endpoint: Crea un archivo
main.pyy define un endpointPOST /generateque acepte un JSON con camposprompt(string, máximo 500 caracteres) ymax_tokens(entero, default 50). Usa Pydantic para validar. - Implementa la generación: En la función del endpoint, carga el modelo y tokenizador, procesa el prompt, genera texto con el modelo, y devuelve un JSON como
{"response": "texto generado", "tokens_used": number}. - Agrega manejo de errores: Incluye try-except para capturar excepciones comunes (e.g., out-of-memory) y devuelve códigos HTTP apropiados (500 para errores internos).
- Ejecuta y prueba: Corre la API con
uvicorn main:app --reloady prueba con curl:curl -X POST http://localhost:8000/generate -H "Content-Type: application/json" -d '{"prompt": "Explica RLHF", "max_tokens": 30}'. Verifica que la respuesta sea válida y mide el tiempo. - Documenta: Accede a
http://localhost:8000/docspara ver la documentación automática de OpenAPI y asegúrate de que los esquemas estén claros.
Pistas
- Usa
async defpara la función del endpoint si esperas alta concurrencia, pero para pruebas simples,defes suficiente. - En la validación con Pydantic, define una clase como
class GenerateRequest(BaseModel)con los campos requeridos y restricciones. - Para manejar el modelo eficientemente, carga una sola vez al inicio de la app usando el evento
startupde FastAPI, en lugar de en cada solicitud.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.