

Lección 9 de 25 · Lectura y práctica
Práctica: Containeriza un pipeline completo de clasificación
Introducción: El Pipeline Completo en un Contenedor Hasta ahora, has aprendido a containerizar aplicaciones y scripts de Machine Learning de forma aislada. El siguiente paso, y el verdadero desafío en un entorno de producción, es.
Del concepto a la práctica
Taller de esta lección
Un pipeline completo debe aplicar exactamente las transformaciones aprendidas y luego clasificar. La práctica debe separar datos de entrenamiento, artefacto y servicio para que una imagen de inferencia no vuelva a entrenar inesperadamente al recibir una solicitud.
Ejemplo resuelto
Usa textos etiquetados: excelente soporte positivo, respuesta tardía negativo, solución rápida positivo y sin ayuda negativo. Entrena el pipeline, guarda el vectorizador junto al clasificador y expón una entrada de texto. El servicio devuelve clase y confianza, sin afirmar una precisión no medida.
Pruébalo
Divide entrenamiento y servicio en comandos distintos.
Genera el artefacto con un nombre versionado.
Construye la imagen que solo carga y predice.
Prueba un texto conocido y otro vacío.
Error frecuente: entrenar dentro del arranque de la API. Corrección: el entrenamiento es una etapa explícita; el servicio debe fallar si falta el artefacto requerido.
Comprueba tu resultado
Los cuatro textos de entrenamiento deben poder procesarse sin errores y el texto vacío debe rechazarse con una respuesta de cliente. Documenta la predicción observada para solución rápida y repite la llamada: la clase debe coincidir, aunque la confianza solo se reporte si el modelo la proporciona.
Textos, pipeline y resultados observados
El dataset completo de demostración es:
from sklearn.pipeline import make_pipeline
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.linear_model import LogisticRegression
import joblib
textos=["excelente soporte","respuesta tardía","solución rápida","sin ayuda"]
etiquetas=["positivo","negativo","positivo","negativo"]
modelo=make_pipeline(CountVectorizer(),LogisticRegression(random_state=42))
modelo.fit(textos,etiquetas)
joblib.dump(modelo,"sentimiento-1.joblib")
print(modelo.predict(["solución rápida"]).tolist())
Registra la clase observada con tu entorno resuelto; no inventes una precisión general a partir de cuatro frases. Este mini caso es sentimiento, distinto del contrato numérico del clasificador anterior. El vectorizador debe persistirse junto al estimador. Para una API textual, valida que text sea una cadena no vacía tras strip; {}, {"text":null} y {"text":" "} devuelven 400 antes de inferencia. La validación de etiquetas nuevas usa textos separados, por ejemplo «excelente ayuda» y «respuesta sin solución», con revisión humana de sus etiquetas; reporta sus resultados sin asegurar que el modelo los acierta. No loguees datos privados ni descargues datasets desconocidos para completar la práctica.
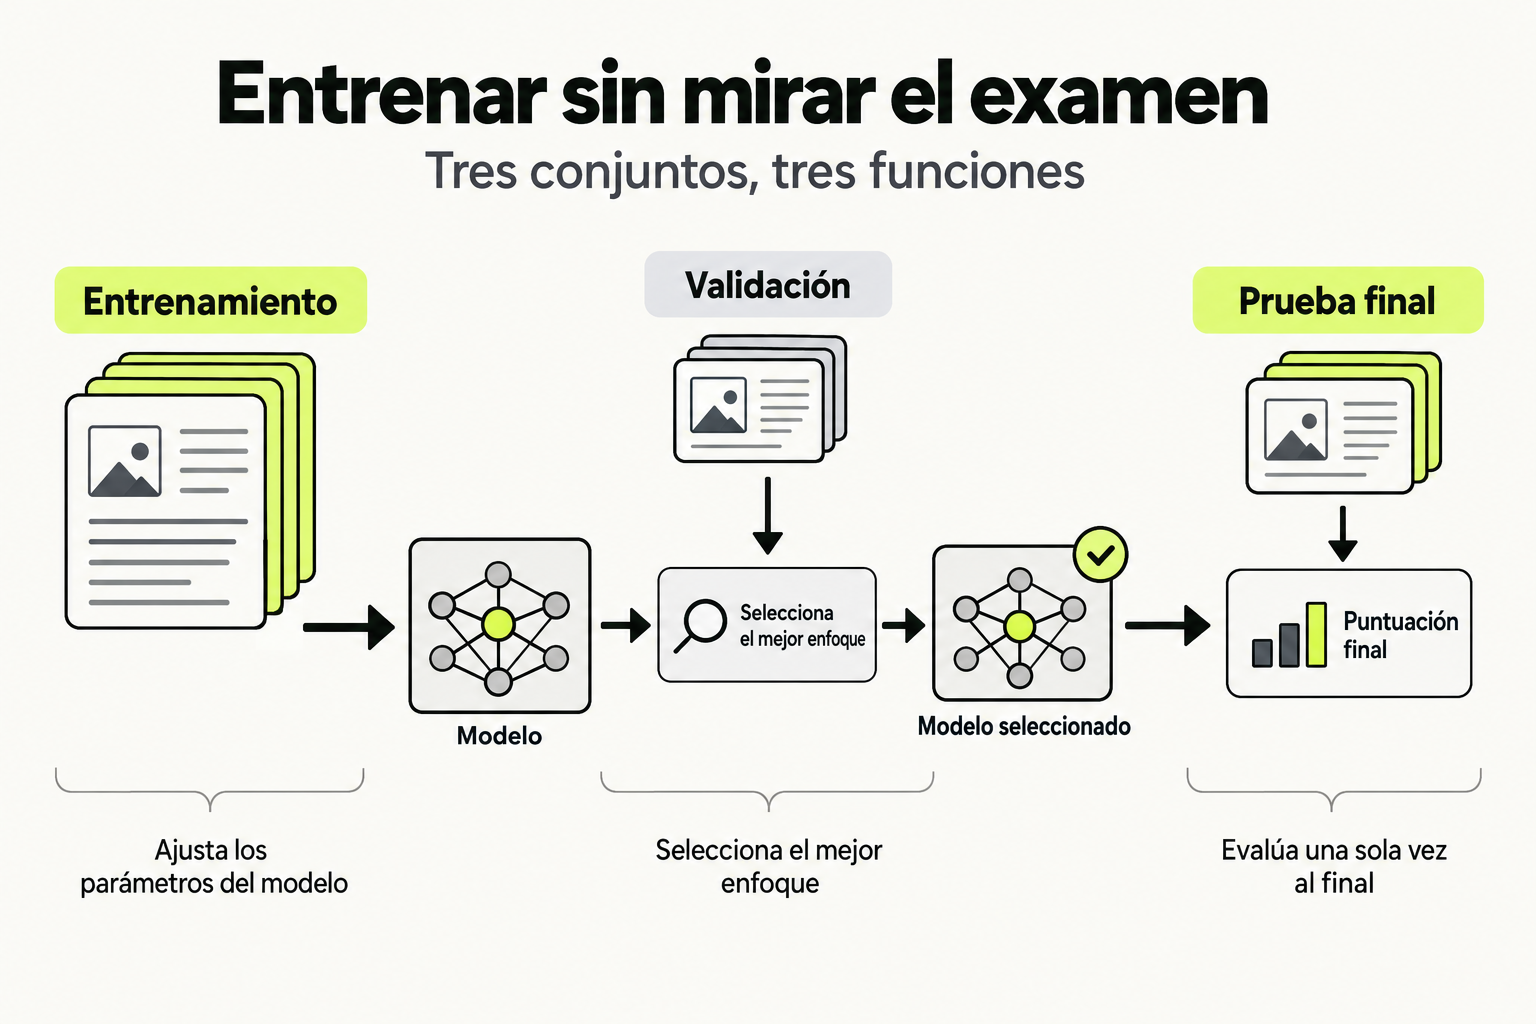
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Introducción: El Pipeline Completo en un Contenedor
Hasta ahora, has aprendido a containerizar aplicaciones y scripts de Machine Learning de forma aislada. El siguiente paso, y el verdadero desafío en un entorno de producción, es encapsular un pipeline completo de Machine Learning dentro de una imagen de Docker. Un pipeline completo no es solo el script de inferencia; abarca todas las etapas necesarias para que un modelo funcione de manera autónoma y reproducible: la carga y preprocesamiento de datos, la carga del modelo entrenado, la ejecución de predicciones y, potencialmente, el servicio de los resultados. Containerizar este flujo garantiza que se ejecutará exactamente igual en tu máquina de desarrollo, en el servidor de pruebas y en el clúster de producción, eliminando los temidos problemas de "en mi máquina sí funciona".
En esta lección práctica, vamos a construir un contenedor para un pipeline de clasificación de texto. Utilizaremos un modelo de clasificación de sentimientos (positivo/negativo) basado en un modelo simple de Bag of Words y Regresión Logística. El objetivo final es crear una imagen Docker que, al ejecutarse, pueda recibir nuevos textos y devolver su predicción de sentimiento. Este ejercicio integra conceptos de manejo de dependencias, gestión de artefactos (el modelo serializado), estructura de proyectos y configuración de puntos de entrada, preparando el terreno para orquestar múltiples de estos contenedores con Kubernetes en módulos posteriores.
Concepto Clave: El Contenedor como Unidad de Despliegue del Pipeline
Imagina un food truck. Para operar, no necesita depender de la infraestructura de una cocina restaurante; lleva todo consigo: los ingredientes (datos y modelo), los utensilios y electrodomésticos (bibliotecas y dependencias), el chef entrenado (el código del pipeline) y un mené definido (la API o interfaz de entrada/salida). Puede estacionarse en cualquier calle (servidor) que tenga los servicios básicos (un motor Docker) y funcionará inmediatamente, ofreciendo el mismo plato (predicción) con la misma calidad, sin importar la ubicación. Containerizar un pipeline completo es construir ese food truck para tu modelo de ML.
El contenedor encapsula la lógica de inferencia y su entorno de ejecución en una sola unidad inmutable. La lógica de inferencia incluye los pasos de preprocesamiento (como vectorización de texto) que deben ser idénticos a los usados durante el entrenamiento. El entorno incluye la versión específica de Python, Scikit-learn, Numpy y cualquier otra biblioteca. Esta inmutabilidad es crucial: asegura que el modelo no "se desvíe" debido a un cambio en una biblioteca subyacente o a una discrepancia en cómo se transforma una nueva entrada de datos.
Cómo Funciona en la Práctica: Paso a Paso
El proceso comienza con la estructuración de tu proyecto. Debes organizar tu código, datos de entrenamiento (o el modelo ya entrenado), y los scripts de manera clara. Un directorio típico incluiría: un script para entrenar el modelo (que se ejecutará fuera del contenedor para generar el artefacto), un script que define el pipeline de inferencia, un archivo de requisitos (requirements.txt), y el Dockerfile. El modelo entrenado (un archivo .pkl o .joblib) es un artefacto que se copiará a la imagen, convirtiéndose en parte de su sistema de archivos.
El siguiente paso es diseñar el punto de entrada del contenedor. Para esta práctica, haremos que el contenedor sea ejecutable: al iniciarse, esperará datos de entrada. Podemos implementar una interfaz simple por línea de comandos o preparar el terreno para una API web (por ejemplo, con Flask). En este ejemplo, haremos que el contenedor lea un texto pasado como argumento. El Dockerfile describirá cómo ensamblar la imagen: partirá de una imagen base de Python, copiará los archivos del proyecto, instalará las dependencias, definirá el directorio de trabajo y, finalmente, especificará el comando que se ejecutará cuando el contenedor se inicie.
Finalmente, construyes la imagen con docker build y la pruebas localmente con docker run, pasando textos de ejemplo. La magia ocurre cuando ese mismo contenedor, sin cambios, puede ser subido a un registro (como Docker Hub) y posteriormente desplegado en cualquier entorno que ejecute Docker, demostrando la portabilidad completa del pipeline de Machine Learning.
Código en Acción: Pipeline de Clasificación de Sentimientos
A continuación, se presenta la implementación completa de un proyecto para containerizar un clasificador de sentimientos. Primero, el script de entrenamiento que generará el modelo. Este se ejecuta una vez, fuera de Docker, para producir el archivo del modelo serializado.
# train_model.py
import pandas as pd
import pickle
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

# Datos de ejemplo (en un caso real, vendrían de un archivo o base de datos)
data = {
    'text': [
        'Me encanta este producto, es increíble',
        'Pésima experiencia, no lo recomiendo',
        'Está bien, cumple su función',
        'Lo mejor que he comprado en años',
        'Decepcionante, esperaba mucho más',
        'Funciona perfectamente, muy satisfecho'
    ],
    'sentiment': ['positive', 'negative', 'positive', 'positive', 'negative', 'positive']
}
df = pd.DataFrame(data)

# Definir y entrenar el pipeline (vectorizador + clasificador)
text_clf = Pipeline([
    ('vectorizer', CountVectorizer()),
    ('classifier', LogisticRegression())
])
text_clf.fit(df['text'], df['sentiment'])

# Guardar el pipeline entrenado (modelo + vectorizador) en un archivo
with open('sentiment_model.pkl', 'wb') as f:
    pickle.dump(text_clf, f)

print("Modelo entrenado y guardado como 'sentiment_model.pkl'")
Ahora, el script de inferencia que será el corazón de nuestro contenedor. Este script carga el modelo y realiza predicciones.
# predict.py
import pickle
import sys

def load_model(model_path='sentiment_model.pkl'):
    """Carga el pipeline del modelo serializado."""
    with open(model_path, 'rb') as f:
        model = pickle.load(f)
    return model

def predict_sentiment(text, model):
    """Realiza una predicción de sentimiento para el texto dado."""
    prediction = model.predict([text])
    return prediction[0]

if __name__ == '__main__':
    # Cargar el modelo una vez al iniciar
    clf = load_model()
    # Obtener el texto del primer argumento de línea de comandos
    if len(sys.argv) > 1:
        input_text = ' '.join(sys.argv[1:])
        result = predict_sentiment(input_text, clf)
        print(f"Texto: '{input_text}'")
        print(f"Sentimiento predicho: {result}")
    else:
        print("Por favor, proporciona un texto como argumento.")
        print("Ejemplo: python predict.py 'Este producto es fantástico'")
El archivo de dependencias y el Dockerfile que orquesta todo.
# requirements.txt
scikit-learn==1.3.0
pandas==2.0.3
numpy==1.24.3
# Dockerfile
# Usar una imagen base oficial de Python
FROM python:3.9-slim

# Establecer el directorio de trabajo dentro del contenedor
WORKDIR /app

# Copiar el archivo de requisitos e instalar las dependencias
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Copiar los archivos de la aplicación y el modelo entrenado
COPY predict.py .
COPY sentiment_model.pkl .

# Definir el comando por defecto al ejecutar el contenedor
ENTRYPOINT ["python", "predict.py"]
Con esta estructura en tu directorio de proyecto, construyes la imagen con: docker build -t sentiment-classifier .. Luego, la ejecutas pasando un texto como argumento: docker run --rm sentiment-classifier "El servicio fue rápido y eficiente". El contenedor cargará el modelo, procesará el texto y devolverá la predicción, todo en un entorno aislado y autónomo.
Errores Comunes y Cómo Evitarlos
1. Inconsistencia entre el preprocesamiento de entrenamiento e inferencia: Este es el error más crítico. Si vectorizas los textos de una manera durante el entrenamiento (por ejemplo, usando un vocabulario específico) y de otra en el contenedor (un vocabulario nuevo), las predicciones serán erróneas o fallarán.
Solución: Siempre guarda el preprocesador (como el CountVectorizer o TF-IDF) junto con el modelo, usando un Pipeline de Scikit-learn como hicimos en el ejemplo. Esto garantiza que las mismas transformaciones se apliquen durante la inferencia.
2. Imágenes de tamaño excesivo: Partir de imágenes base pesadas (como `python:3.9`) e instalar muchas dependencias innecesarias puede resultar en imágenes de varios GB, lo que ralentiza el despliegue y aumenta costos.
Solución: Usa imágenes base slim o alpine (ej: `python:3.9-slim`). Limpia la caché de apt o pip en la misma línea RUN. Considera usar etapas multi-stage si necesitas compilar dependencias.
3. No manejar correctamente las señales de terminación: Si tu contenedor ejecuta un servidor web (como Flask con `app.run()`), por defecto no es amigable con las señales de Docker (como `docker stop`), lo que puede llevar a que los contenedores se cierren abruptamente.
Solución: Usa un servidor WSGI de producción como Gunicorn, que maneja estas señales correctamente. Para scripts, asegúrate de atrapar las señales de terminación (SIGTERM) para realizar una limpieza adecuada.
4. Almacenar datos volátiles dentro de la capa de escritura del contenedor: Si tu aplicación escribe logs o datos temporales dentro del sistema de archivos del contenedor, se perderán al detenerlo y dificultarán el análisis.
Solución: Usa volúmenes Docker para persistir datos que deban sobrevivir al ciclo de vida del contenedor. Para logs, considera enviarlos a la salida estándar (stdout/stderr), que Docker puede redirigir a sistemas de logging centralizados.
5. Credenciales o secretos hardcodeados en la imagen: Incluir contraseñas, tokens de API o claves privadas directamente en el Dockerfile o en el código es un grave riesgo de seguridad, ya que quedan expuestos en cualquier registro.
Solución: Pasa los secretos en tiempo de ejecución mediante variables de entorno (con `-e` en `docker run`) o, mejor aún, utiliza los secretos gestionados de Docker Swarm o Kubernetes. Nunca los subas al control de versiones.
Checklist de Dominio
Antes de considerar que has dominado la containerización de un pipeline completo de ML, verifica que puedes realizar y comprender cada uno de estos puntos:
- Puedo estructurar un proyecto de ML con una separación clara entre el código de entrenamiento (fuera del contenedor) y el código de inferencia/servicio (dentro del contenedor).
- Sé cómo serializar y deserializar un modelo de ML, incluyendo cualquier objeto de preprocesamiento (usando pickle, joblib, o formatos ONNX), y copiarlo a la imagen Docker.
- Puedo escribir un Dockerfile eficiente que parta de una imagen base adecuada, instale dependencias desde un requirements.txt, copie los artefactos necesarios y defina un ENTRYPOINT o CMD correcto.
- Sé construir la imagen con `docker build`, etiquetarla apropiadamente y ejecutarla localmente con `docker run`, pasando argumentos o variables de entorno para configurarla.
- Comprendo la importancia de la inmutabilidad del contenedor y por qué el modelo y el preprocesador deben ser versionados y tratados como una sola unidad dentro de la imagen.
- Puedo identificar y solucionar problemas de tamaño de imagen, inconsistencia de dependencias y manejo de rutas de archivos dentro del contenedor.
- Sé cómo exponer puertos si mi contenedor sirve una API (por ejemplo, usando `EXPOSE` en el Dockerfile y `-p` en `docker run`).
- Entiendo los riesgos de seguridad básicos (como no ejecutar como root, no incluir secretos) y aplico prácticas para mitigarlos en mis Dockerfiles.
Sigue con Containerización y Despliegue de Modelos ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.