

Lección 19 de 25 · Lectura y práctica
Práctica: Configura autoescalado para un modelo de recomendación
Aprende práctica: configura autoescalado para un modelo de recomendación con esta lectura y práctica de Containerización y Despliegue de Modelos ML con Docker y Kubernetes.
Del concepto a la práctica
Taller de esta lección
En esta práctica, el objetivo es relacionar un manifiesto de servicio con una política HPA reproducible. El selector del Service debe coincidir con las etiquetas de los pods; de lo contrario, aunque el HPA escale, no habrá tráfico útil hacia las réplicas.
Ejemplo resuelto
Una configuración mínima usa app: recommendation-api en Deployment y Service. El Deployment solicita 200m por pod. Con 2 réplicas, un objetivo CPU de 75 %, mínimo 2 y máximo 5, una medición de 300m por pod produce techo(2 × 300/150) = 4 réplicas si el objetivo equivalente es 150m de consumo por pod. La cuenta debe basarse en el request real: 300/200 = 150 %, por tanto techo(2 × 150/75) = 4.
Pruébalo
Valida que ambos selectores sean idénticos.
Define requests antes de crear el HPA.
Aplica el manifiesto en un namespace local autorizado.
Consulta condiciones y eventos antes de cambiar parámetros.
Error frecuente: probar solo CPU y asumir que existe la métrica personalizada; corrige verificando cada adaptador disponible.
Comprueba tu resultado
Con 3 pods, request de 200m, consumo de 100m y objetivo de 50 %, el HPA debe calcular 3 réplicas. Un selector distinto debe producir servicio sin endpoints, no una prueba válida de escalado.
Dos métricas y contrato de recursos
Para reproducir el cálculo de esta práctica, modifica el Deployment del laboratorio a request CPU 200m y límite 500m, dos réplicas iniciales y misma etiqueta/Service app: clasificador. El ejemplo recommendation-api también funciona si cambias todos esos selectores juntos. El HPA debe tener target 75%, mínimo 2, máximo 5 y apuntar al Deployment real; no reutilices sin cambios la política de target70/request250 de la lección anterior.
Medición CPU por Pod 300m: utilización150%, techo(2×150/75)=4. Otra ventana de tres Pods/request200/consumo100/target50 produce3. Son cálculos ideales sujetos a tolerancia, métricas y estabilización; conserva un registro de condiciones antes y después. Para una prueba de carga limita duración y concurrencia y detén si se supera el presupuesto.
Una métrica personalizada de solicitudes requiere un adaptador y un contador que exista con etiquetas de namespace/Pod; Prometheus instalado no la expone automáticamente a HPA. Con dos métricas, el controlador calcula propuestas y elige la mayor; fallos de alguna métrica pueden impedir reducir. Para AverageValue de Pods, tres Pods promedian120 solicitudes/s con objetivo100: techo(3×120/100)=4. No declares tiempos de reacción de30–60s como garantía ni llames «funcional» una imagen ficticia no construida.
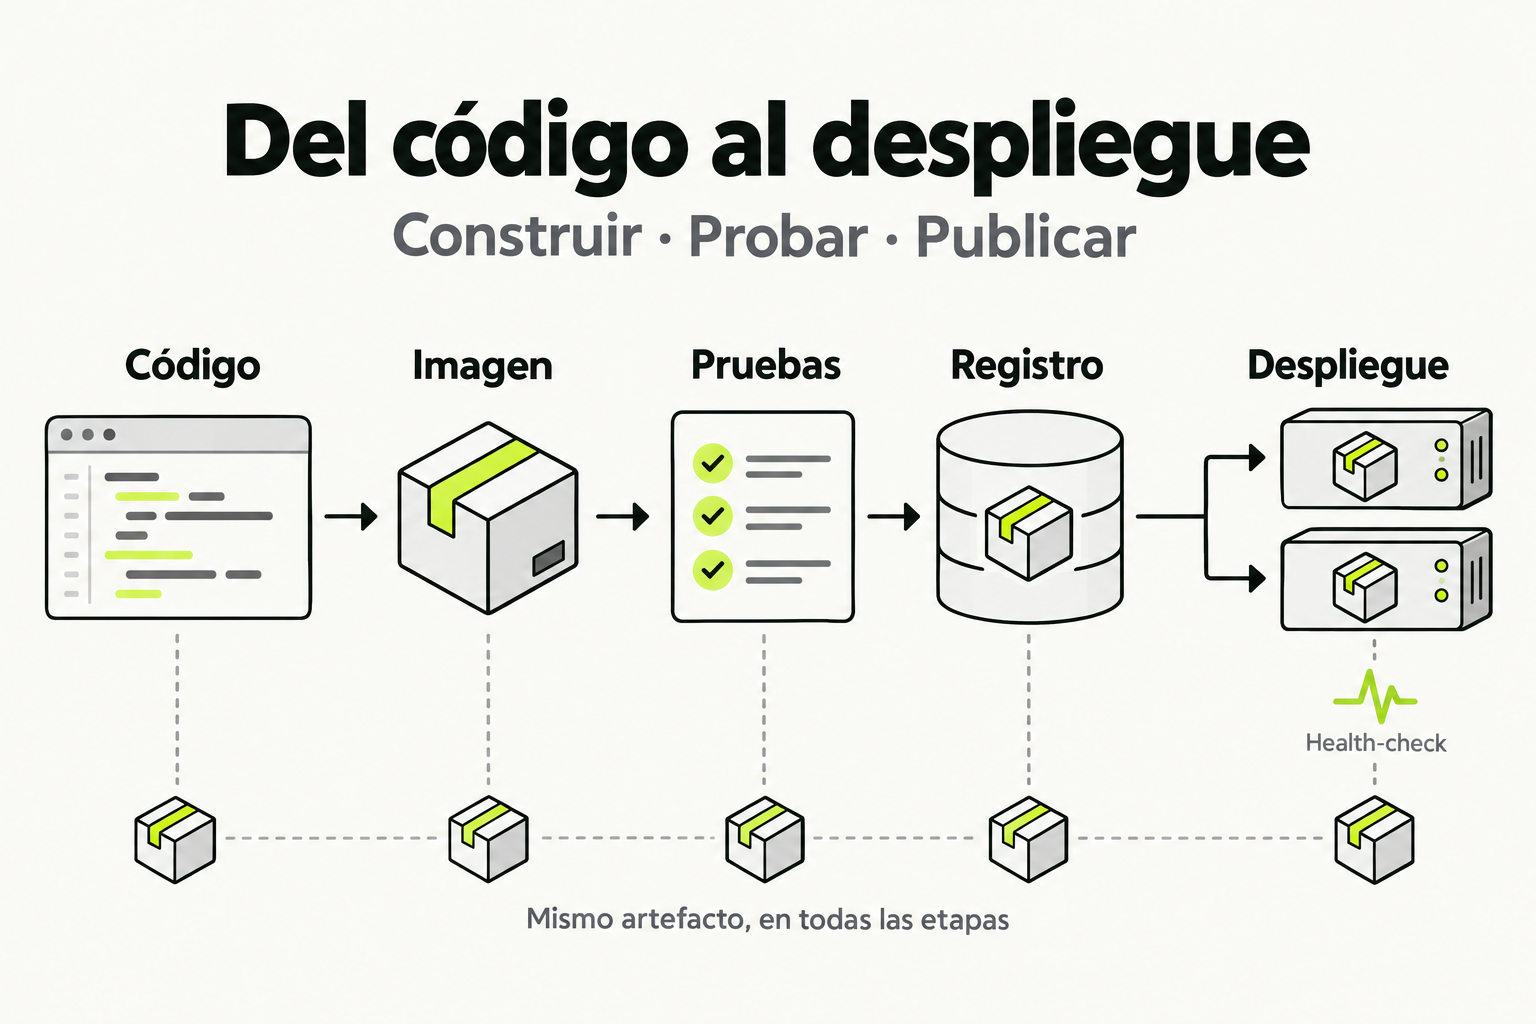
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Práctica: Configura autoescalado para un modelo de recomendación
En esta lección práctica, integraremos todos los conceptos de gestión de recursos y escalado en Kubernetes para garantizar que nuestro servicio de recomendación pueda manejar carga variable de manera eficiente y rentable. Pasaremos de tener un despliegue estático a uno dinámico que responde a la demanda en tiempo real, utilizando el Horizontal Pod Autoscaler (HPA) de Kubernetes. Configuraremos métricas personalizadas basadas en el uso de la CPU y el número de solicitudes por segundo, elementos críticos para un modelo que experimenta picos de uso, como durante eventos de ventas flash o lanzamientos de productos.
Concepto Clave: El Autoescalador Horizontal (HPA) y las Métricas Personalizadas
El Horizontal Pod Autoscaler (HPA) es un controlador de Kubernetes que automáticamente ajusta el número de réplicas de un Deployment, StatefulSet o algún otro recurso similar, para que coincida con la demanda observada. A diferencia del escalado vertical (aumentar los recursos de un solo pod), el HPA realiza un escalado horizontal, es decir, añade o elimina pods idénticos. Su decisión se basa en métricas. Inicialmente, Kubernetes soporta métricas de recursos como el uso de CPU y memoria. Sin embargo, para aplicaciones modernas como servicios de ML, estas métricas pueden no ser suficientes.
Aquí es donde entran las métricas personalizadas. Imagina que eres el gerente de una cadena de cafeterías. Escalar basándote solo en la "electricidad usada por cada cafetera" (CPU) es un indicador indirecto. Sería mucho mejor escalar basándote en "la longitud de la cola de clientes" o "el número de pedidos por minuto". De manera similar, para nuestro modelo de recomendación, una métrica como solicitudes_por_segundo es un indicador directo y más significativo de la carga de trabajo que el simple uso de CPU. Para usar estas métricas, necesitamos un adaptador de métricas, como el Metrics Server para métricas de recursos y Prometheus Adapter para exponer métricas personalizadas a la API de Kubernetes.
Tip: El HPA funciona en un ciclo de control continuo (por defecto cada 15-30 segundos). Evalúa las métricas, calcula el número deseado de réplicas y luego actúa sobre el recurso escalable (ej., Deployment). No es una reacción instantánea, sino un mecanismo de ajuste progresivo para evitar un escalado errático ("thrashing").
Cómo funciona en la práctica: Arquitectura y Flujo de Datos
Para implementar un autoescalado efectivo, debemos establecer una arquitectura de monitoreo. El flujo comienza con nuestra aplicación. El servicio del modelo de recomendación debe instrumentarse para exponer métricas, típicamente en un endpoint /metrics en formato compatible con Prometheus. Un agente de Prometheus (o un sidecar) recolecta estas métricas periódicamente y las almacena en una base de datos de series de tiempo. Paralelamente, el Metrics Server agrega el uso básico de recursos (CPU/memoria) de cada pod a través de la API de Kubernetes.
El componente clave es el Prometheus Adapter. Este servicio se configura con reglas para traducir las métricas almacenadas en Prometheus (como `http_requests_per_second`) en métricas que la API de métricas personalizadas de Kubernetes pueda entender. Cuando el HPA necesita evaluar una métrica personalizada, consulta esta API. El HPA entonces realiza su cálculo: (Valor Actual de la Métrica / Valor Objetivo de la Métrica) = Ratio Deseado de Réplicas. Si el ratio es mayor que 1, necesita más pods; si es menor, puede reducir pods. Finalmente, el HPA actualiza el campo `replicas` en la especificación del Deployment, y el controlador del Deployment se encarga de crear o eliminar pods para cumplir con el nuevo estado deseado.
Un ejemplo paso a paso durante un pico de tráfico sería: 1) Los usuarios aumentan, incrementando la métrica `http_requests_per_second`. 2) Prometheus la recolecta. 3) El HPA consulta la métrica a través del Adapter. 4) El HPA calcula que necesita, por ejemplo, 3 réplicas en lugar de 2. 5) El HPA modifica el Deployment. 6) El controlador del Deployment programa un nuevo pod. 7) El servicio de Kubernetes empieza a enviar tráfico al nuevo pod una vez esté listo. Este proceso toma de 30 a 60 segundos en condiciones normales.
Código en acción: Despliegue, Servicio y Configuración del HPA
A continuación, presentamos un ejemplo completo y funcional. Primero, definimos un Deployment para nuestro modelo de recomendación. Nota la inclusión de resources requests y limits, que son absolutamente críticos para que el HPA basado en CPU funcione correctamente. También definimos un contenedor para exponer métricas (simulado aquí).
1. Deployment y Servicio para el Modelo de Recomendación
# recommendation-deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: recommendation-model
  namespace: ml-production
  labels:
    app: recommendation-api
spec:
  replicas: 2 # Réplicas iniciales
  selector:
    matchLabels:
      app: recommendation-api
  template:
    metadata:
      labels:
        app: recommendation-api
      annotations:
        prometheus.io/scrape: "true"
        prometheus.io/port: "8000"
        prometheus.io/path: "/metrics"
    spec:
      containers:
      - name: model-api
        image: registry.company.com/ml/recommendation:v4.2.1
        ports:
        - containerPort: 8000
        env:
        - name: MODEL_PATH
          value: "/app/model.pkl"
        - name: THREADS
          value: "4"
        resources:
          requests:
            memory: "512Mi"
            cpu: "250m" # 0.25 núcleos de CPU. CRUCIAL para HPA de CPU.
          limits:
            memory: "1Gi"
            cpu: "500m" # 0.5 núcleos de CPU.
        livenessProbe:
          httpGet:
            path: /health
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10
        readinessProbe:
          httpGet:
            path: /ready
            port: 8000
          initialDelaySeconds: 5
          periodSeconds: 5
---
apiVersion: v1
kind: Service
metadata:
  name: recommendation-service
  namespace: ml-production
spec:
  selector:
    app: recommendation-api
  ports:
  - port: 80
    targetPort: 8000
  type: ClusterIP
Ahora, el componente central: el manifiesto del Horizontal Pod Autoscaler. Configuraremos uno que utilice dos métricas: el uso de CPU (métrica de recurso nativa) y una métrica personalizada de solicitudes por segundo.
2. Horizontal Pod Autoscaler (HPA) con Métrica de CPU y Personalizada
# recommendation-hpa.yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: recommendation-hpa
  namespace: ml-production
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: recommendation-model
  minReplicas: 2
  maxReplicas: 10
  metrics:
  # Métrica de recurso: Uso de CPU
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70 # Objetivo: 70% del CPU request (250m).
  # Métrica personalizada: Solicitudes por segundo
  - type: Pods
    pods:
      metric:
        name: http_requests_per_second
      target:
        type: AverageValue
        averageValue: 100 # Objetivo: 100 solicitudes/segundo por Pod en promedio.
  behavior: # Comportamiento de escalado para suavizar (v2beta2+)
    scaleUp:
      stabilizationWindowSeconds: 60
      policies:
      - type: Percent
        value: 100
        periodSeconds: 30
      - type: Pods
        value: 4
        periodSeconds: 30
      selectPolicy: Max
    scaleDown:
      stabilizationWindowSeconds: 300 # Más lento para bajar (5 minutos)
      policies:
      - type: Percent
        value: 10
        periodSeconds: 60
Para que la métrica personalizada `http_requests_per_second` esté disponible, necesitamos configurar el Prometheus Adapter. Esta configuración le dice al Adapter cómo traducir las consultas de Prometheus.
3. Configuración del Prometheus Adapter (Fragmento)
# prometheus-adapter-config.yaml (fragmento clave)
apiVersion: v1
kind: ConfigMap
metadata:
  name: prometheus-adapter-config
  namespace: monitoring
data:
  config.yaml: |
    rules:
    - seriesQuery: 'http_requests_total{namespace!="",pod!=""}'
      resources:
        overrides:
          namespace: {resource: "namespace"}
          pod: {resource: "pod"}
      name:
        matches: "^(.*)_total"
        as: "${1}_per_second" # Transforma _total en _per_second
      metricsQuery: 'rate(<<.Series>>{<<.LabelMatchers>>}[2m])' # Calcula la tasa
Errores comunes y cómo evitarlos
Implementar autoescalado conlleva varios escollos. Aquí detallamos los más frecuentes y cómo esquivarlos:
1. No definir `resources.requests` en el Deployment: Este es el error más común y fatal. El HPA basado en CPU calcula la utilización como (uso actual de CPU) / (CPU request). Si no se establece `requests.cpu`, el denominador es cero, causando un comportamiento impredecible o que el HPA no funcione. Solución: Siempre define `requests` para CPU y memoria, especialmente si usas autoescalado de recursos.
2. Objetivos de métrica (targets) poco realistas: Establecer un `averageUtilization` de CPU del 90% o un `averageValue` de solicitudes demasiado alto puede impedir que el HPA escale a tiempo, saturando los pods existentes. Por el contrario, un objetivo muy bajo provocará un escalado excesivo y costoso. Solución: Realiza pruebas de carga para entender los límites de tu aplicación y establece objetivos conservadores (ej., 60-75% para CPU).
3. Falta de readinessProbes o probes mal configuradas: Kubernetes puede terminar un pod viejo antes de que el nuevo esté listo para recibir tráfico, causando errores durante el escalado. Si el `readinessProbe` falla, el pod no se integra al Service. Solución: Implementa readinessProbes robustas que verifiquen que la aplicación (y el modelo) estén completamente cargados. Usa `initialDelaySeconds` adecuado.
4. Ignorar el comportamiento de escalado (`behavior`): Sin configurar `behavior`, el HPA puede reaccionar de forma brusca a picos temporales, escalando y desescalando rápidamente ("thrashing"), lo que es ineficiente y estresa el sistema. Solución: Utiliza los campos `scaleUp` y `scaleDown` de `behavior` (disponible en autoscaling/v2beta2+). Aplica una ventana de estabilización (`stabilizationWindowSeconds`) más larga para el desescalado (ej., 5 minutos) que para el escalado (ej., 1 minuto).
5. Métricas personalizadas con alta latencia o resolución incorrecta: Si la métrica en Prometheus se actualiza cada 5 minutos o la consulta `metricsQuery` usa un rango (`[2m]`) demasiado corto, el HPA tomará decisiones basadas en datos obsoletos o ruidosos. Solución: Asegura que el intervalo de scraping de Prometheus sea adecuado (ej., 15-30s) y que la ventana de la función `rate()` en `metricsQuery` sea al menos el doble del intervalo de scraping para suavizar.
Checklist de dominio
Antes de considerar esta práctica como dominada, verifica que puedes realizar o comprender cada uno de los siguientes puntos:
- Desplegar un modelo de ML como un Deployment en Kubernetes con requests y limits de recursos definidos correctamente.
- Explicar la diferencia entre escalado vertical (Vertical Pod Autoscaler) y horizontal (Horizontal Pod Autoscaler) y cuándo usar cada uno.
- Crear y aplicar un manifiesto HPA (v2) que escale basándose en al menos una métrica de recurso (CPU) y una métrica personalizada.
- Describir la arquitectura completa: Aplicación → Prometheus (métricas) → Prometheus Adapter → API de métricas personalizadas → HPA.
- Configurar correctamente las sondas (livenessProbe y readinessProbe) para garantizar la salud y el tráfico cero-downtime durante el escalado.
- Ajustar los parámetros de behavior del HPA (stabilizationWindowSeconds, policies) para evitar un escalado errático y optimizar costos.
- Monitorear el estado del HPA usando comandos como
kubectl describe hpae interpretar sus eventos y condiciones actuales. - Simular una carga en el servicio y verificar que el HPA crea y elimina réplicas automáticamente según la configuración.
Sigue con Containerización y Despliegue de Modelos ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.