

Lección 7 de 25 · Lectura y práctica
Creación de imágenes Docker con modelos entrenados
Aprende creación de imágenes docker con modelos entrenados con esta lectura y práctica de Containerización y Despliegue de Modelos ML con Docker y Kubernetes.
Del concepto a la práctica
Taller de esta lección
Empaquetar un modelo entrenado exige compatibilidad entre el formato serializado y las bibliotecas que lo cargan. La imagen debe incorporar el código de inferencia y una versión identificable del artefacto, pero no credenciales ni datos innecesarios.
Ejemplo resuelto
Un clasificador binario recibe [2,1] y devuelve clase 1. Guarda el pipeline como clasificador-soporte-1.joblib, copia solo ese archivo y carga el modelo al iniciar el proceso. Si el archivo falta, el servicio termina con un error explícito en lugar de devolver una predicción vacía.
Pruébalo
Entrena con un conjunto pequeño y guarda el pipeline completo.
Registra nombre y suma de comprobación del archivo.
Construye una imagen que lo cargue una vez.
Ejecuta dos predicciones y compara respuestas.
Error frecuente: serializar solo el estimador y olvidar el transformador. Corrección: guarda el pipeline que contiene transformación y estimación en el orden aplicado durante entrenamiento.
Comprueba tu resultado
Para la entrada [2,1], registra la clase obtenida por tu pipeline y úsala como referencia, sin inventar una clase universal. Las dos ejecuciones deben coincidir. Una prueba adicional sin el archivo debe fallar claramente y no crear un modelo alternativo silencioso.
Artefacto binario completo
Este clasificador de dos características no es Iris. Guarda el entrenamiento en train.py y ejecútalo en un entorno aislado cuya versión resuelta uses también en serving:
from sklearn.tree import DecisionTreeClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
import joblib
X=[[0,0],[1,0],[2,1],[3,1]]
y=[0,0,1,1]
modelo=make_pipeline(StandardScaler(),DecisionTreeClassifier(random_state=42))
modelo.fit(X,y)
joblib.dump(modelo,"clasificador-soporte-1.joblib")
Las entradas conocidas [2,1] y [0,0] deben devolver respectivamente 1 y 0; son comprobaciones de puntos de entrenamiento, no una evaluación independiente. Registra hash real, orden de características, clases y lockfile. Copia el archivo aprobado al contexto de la imagen de serving y cárgalo una vez por proceso. Si falta, falla el arranque. Solo deserializa artefactos propios confiables: joblib/pickle puede ejecutar código y no asegura compatibilidad entre versiones de scikit-learn. Persistencia.
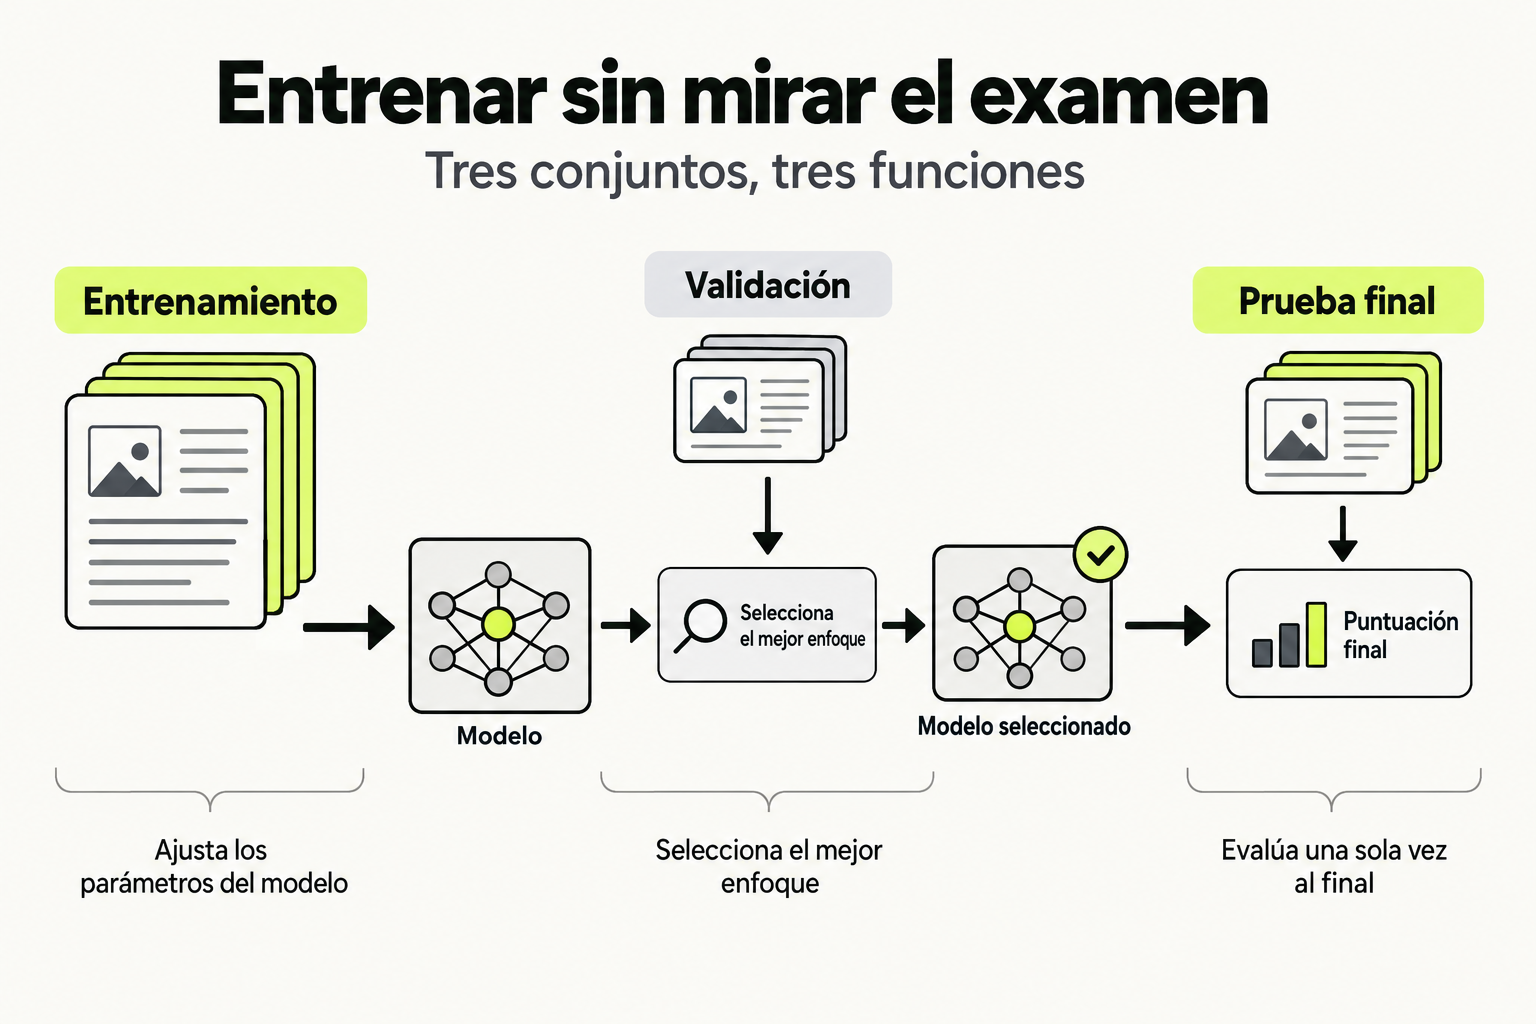
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Lección: Creación de imágenes Docker con modelos entrenados
En esta lección, aprenderás a encapsular un modelo de Machine Learning ya entrenado dentro de una imagen Docker. Este es un paso fundamental para transformar un artefacto de datos estático (un archivo .pkl, .h5, .joblib, etc.) en un servicio dinámico, reproducible y listo para desplegar en cualquier entorno. Pasaremos de tener un modelo en tu máquina local a tener un contenedor autónomo que puede realizar predicciones. Este proceso es la base para construir pipelines de ML robustos y escalables.
Concepto Clave: La Imagen Docker como Cápsula de Software
Imagina que tu modelo entrenado es una receta de cocina secreta y muy compleja. La receta no solo incluye los ingredientes (los pesos del modelo y la arquitectura), sino también instrucciones específicas sobre el tipo de horno (entorno de ejecución), los utensilios necesarios (bibliotecas como scikit-learn o TensorFlow), y el orden exacto de los pasos (el script de inferencia). Si intentas darle esta receta a otra persona, es probable que, a menos que tenga la misma cocina y utensilios que tú, el resultado no sea el mismo.
Una imagen Docker es el equivalente a empaquetar toda tu cocina, con los utensilios exactos, la temperatura preconfigurada y la receta ya cargada, dentro de una cápsula sellada. Esta cápsula puede enviarse a cualquier lugar (un servidor en la nube, la máquina de un compañero, un cluster de Kubernetes) y, al abrirla (ejecutar el contenedor), el entorno será idéntico al tuyo, garantizando que el modelo funcione exactamente igual. La imagen es el blueprint inmutable, mientras que el contenedor es la instancia en ejecución de esa imagen.
La potencia de Docker no es solo empaquetar el código, sino capturar y congelar todo el contexto necesario para que ese código se ejecute de manera fiable, desde el sistema operativo hasta las dependencias específicas.
Cómo funciona en la práctica: El Flujo de Dockerización
El proceso de crear una imagen Docker para un modelo entrenado sigue un flujo sistemático. Primero, debes preparar los artefactos: el archivo del modelo entrenado (por ejemplo, `modelo_random_forest.pkl`) y el código de inferencia (un script que carga el modelo y expone una función `predict`). Es crucial que este script de inferencia sea independiente del código de entrenamiento; solo debe preocuparse por cargar el modelo y procesar nuevas entradas.
Luego, se construye el Dockerfile, que es el manual de instrucciones para construir la imagen. Este archivo especifica: 1) La imagen base (por ejemplo, `python:3.9-slim`), 2) Los comandos para instalar dependencias (como `pip install scikit-learn pandas`), 3) La copia de tus archivos (modelo y script) al interior de la imagen, y 4) El comando que se ejecutará al iniciar el contenedor (por ejemplo, `python app.py`). Finalmente, usas el comando `docker build` para, siguiendo las instrucciones del Dockerfile, ensamblar todas las capas y crear la imagen lista para usar.
Una vez construida, puedes probar la imagen localmente ejecutando `docker run`, lo que generará un contenedor. Si tu script inicia un servidor web (usando Flask o FastAPI, por ejemplo), podrás enviar solicitudes HTTP con datos de entrada y recibir predicciones. Este mismo contenedor es el que luego puedes subir a un registro como Docker Hub o Google Container Registry para su distribución y despliegue en producción.
Código en acción: De un modelo .pkl a un servicio API
A continuación, veremos un ejemplo completo y funcional. Supongamos que tenemos un modelo de clasificación entrenado con Scikit-Learn, guardado como `model.pkl`, y queremos crear un servicio REST que reciba datos en JSON y devuelva predicciones.
Paso 1: Script de Inferencia (app.py)
Este script utiliza Flask para crear un endpoint `/predict`. Carga el modelo una vez al iniciar y define la lógica para recibir datos, transformarlos y devolver la predicción.
import pickle
import numpy as np
import pandas as pd
from flask import Flask, request, jsonify
import json

# Inicializar la aplicación Flask
app = Flask(__name__)

# Cargar el modelo entrenado (se ejecuta una sola vez al iniciar el contenedor)
with open('/app/model.pkl', 'rb') as f:
    model = pickle.load(f)

@app.route('/health', methods=['GET'])
def health():
    """Endpoint de salud para verificar que el servicio está vivo."""
    return jsonify({'status': 'healthy'}), 200

@app.route('/predict', methods=['POST'])
def predict():
    """
    Endpoint principal para predicciones.
    Espera un JSON con una clave 'features' que sea una lista de listas.
    """
    try:
        # 1. Obtener y parsear los datos de la solicitud
        data = request.get_json(force=True)
        features = data.get('features')

        if not features:
            return jsonify({'error': 'No se proporcionó la clave "features"'}), 400

        # 2. Convertir a DataFrame (asumiendo que el modelo fue entrenado con DataFrames)
        # En un caso real, aquí iría cualquier preprocesamiento necesario.
        input_df = pd.DataFrame(features)

        # 3. Realizar la predicción
        predictions = model.predict(input_df).tolist()

        # 4. Devolver la respuesta
        return jsonify({
            'predictions': predictions,
            'model_version': '1.0'
        })

    except Exception as e:
        # Log del error (en producción, usarías logging)
        print(f"Error durante la predicción: {e}")
        return jsonify({'error': str(e)}), 500

if __name__ == '__main__':
    # Ejecutar la app. '0.0.0.0' hace que esté disponible fuera del contenedor.
    app.run(host='0.0.0.0', port=5000, debug=False)  # ¡Debug False en producción!
Paso 2: El Dockerfile
Este archivo, llamado `Dockerfile` (sin extensión), define cómo se construye la imagen. Es fundamental ser específico con las versiones de las dependencias para garantizar la reproducibilidad.
# Usar una imagen base oficial de Python ligera
FROM python:3.9-slim

# Establecer un directorio de trabajo dentro del contenedor
WORKDIR /app

# Copiar el archivo de requisitos primero (para aprovechar la cache de Docker)
COPY requirements.txt .

# Instalar las dependencias de Python listadas en requirements.txt
RUN pip install --no-cache-dir -r requirements.txt

# Copiar el resto de los archivos de la aplicación
COPY app.py .
COPY model.pkl .

# Exponer el puerto en el que corre la aplicación Flask
EXPOSE 5000

# Definir el comando para ejecutar la aplicación
CMD ["python", "app.py"]
Paso 3: Archivo de Requisitos (requirements.txt)
Flask==2.3.3
scikit-learn==1.3.0
pandas==2.0.3
numpy==1.24.3
Paso 4: Comandos para Construir y Ejecutar
Con los tres archivos anteriores (`app.py`, `Dockerfile`, `requirements.txt`, `model.pkl`) en el mismo directorio, ejecuta:
# Construir la imagen. El punto (.) indica el contexto de construcción (directorio actual).
docker build -t mi-modelo-ml:version1 .

# Ejecutar un contenedor basado en esa imagen.
# -p 5000:5000 mapea el puerto 5000 del host al puerto 5000 del contenedor.
# -d ejecuta el contenedor en segundo plano (modo detached).
docker run -p 5000:5000 -d --name servicio-modelo mi-modelo-ml:version1

# Verificar que el contenedor está corriendo
docker ps

# Probar el endpoint de salud
curl http://localhost:5000/health

# Probar una predicción con datos de ejemplo (usando curl desde otra terminal)
curl -X POST http://localhost:5000/predict \
  -H "Content-Type: application/json" \
  -d '{"features": [[5.1, 3.5, 1.4, 0.2], [6.7, 3.1, 4.4, 1.4]]}'
Errores comunes y cómo evitarlos
Al dockerizar modelos ML, varios errores recurrentes pueden frustrar el proceso. Identificarlos temprano ahorra horas de depuración.
- Error 1: Imágenes gigantescas. Usar imágenes base como `python:3.9` (sin `-slim`) o instalar paquetes innecesarios (como `matplotlib`, `jupyter` en producción) infla la imagen. Esto ralentiza las transferencias y despliegues. Solución: Usa imágenes base ligeras (`-slim`, `-alpine`), limpia la cache de `apt` o `pip` en la misma línea `RUN`, y solo instala las dependencias estrictamente necesarias para la inferencia.
- Error 2: Modelo no encontrado (FileNotFoundError). El script intenta cargar el modelo desde una ruta incorrecta dentro del contenedor. Solución: Recuerda que el sistema de archivos del contenedor es aislado. Usa rutas absolutas definidas por tu `WORKDIR` en el Dockerfile (por ejemplo, `/app/model.pkl`) y verifica con `COPY` que el archivo se haya copiado correctamente.
- Error 3: Incompatibilidad de versiones. El modelo fue entrenado con scikit-learn 1.2.0, pero en el contenedor se instala la 1.3.0. Algunos modelos pueden fallar al deserializarse. Solución: Congela las versiones exactas en `requirements.txt`. Considera usar `pip freeze` desde tu entorno de entrenamiento para generar este archivo. La reproducibilidad es clave.
- Error 4: No exponer el puerto correcto. Tu aplicación Flask corre en el puerto 5000 dentro del contenedor, pero olvidaste usar `EXPOSE 5000` en el Dockerfile o `-p 5000:5000` en `docker run`. El servicio será inaccesible desde fuera del contenedor. Solución: Usa siempre `EXPOSE` en el Dockerfile para documentación y el flag `-p` en `docker run` para mapear puertos. Verifica con `docker port <nombre_contenedor>`.
- Error 5: Credenciales o secretos hardcodeados en la imagen. Incluir API keys, contraseñas de bases de datos o tokens directamente en el código o en la imagen es un grave riesgo de seguridad. Solución: Usa variables de entorno (con `ENV` en Dockerfile o `-e` en `docker run`) o, mejor aún, monta volúmenes secretos en tiempo de ejecución (especialmente en Kubernetes con Secrets). Nunca subas imágenes con secretos a registros públicos.
Checklist de dominio
Antes de considerar que dominas la creación de imágenes Docker con modelos entrenados, asegúrate de poder verificar cada uno de los siguientes puntos:
- Puedo identificar y separar claramente el código de entrenamiento del código de inferencia/servicio.
- Sé construir un Dockerfile eficiente que utilice una imagen base ligera y minimice el número de capas (usando `&&` en comandos RUN y un buen orden de COPY).
- Puedo explicar la diferencia entre `COPY` y `ADD` en un Dockerfile y cuándo usar cada uno (generalmente, siempre `COPY`).
- Entiendo el propósito de las instrucciones `WORKDIR`, `EXPOSE` y `CMD` (vs `ENTRYPOINT`) en un Dockerfile.
- Sé cómo gestionar dependencias de forma reproducible mediante un archivo `requirements.txt` con versiones fijas.
- Puedo construir una imagen (`docker build`), ejecutar un contenedor a partir de ella (`docker run` con mapeo de puertos), y probar los endpoints de servicio manualmente (con `curl` o Postman).
- Sé cómo inspeccionar una imagen creada (`docker image history`, `docker image inspect`) y un contenedor en ejecución (`docker logs`, `docker exec`).
- Comprendo los riesgos de seguridad de incluir datos sensibles en la imagen y conozco alternativas (variables de entorno, secretos).
Sigue con Containerización y Despliegue de Modelos ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.