

Lección 11 de 25 · Lectura y práctica
Arquitectura de Kubernetes: Por qué es ideal para ML en producción
Arquitectura de Kubernetes: Por qué es ideal para ML en producción La transición de un modelo de Machine Learning desde un entorno de experimentación, como un Jupyter Notebook, a un sistema de producción robusto, escalable y.
Del concepto a la práctica
Taller de esta lección
Kubernetes permite declarar un estado deseado y reconciliarlo, pero no convierte automáticamente un modelo en confiable. Para ML son especialmente útiles la separación entre Pods y Services, la recuperación de instancias y la actualización controlada de imágenes.
Ejemplo resuelto
Declara un Deployment con tres réplicas de clasificador:1.0 y un Service que selecciona la etiqueta app=clasificador. El Service conserva un punto de acceso aunque un Pod sea reemplazado. La API no debe guardar una sesión local que otra réplica no pueda recuperar.
Pruébalo
Dibuja el flujo cliente, Service, Pod y contenedor.
Relaciona etiquetas del Deployment y selector del Service.
Indica qué estado debe salir del Pod.
Cambia la imagen a
1.1y observa el reemplazo.
Error frecuente: confundir tres réplicas con tres versiones del modelo. Corrección: réplicas son instancias del mismo estado deseado; una versión se identifica mediante la imagen y su configuración.
Comprueba tu resultado
El Service debe seleccionar exactamente los Pods con la etiqueta prevista. El número deseado y disponible debe ser tres. Durante el cambio de imagen, registra qué Pods pertenecen a cada versión y confirma que no se almacenan predicciones únicamente en el disco efímero del Pod.
Deployment y Service con contrato completo
Construye clasificador:prueba-1 con el app.py y artefacto de las lecciones 7–8, usando un lockfile y un usuario no root. Haz la imagen accesible al clúster local antes de aplicar este laboratorio en su namespace de práctica:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cursalo-clasificador
spec:
  replicas: 3
  selector:
    matchLabels: {app: clasificador}
  template:
    metadata:
      labels: {app: clasificador}
    spec:
      automountServiceAccountToken: false
      securityContext:
        runAsUser: 1000
        runAsNonRoot: true
        seccompProfile: {type: RuntimeDefault}
      containers:
      - name: api
        image: clasificador:prueba-1
        imagePullPolicy: IfNotPresent
        command: [python, -B, app.py]
        ports:
        - {name: http, containerPort: 5000}
        resources:
          requests: {cpu: 250m, memory: 256Mi}
          limits: {cpu: 500m, memory: 512Mi}
        readinessProbe:
          httpGet: {path: /ready, port: http}
        livenessProbe:
          httpGet: {path: /health, port: http}
        startupProbe:
          httpGet: {path: /ready, port: http}
          failureThreshold: 30
          periodSeconds: 2
        securityContext:
          allowPrivilegeEscalation: false
          readOnlyRootFilesystem: true
          capabilities: {drop: [ALL]}
---
apiVersion: v1
kind: Service
metadata:
  name: cursalo-clasificador
spec:
  type: ClusterIP
  selector: {app: clasificador}
  ports:
  - {name: http, port: 80, targetPort: http}
La imagen debe poner archivos legibles en /app y definir WORKDIR /app; la API no escribe allí. El arranque usa el servidor local solo como laboratorio. Docker Engine ya no es un runtime directamente integrado mediante dockershim en Kubernetes actual: la interfaz es CRI, normalmente containerd o CRI-O; las imágenes Docker/OCI siguen siendo utilizables. Declarar tres réplicas no confirma tres listas: observa availableReplicas, sondas y EndpointSlices. RollingUpdate no implica reiniciar siempre todos los Pods a la vez ni garantiza disponibilidad sin capacidad y aplicación saludable.
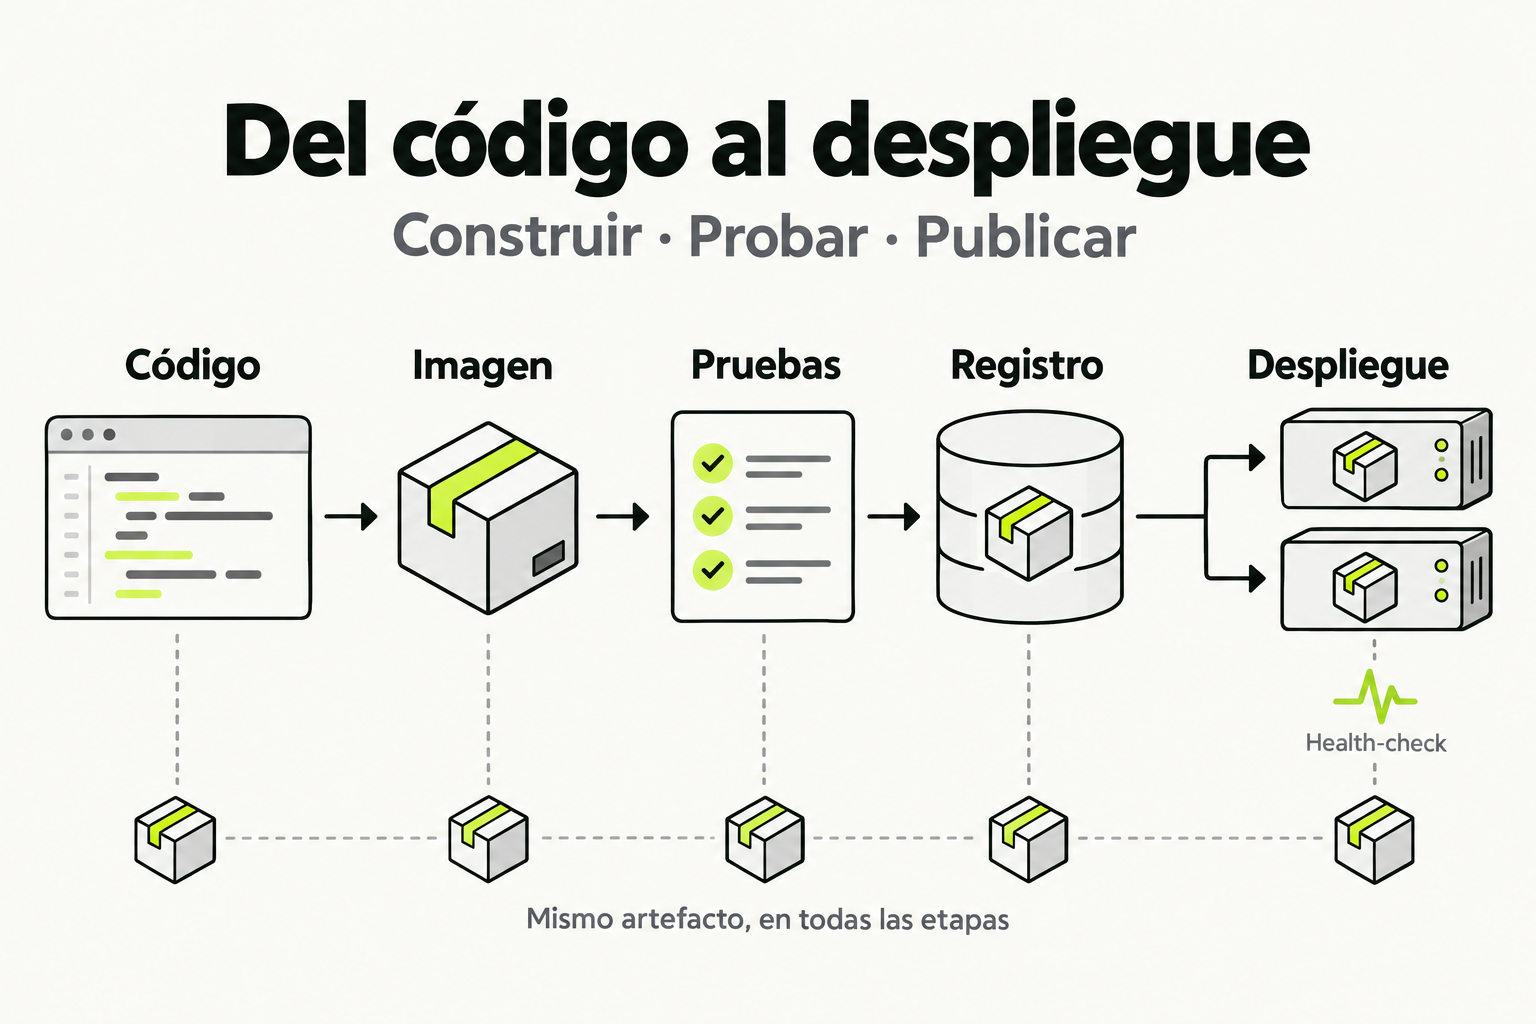
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Arquitectura de Kubernetes: Por qué es ideal para ML en producción
La transición de un modelo de Machine Learning desde un entorno de experimentación, como un Jupyter Notebook, a un sistema de producción robusto, escalable y confiable es uno de los desafíos más significativos en el ciclo de vida del ML. Es aquí donde Kubernetes emerge no como una opción más, sino como la plataforma fundamental. Kubernetes, en esencia, es un sistema de orquestación de contenedores de código abierto que automatiza el despliegue, el escalado y la gestión de aplicaciones en contenedores. Para los equipos de ML, esto se traduce en la capacidad de gestionar cargas de trabajo complejas, desde servicios de inferencia en tiempo real hasta pipelines de entrenamiento distribuido, con un nivel de control y automatización que las soluciones ad-hoc o las máquinas virtuales simples no pueden igualar.
La arquitectura de Kubernetes está diseñada desde sus cimientos para ser resiliente, extensible y declarativa. En lugar de dar órdenes imperativas ("ejecuta esta réplica ahora"), defines el estado deseado de tu sistema (por ejemplo, "necesito 5 réplicas de mi modelo de clasificación de imágenes funcionando siempre"). El Plano de Control de Kubernetes se encarga constantemente de reconciliar la realidad con ese estado deseado. Esta filosofía es perfecta para la producción de ML, donde los requisitos de disponibilidad, el manejo de picos de tráfico impredecibles y la necesidad de actualizar modelos sin interrupciones son críticos. Kubernetes proporciona las primitivas necesarias para construir sistemas que no solo despliegan un modelo, sino que lo hacen de manera inteligente y autónoma.
Concepto Clave: El Estado Deseado y la Reconcilación
El núcleo filosófico y técnico de Kubernetes es el principio del Estado Deseado. Imagina que eres el director de una orquesta sinfónica. Tu partitura (el archivo de configuración YAML en Kubernetes) define exactamente cómo debe sonar la pieza: cuántos violines, cuándo deben entrar los timbales, el tempo, etc. Tú, como director, no le dices a cada músico nota por nota qué tocar en cada milisegundo. En su lugar, estableces la visión (el estado deseado) y confías en que los músicos (los componentes de Kubernetes) la ejecuten. Si un violinista se enferma (un pod falla), el sistema lo detecta y llama a un sustituto (programa un nuevo pod en un nodo sano) para mantener la sinfonía en perfecta armonía. Este proceso automático de detección y corrección se llama Reconciliación.
Para un modelo de ML en producción, esto es revolucionario. Tu "estado deseado" puede ser: "Quiero un servicio que sirva predicciones del modelo ResNet-50, con 3 réplicas para alta disponibilidad, que utilice 2 GB de RAM y 1 CPU cada una, que sea accesible a través de la URL `api.miempresa.com/predict`, y que se escale automáticamente a 10 réplicas si la carga de CPU supera el 70%". Una vez que defines esto en un manifiesto de Kubernetes, el plano de control trabaja incansablemente para hacerlo realidad y mantenerlo así, sin intervención manual. Esto abstrae la complejidad operativa y te permite centrarte en lo que importa: el modelo y la lógica de negocio.
Componentes de la Arquitectura: Nodos y Plano de Control
La arquitectura de Kubernetes se divide en dos partes principales: el Plano de Control (o maestro) y los Nodos (o workers). El Plano de Control es el cerebro de la operación. Está compuesto por componentes como el kube-apiserver (el punto de entrada para todas las interacciones, como un portero muy inteligente), el etcd (una base de datos clave-valor de alta consistencia que almacena todo el estado del clúster, es la "memoria" del sistema), el kube-scheduler (que decide en qué nodo se ejecutará cada carga de trabajo, como un gerente de recursos) y el kube-controller-manager (que ejecuta los procesos de control que realizan la reconciliación, como el controlador de replicación). En producción, el plano de control suele estar replicado para alta disponibilidad.
Los Nodos son las máquinas (físicas o virtuales) donde realmente se ejecutan las cargas de trabajo de tus modelos de ML. Cada nodo tiene tres componentes clave: el kubelet, un agente que se comunica con el plano de control y se asegura de que los contenedores se estén ejecutando en un Pod (la unidad atómica de despliegue en Kubernetes); el kube-proxy, que maneja las reglas de red para permitir la comunicación hacia y desde tus servicios; y un Container Runtime (como Docker o containerd), que es el software responsable de ejecutar los contenedores. Cuando despliegas un modelo, el scheduler asigna sus Pods a estos nodos, y el kubelet en cada nodo se encarga de ponerlo en marcha.
Tip para ML: En entornos de nube, los nodos pueden ser instancias especializadas (como máquinas con GPUs para inferencia de modelos complejos o entrenamiento). Kubernetes puede gestionar estos recursos heterogéneos sin problemas. Puedes usar labels y taints/tolerations para asegurar que tu modelo que requiere GPU se despliegue únicamente en los nodos que la tengan.
Cómo funciona en la práctica: Desplegando un Modelo de Inferencia
Vamos a seguir el flujo paso a paso cuando un científico de datos quiere desplegar un nuevo modelo de clasificación de texto. Primero, el modelo es "dockerizado" y su imagen se sube a un registro (como Docker Hub o Google Container Registry). Luego, el científico (o un pipeline de CI/CD) crea un archivo de manifiesto en YAML que describe el Deployment de Kubernetes. Este archivo define el estado deseado: la imagen del contenedor, el número de réplicas, los recursos necesarios (CPU/RAM), y posibles checks de salud (liveness y readiness probes). Este archivo se envía al kube-apiserver mediante la herramienta de línea de comandos `kubectl`.
El kube-apiserver valida la solicitud y almacena la nueva definición del objeto en etcd. Este cambio es detectado por el kube-controller-manager (específicamente, el controlador del Deployment). El controlador se da cuenta de que el estado actual (0 réplicas) no coincide con el estado deseado (3 réplicas), por lo que crea objetos ReplicaSet. A su vez, el controlador del ReplicaSet crea los objetos Pod. El kube-scheduler, al ver los Pods pendientes, evalúa los nodos disponibles (sus recursos, labels, etc.) y asigna cada Pod a un nodo específico. Finalmente, el kubelet en cada nodo asignado recibe la orden, descarga la imagen del registro a través del Container Runtime, y ejecuta el contenedor con tu modelo de ML. Todo este proceso, desde el `kubectl apply` hasta tener 3 instancias de tu modelo corriendo, ocurre en segundos.
Código en acción: Manifiesto para un Servicio de Inferencia con Escalado Automático
A continuación, un ejemplo completo y funcional de un manifiesto de Kubernetes que despliega un servicio de inferencia para un modelo de ML, incluyendo un Deployment, un Service para exponerlo, y un HorizontalPodAutoscaler (HPA) para escalado automático basado en CPU. Asume que tenemos una imagen llamada `mi-usuario/modelo-sentimiento:1.0` en un registro accesible.
# deployment-modelo-ml.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: modelo-sentimiento-deployment
  labels:
    app: modelo-sentimiento
spec:
  replicas: 3 # Estado deseado inicial: 3 réplicas
  selector:
    matchLabels:
      app: modelo-sentimiento
  template:
    metadata:
      labels:
        app: modelo-sentimiento
    spec:
      containers:
      - name: modelo-sentimiento-container
        image: mi-usuario/modelo-sentimiento:1.0
        ports:
        - containerPort: 5000 # Puerto interno del contenedor
        env:
        - name: MODEL_PATH
          value: "/app/model.pkl"
        resources:
          requests: # Recursos mínimos garantizados
            memory: "512Mi"
            cpu: "250m" # 250 milicores (0.25 CPU)
          limits:   # Límites máximos
            memory: "1Gi"
            cpu: "500m" # 0.5 CPU
        livenessProbe:
          httpGet:
            path: /health
            port: 5000
          initialDelaySeconds: 30
          periodSeconds: 10
        readinessProbe:
          httpGet:
            path: /ready
            port: 5000
          initialDelaySeconds: 5
          periodSeconds: 5
---
apiVersion: v1
kind: Service
metadata:
  name: modelo-sentimiento-service
spec:
  selector:
    app: modelo-sentimiento
  ports:
    - protocol: TCP
      port: 80       # Puerto del servicio en el clúster
      targetPort: 5000 # Puerto del contenedor al que redirige
  type: LoadBalancer # En la nube, crea un balanceador de carga externo
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: modelo-sentimiento-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: modelo-sentimiento-deployment
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70 # Escala si el uso promedio de CPU supera el 70%
Para aplicar este manifiesto y desplegar tu modelo, guarda el código en un archivo `deployment.yaml` y ejecuta:
kubectl apply -f deployment.yamlEste comando enviará la configuración al API Server. En unos momentos, tendrás 3 pods ejecutándose, un servicio que los agrupa y balancea la carga, y un HPA vigilando la métrica de CPU. Puedes verificar el estado con `kubectl get pods,svc,hpa`.
Errores comunes y cómo evitarlos
Al comenzar con Kubernetes para ML, es fácil caer en ciertos errores que pueden causar dolores de cabeza en producción.
1. Olvidar los Liveness y Readiness Probes: Sin estas sondas, Kubernetes no sabe si tu contenedor está realmente vivo y listo para recibir tráfico. Un modelo puede tardar 30 segundos en cargar los pesos en memoria; si no hay una `readinessProbe`, el servicio enviará tráfico a un pod que aún no está listo, causando errores. Solución: Siempre implementa endpoints `/health` y `/ready` en tu aplicación de modelo y configúralas en el manifiesto.
2. No definir Límites de Recursos (resources.limits/requests): Esto es crítico para ML, donde los modelos pueden ser voraces en memoria. Si no se establecen límites, un pod puede consumir toda la memoria de un nodo, causando que Kubernetes mate (`OOMKill`) otros pods o colapse el nodo. Solución: Siempre especifica `requests` y `limits` para memoria y CPU basándote en perfiles de carga reales. Usa herramientas como `kubectl top pod` para monitorizar.
3. Usar la Estrategia de Actualización por Defecto (RollingUpdate sin configuración): Al actualizar la imagen del modelo a una nueva versión, la estrategia por defecto puede causar interrupciones si todos los pods se reinician a la vez. Solución: Configura `strategy.type: RollingUpdate` con `maxUnavailable: 1` y `maxSurge: 1` para garantizar que siempre haya pods disponibles durante el despliegue.
4. Manejo Inadecuado de Secretos para Credenciales del Modelo: Hardcodear API keys, contraseñas de registros de modelos o conexiones a bases de datos en el código de la imagen o en los manifiestos es un grave riesgo de seguridad. Solución: Usa el objeto Secret de Kubernetes para almacenar información sensible y montarlo como variables de entorno o archivos en el pod de forma segura.
5. Ignorar la Afinidad/Nodo para Recursos Especiales (GPU): Si tu modelo requiere GPU y lo despliegas sin configuraciones de nodo, terminará en una máquina sin GPU y fallará silenciosamente o tendrá un rendimiento pésimo. Solución: Usa nodeSelector, affinity o taints/tolerations para asegurar que los pods se programen en nodos con las capacidades hardware necesarias.
Checklist de dominio
Antes de considerar que comprendes por qué la arquitectura de Kubernetes es ideal para ML en producción, verifica que puedes explicar o realizar lo siguiente:
- Explicar la diferencia entre el Estado Deseado y el proceso de Reconciliación usando una analogía del mundo real.
- Nombrar los cuatro componentes principales del Plano de Control y la función de cada uno en el despliegue de un modelo.
- Describir la función del kubelet y el Container Runtime dentro de un nodo worker.
- Escribir un manifiesto YAML básico para un Deployment que incluya: definición de contenedor, puertos, solicitudes y límites de recursos, y sondas de salud.
- Identificar cuándo usar un Service de tipo ClusterIP vs. LoadBalancer para exponer un modelo interno o uno público.
- Configurar un HorizontalPodAutoscaler (HPA) para escalar un deployment basado en el uso de CPU.
- Listar al menos tres errores comunes al desplegar modelos en Kubernetes y sus estrategias de mitigación.
- Explicar cómo Kubernetes facilita el Blue-Green Deployment o el Canary Release para lanzar nuevas versiones de un modelo de ML sin downtime.
Sigue con Containerización y Despliegue de Modelos ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.