

Lección 19 de 20 · Lectura y práctica
Práctica: Implementar Monitorización y Logs con Prometheus
Tipo de lección: VideoConcepto claveLa monitorización en producción es como tener un panel de control en un avión. No solo necesitas saber si el motor funciona, sino también cuánto combustible queda, la temperatura y si hay.
Del concepto a la práctica
Taller de esta lección
Una métrica útil responde a una pregunta operativa concreta. Para este servicio, peticiones_totales mide volumen y errores_totales mide fallos; ambas son contadores, mientras que la latencia debe observarse por distribución, no mediante un único máximo aislado. Las etiquetas deben tener pocos valores posibles.
Ejemplo resuelto
Durante cinco minutos se registran 50 peticiones: 47 respuestas correctas y 3 errores. La tasa de error es 3 / 50 × 100 = 6%. Un formato de métricas podría ser:
peticiones_totales{resultado="ok"} 47
peticiones_totales{resultado="error"} 3
errores_totales 3
Un log estructurado asociado puede incluir {"ruta":"/recommend","estado":500,"duracion_ms":210} sin guardar el identificador personal del usuario.
Pruébalo
Define dos contadores y una medición de duración para tu endpoint.
Ejecuta 20 solicitudes locales: 18 correctas y 2 fallidas.
Expón los valores en formato legible por Prometheus.
Calcula la tasa con
errores / total × 100y revisa que las etiquetas no sean IDs únicos.
Error frecuente: etiquetar cada métrica con user_id. Corrígelo usando categorías limitadas, como resultado, y deja los detalles de diagnóstico en logs controlados.
Comprueba tu resultado
Tu cálculo debe producir 2 / 20 × 100 = 10%. Entrega los dos contadores, la fórmula y un log de error sin datos personales. El resultado es verificable si la suma de éxitos y errores coincide con 20.
Scrape explícito y ventanas de contadores
Prometheus necesita una configuración que descubra y seleccione los targets; anotar un Pod no modifica automáticamente un Prometheus instalado sin esa configuración. Para una primera prueba de una sola réplica, añade en prometheus.yml:
scrape_configs:
  - job_name: cursalo-recomendador
    metrics_path: /metrics
    static_configs:
      - targets: ["recomendador:8080"]
Ese nombre y puerto deben ser un Service real en el mismo namespace, que llegue a la aplicación. Monta la configuración y configura Prometheus para leerla; /metrics debe existir. Un Service que balancea varias réplicas no sustituye el scrape individual de cada Pod: para varias réplicas configura descubrimiento Kubernetes/EndpointSlices o un operador con selección explícita.
Los contadores son acumulativos y pueden reiniciarse. Para los ejemplos usa diferencias dentro de la misma ventana: Δerrores3/Δtotal50=6% y Δerrores2/Δtotal20=10%; en PromQL usa tasas/incrementos apropiados y maneja denominador cero. Cuenta una solicitud una vez; no sumes de nuevo un contador de errores ya incluido en total. La latencia medida no representa la precisión del modelo. Configuración Prometheus.
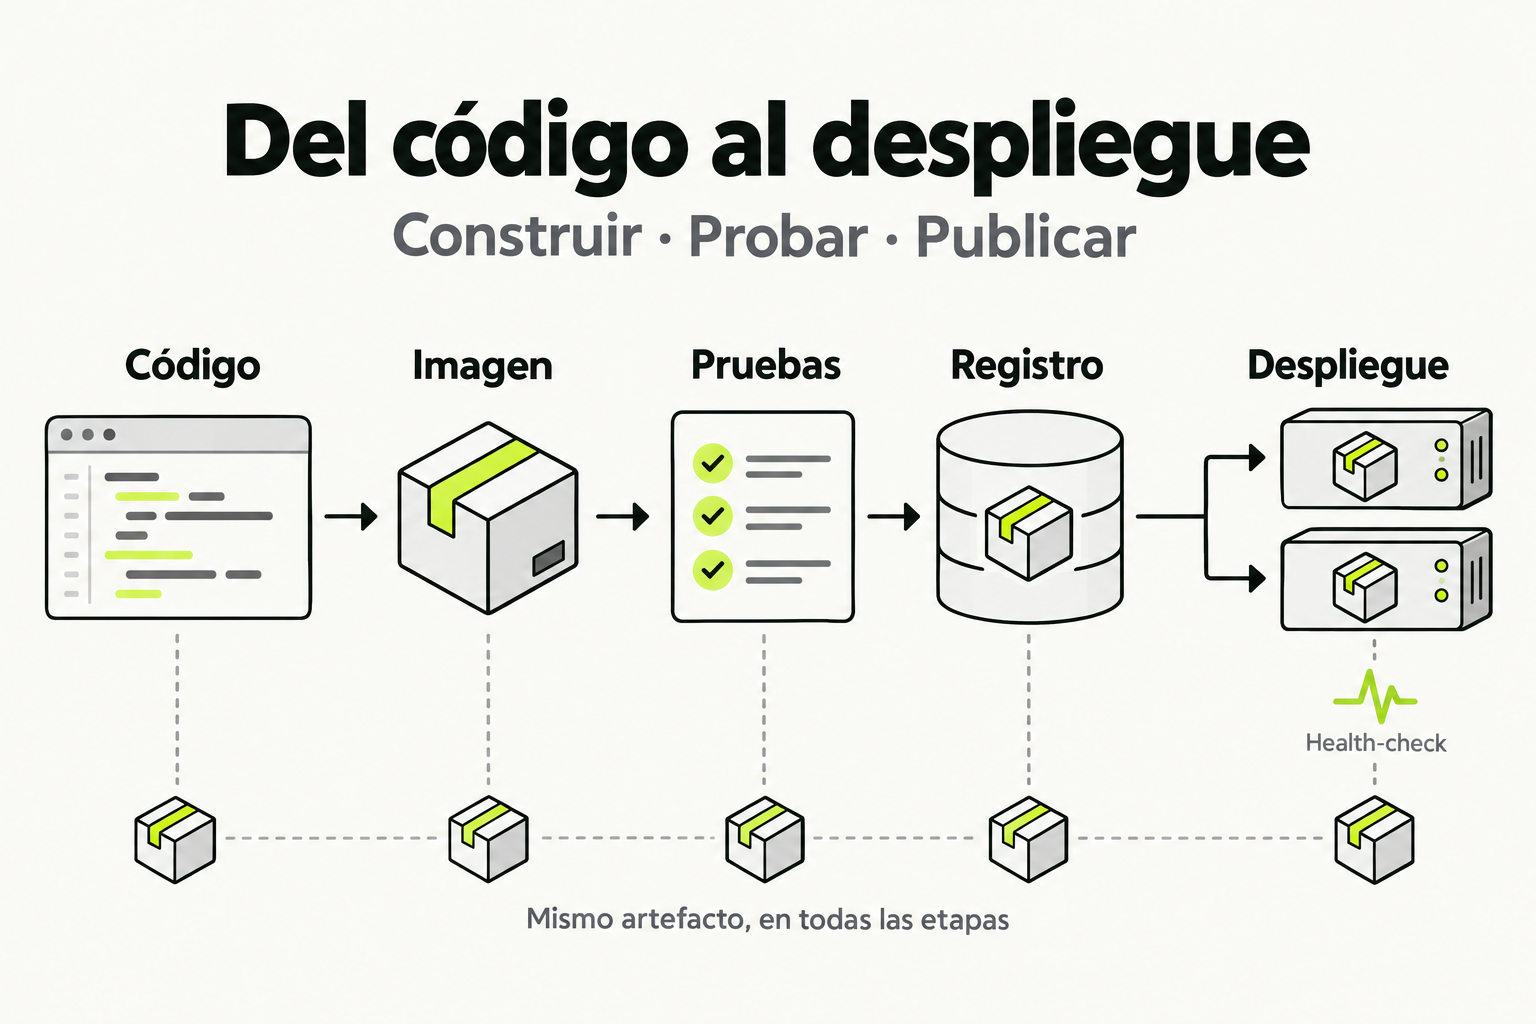
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
La monitorización en producción es como tener un panel de control en un avión. No solo necesitas saber si el motor funciona, sino también cuánto combustible queda, la temperatura y si hay turbulencias. En sistemas de ML, Prometheus es ese panel de control: recolecta métricas de tus contenedores y servicios, almacenándolas como series de tiempo.
Imagina tu sistema de recomendación como una cadena de producción. Cada contenedor es una estación de trabajo. Sin logs y métricas, es como operar con los ojos vendados: no sabes si una recomendación tarda demasiado, si hay errores en el procesamiento o si el uso de memoria se dispara. Los logs registran eventos específicos ("el usuario X hizo clic en Y"), mientras que las métricas miden tendencias ("latencia promedio: 150ms").
Cómo funciona en la práctica
Vamos a implementar monitorización en un sistema de recomendación desplegado en Kubernetes. Primero, desplegamos Prometheus como un Pod en nuestro cluster. Luego, configuramos nuestros contenedores de ML para exponer métricas en un endpoint HTTP (por ejemplo, /metrics). Prometheus "raspa" estos endpoints periódicamente, recolectando datos.
Paso a paso: 1) Instalar Prometheus usando Helm o un manifiesto YAML. 2) Anotar nuestros Pods de ML con etiquetas que Prometheus detecte automáticamente. 3) Configurar nuestras aplicaciones Python para usar la biblioteca prometheus-client y exponer métricas personalizadas, como "recommendations_processed_total". 4) Verificar en la interfaz web de Prometheus que las métricas aparecen.
Codigo en accion
Antes: Un servicio de recomendación sin monitorización.
from flask import Flask, jsonify
import numpy as np

app = Flask(__name__)

@app.route('/recommend', methods=['POST'])
def recommend():
    # Lógica de recomendación
    recommendations = ["item1", "item2", "item3"]
    return jsonify(recommendations)

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
Después: El mismo servicio con métricas expuestas.
from flask import Flask, jsonify, request
import numpy as np
from prometheus_client import Counter, Histogram, generate_latest, CONTENT_TYPE_LATEST

app = Flask(__name__)

# Definir métricas
RECOMMENDATIONS_TOTAL = Counter('recommendations_processed_total', 'Total de recomendaciones generadas')
REQUEST_LATENCY = Histogram('request_latency_seconds', 'Latencia de las peticiones de recomendación')

@app.route('/metrics')
def metrics():
    return generate_latest(), 200, {'Content-Type': CONTENT_TYPE_LATEST}

@app.route('/recommend', methods=['POST'])
@REQUEST_LATENCY.time()
def recommend():
    RECOMMENDATIONS_TOTAL.inc()
    # Lógica de recomendación
    recommendations = ["item1", "item2", "item3"]
    return jsonify(recommendations)

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
Errores comunes
- No exponer el endpoint /metrics: Prometheus no puede raspar métricas si la aplicación no tiene esta ruta. Solución: Asegúrate de incluirla y que devuelva datos en el formato correcto.
- Etiquetas incorrectas en los Pods: Si las anotaciones en los Pods no coinciden con la configuración de Prometheus, no se descubrirán automáticamente. Solución: Usa anotaciones estándar como
prometheus.io/scrape: "true". - Métricas con alta cardinalidad: Crear métricas con muchas etiquetas únicas (como IDs de usuario) puede saturar Prometheus. Solución: Usa etiquetas con valores limitados, como "user_type" en lugar de "user_id".
- Olvidar los logs estructurados: Los logs en texto plano son difíciles de analizar. Solución: Usa formato JSON en los logs y envíalos a un sistema como Elasticsearch.
Checklist de dominio
- ¿Puedes desplegar Prometheus en un cluster Kubernetes usando un manifiesto YAML?
- ¿Sabes configurar una aplicación Python para exponer métricas con prometheus-client?
- ¿Entiendes la diferencia entre métricas (Prometheus) y logs (Fluentd/Elasticsearch)?
- ¿Puedes crear un dashboard básico en Grafana usando métricas de Prometheus?
- ¿Sabes anotar Pods para descubrimiento automático de métricas?
- ¿Puedes identificar métricas clave para un sistema de recomendación (ej., latencia, tasa de acierto)?
- ¿Conoces cómo alertar en Prometheus cuando una métrica supera un umbral?
Monitorizar un servicio de recomendación en Kubernetes con Prometheus
En este ejercicio, implementarás monitorización en un servicio de recomendación existente desplegado en Kubernetes.
- Prepara tu entorno: Asegúrate de tener un cluster Kubernetes funcionando (puede ser Minikube o un cloud). Clona el repositorio del proyecto que contiene el servicio de recomendación básico.
- Despliega Prometheus: Usa el siguiente manifiesto YAML para desplegar Prometheus en tu cluster. Crea un archivo
prometheus-deployment.yamly aplica conkubectl apply -f prometheus-deployment.yaml.apiVersion: apps/v1 kind: Deployment metadata: name: prometheus spec: replicas: 1 selector: matchLabels: app: prometheus template: metadata: labels: app: prometheus spec: containers: - name: prometheus image: prom/prometheus:latest ports: - containerPort: 9090 - Modifica el servicio de recomendación: Edita el código Python del servicio para incluir el endpoint
/metricsy métricas personalizadas, como se muestra en la sección "Código en acción". Reconstruye la imagen Docker y actualiza el despliegue en Kubernetes. - Configura el descubrimiento de servicios: Anota el Pod del servicio de recomendación con
prometheus.io/scrape: "true"yprometheus.io/port: "5000"en el manifiesto de despliegue. Vuelve a aplicar los cambios. - Verifica la monitorización: Accede a la interfaz web de Prometheus (usa
kubectl port-forwardsi es necesario) y busca la métricarecommendations_processed_total. Genera tráfico a tu servicio y confirma que la métrica aumenta.
Pistas
- Usa kubectl get pods para verificar que Prometheus y tu servicio están corriendo.
- Si no ves métricas en Prometheus, revisa las anotaciones del Pod y que el endpoint /metrics devuelva datos.
- Para reconstruir la imagen Docker, usa docker build -t tu-imagen:tag . y actualiza la referencia en el YAML de Kubernetes.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.