

Lección 3 de 20 · Lectura y práctica
Crear un Dockerfile para un Modelo de Scikit-learn
Tipo de lección: VideoConcepto claveUn Dockerfile es un archivo de texto que contiene instrucciones para construir una imagen de Docker. Piensa en ello como una receta que especifica todos los ingredientes y pasos necesarios para.
Del concepto a la práctica
Taller de esta lección
Un Dockerfile para inferencia debe ordenar sus responsabilidades: elegir una base compatible, instalar dependencias fijadas, copiar solo lo necesario y arrancar un proceso que cargue el modelo una vez. El orden también afecta a la caché y a la revisión del contenido de la imagen.
Ejemplo resuelto
Con un lockfile de dependencias compatible generado junto al artefacto, un app.py puede cargar modelo.joblib al iniciar y calcular modelo.predict([[2.0, 5.0]]). La salida puede ser prediccion=1. El Dockerfile copia primero requisitos, instala y después copia código y artefacto.
Pruébalo
Crea un modelo pequeño con dos características.
Guarda el modelo y escribe una inferencia fija.
Construye la imagen usando un
.dockerignoreque excluya.gity__pycache__.Ejecuta una entrada conocida y guarda stdout.
Error frecuente: entrenar cada vez que arranca la API. Corrección: separa entrenamiento de inferencia y carga un artefacto preparado.
Comprueba tu resultado
La construcción debe terminar sin archivos excluidos, el proceso debe cargar una sola vez y la entrada [[2.0,5.0]] debe producir la misma etiqueta en dos ejecuciones.
Modelo de práctica con entradas completas
Usa el mismo entorno de Python y scikit-learn para entrenar y servir. En train.py:
from sklearn.tree import DecisionTreeClassifier
import joblib

X = [[0.0,0.0],[1.0,1.0],[2.0,5.0]]
y = [0,0,1]
modelo = DecisionTreeClassifier(random_state=42).fit(X,y)
joblib.dump(modelo,"modelo.joblib")
En app.py para esta prueba de consola:
import joblib
modelo = joblib.load("modelo.joblib")
assert modelo.predict([[2.0,5.0]]).tolist() == [1]
assert modelo.predict([[0.0,0.0]]).tolist() == [0]
print("prediccion=1")
Solo carga el artefacto que tú generaste y verificaste; joblib/pickle puede ejecutar código al deserializar y no garantiza compatibilidad entre versiones. Instala la versión elegida en un entorno aislado, registra sus dependencias resueltas en requirements.lock y usa ese mismo lock para la imagen. La documentación actual consultada corresponde a scikit-learn 1.9.1; los pins antiguos no son una garantía automática para una base moderna. Este ejemplo verifica dos puntos conocidos, no una métrica general del modelo. Persistencia de modelos.
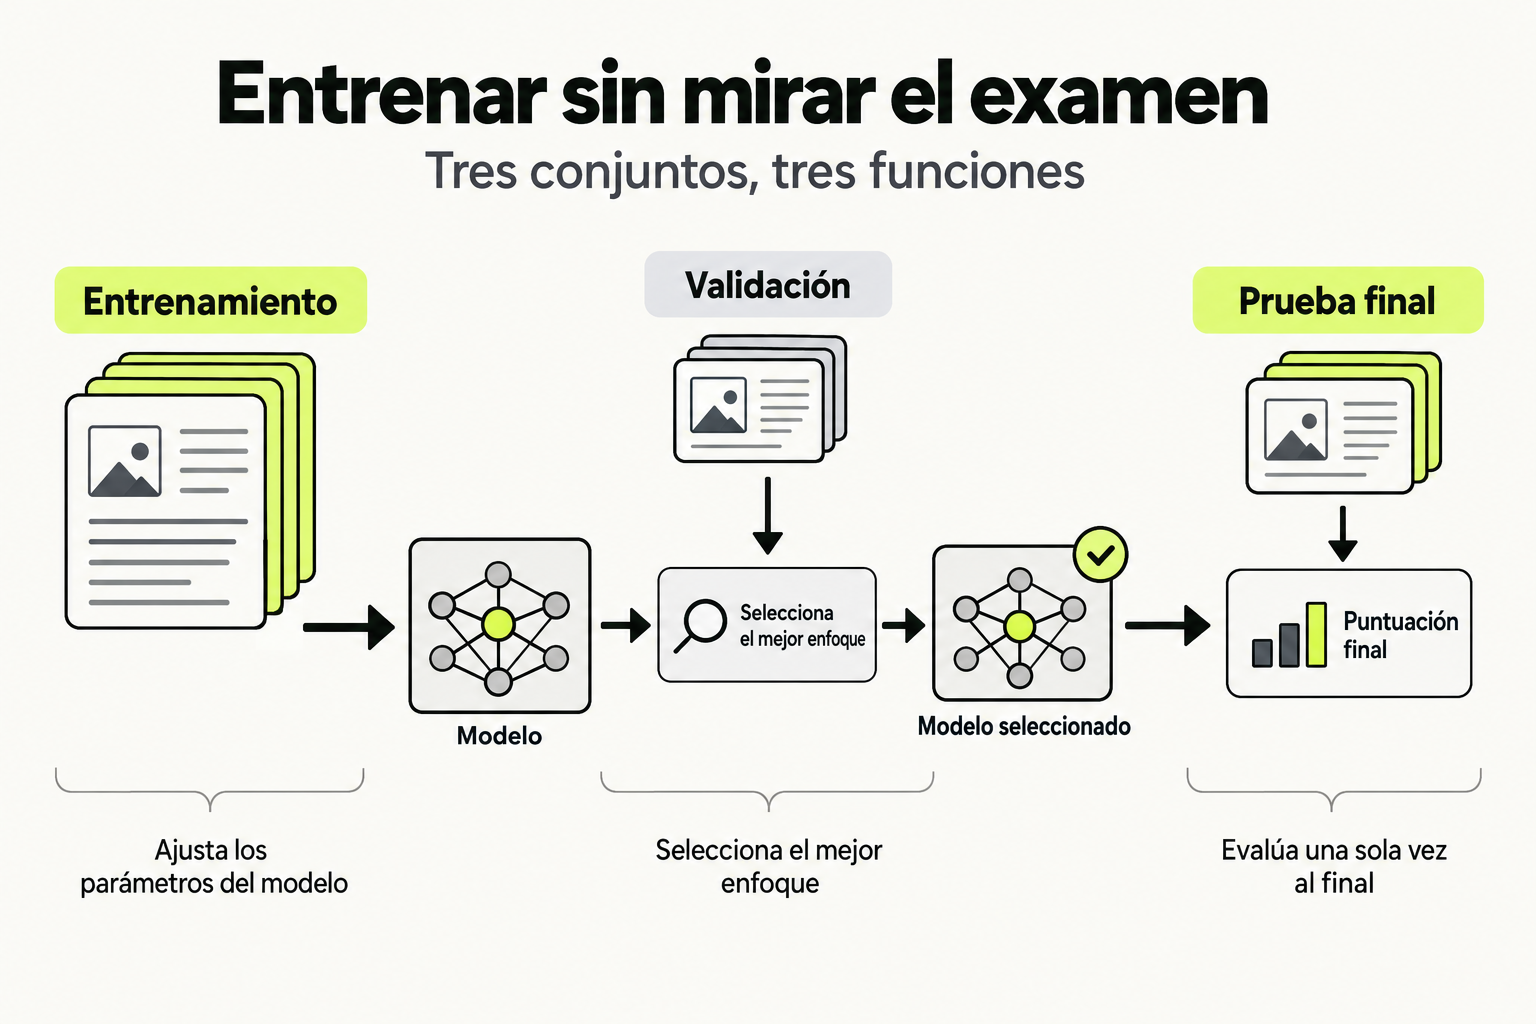
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
Un Dockerfile es un archivo de texto que contiene instrucciones para construir una imagen de Docker. Piensa en ello como una receta que especifica todos los ingredientes y pasos necesarios para crear un contenedor reproducible. Para científicos de datos, esto significa encapsular tu modelo de Scikit-learn, sus dependencias y el entorno de ejecución en un paquete autónomo.
La analogía del mundo real sería preparar una caja de herramientas completa para un trabajo específico. En lugar de llevar herramientas sueltas (tu código, bibliotecas, configuraciones), metes todo en una caja organizada (el contenedor) que puedes llevar a cualquier sitio y usar inmediatamente. Esto elimina el clásico problema de "funciona en mi máquina" y permite despliegues consistentes en Kubernetes.
Cómo funciona en la práctica
Vamos a crear un Dockerfile para un modelo de clasificación con Scikit-learn paso a paso. Primero, necesitas un proyecto estructurado. Supongamos que tienes estos archivos:
- train_model.py: Script para entrenar el modelo
- predict.py: Script para hacer predicciones
- requirements.txt: Dependencias de Python
- model.pkl: Modelo entrenado (generado por train_model.py)
El Dockerfile definirá cómo construir una imagen que incluya Python, instale las dependencias, copie tus archivos y configure el punto de entrada. La construcción se hace con docker build y la ejecución con docker run. Esto crea un contenedor aislado que puede ejecutar tu modelo en cualquier sistema con Docker instalado.
Codigo en accion
Aquí tienes un Dockerfile básico para un modelo Scikit-learn:
# Usa una imagen base oficial de Python
FROM python:3.9-slim

# Establece el directorio de trabajo en el contenedor
WORKDIR /app

# Copia el archivo de dependencias
COPY requirements.txt .

# Instala las dependencias
RUN pip install --no-cache-dir -r requirements.txt

# Copia el resto de los archivos del proyecto
COPY . .

# Expone el puerto si tu aplicación usa un servidor web (opcional)
EXPOSE 5000

# Define el comando por defecto para ejecutar el script de predicción
CMD ["python", "predict.py"]
Y este es el contenido típico de requirements.txt:
scikit-learn==1.3.0
pandas==2.0.3
flask==2.3.2
numpy==1.24.3
Para construir la imagen, ejecutas:
docker build -t sklearn-model .Y para ejecutar el contenedor:
docker run -p 5000:5000 sklearn-modelErrores comunes
- No optimizar el tamaño de la imagen: Usar imágenes base grandes como
python:3.9en lugar depython:3.9-slimpuede resultar en imágenes de varios GB. Solución: Usa variantes slim o alpine y limpia la caché de pip con--no-cache-dir. - Copiar todos los archivos innecesariamente: Incluir datos de entrenamiento grandes o archivos temporales en la imagen. Solución: Usa un
.dockerignorepara excluir archivos como datasets crudos, logs o entornos virtuales. - No fijar versiones de dependencias: Usar
scikit-learnsin versión puede causar incompatibilidades al actualizar. Solución: Especifica versiones exactas en requirements.txt. - Ejecutar como root por defecto: Aumenta el riesgo de seguridad. Solución: Añade un usuario no privilegiado en el Dockerfile con
RUN useradd -m appuser && chown -R appuser /appyUSER appuser. - No manejar señales de terminación: Los contenedores pueden no apagarse correctamente en Kubernetes. Solución: Asegúrate de que tu script Python capture señales como SIGTERM para limpieza.
Checklist de dominio
- Puedo escribir un Dockerfile que instale Scikit-learn y sus dependencias desde requirements.txt
- Sé cómo reducir el tamaño de la imagen usando capas eficientes y .dockerignore
- Entiendo la diferencia entre COPY, ADD, RUN y CMD en un Dockerfile
- Puedo construir una imagen y ejecutar un contenedor que sirva predicciones de un modelo
- Sé cómo exponer puertos y mapearlos correctamente al ejecutar el contenedor
- Reconozco la importancia de la seguridad al definir usuarios no root en el contenedor
- Puedo debuggear problemas comunes como fallos de dependencias o permisos
Containerizar un modelo de regresión lineal con Flask API
En este ejercicio, crearás un Dockerfile para un modelo de regresión lineal de Scikit-learn que exponga una API REST con Flask. Sigue estos pasos:
- Crea un directorio de proyecto con los siguientes archivos:
train.py: Entrena un modelo simple de regresión lineal con datos sintéticos y guarda el modelo comomodel.pklapp.py: Crea un servidor Flask con un endpoint/predictque acepte datos JSON y devuelva prediccionesrequirements.txt: Lista las dependencias (scikit-learn, flask, pandas, numpy).dockerignore: Excluye archivos innecesarios
- Escribe un Dockerfile que:
- Use una imagen base Python slim
- Instale las dependencias desde requirements.txt
- Copie los archivos del proyecto
- Exponga el puerto 5000
- Ejecute app.py al iniciar el contenedor
- Construye la imagen con
docker build -t linear-regression-api . - Ejecuta el contenedor con
docker run -p 5000:5000 linear-regression-api - Prueba la API enviando una solicitud POST a
http://localhost:5000/predictcon datos JSON de ejemplo
Entrega: Tu Dockerfile completo y el comando de ejecución que usaste.
Pistas
- Usa datos sintéticos en train.py con make_regression de sklearn.datasets para simplificar
- En app.py, asegúrate de cargar el modelo una vez al inicio para eficiencia
- Incluye en .dockerignore archivos como __pycache__, .git, y datasets grandes
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.