

Lección 25 de 25 · Lectura y práctica
Quiz Final: Evaluación Integral del Proyecto
Tipo de lección: QuizConcepto claveEl Retrieval Augmented Generation (RAG) es una arquitectura que combina sistemas de recuperación de información con modelos generativos de lenguaje. En esencia, funciona como un asistente de.
Del concepto a la práctica
Taller de esta lección
La evaluación final debe comprobar el sistema completo: ingesta reproducible, búsqueda compatible, filtros correctos, respuesta sustentada y operación observable. Un resultado convincente necesita evidencias separadas para calidad y rendimiento; una sola respuesta acertada no valida la arquitectura.
Ejemplo resuelto
Un caso de prueba exige el fragmento manual-2-sec-4. La recuperación devuelve [manual-1-sec-2, manual-2-sec-4, manual-3-sec-1]; el fragmento esperado está en rango 2. La respuesta final cita únicamente ese contexto. Si la latencia total es 180 ms y el límite acordado es 250 ms, el caso cumple rendimiento, aunque su rango recíproco sea 1/2 = 0,5.
Pruébalo
Verifica dimensión y modelo constante entre ingesta y consulta.
Comprueba identidad, versión y filtro de cada fragmento.
Calcula recall, MRR y latencia con tres casos.
Marca cada criterio como cumplido o pendiente.
Comprueba tu resultado
El caso resuelto tiene recall 100% si el relevante aparece entre los tres, RR 0,5 y latencia conforme.
Error frecuente: declarar éxito porque la respuesta suena correcta. Corrígelo exigiendo correspondencia con el fragmento esperado, métricas registradas y una ruta de recuperación reproducible.
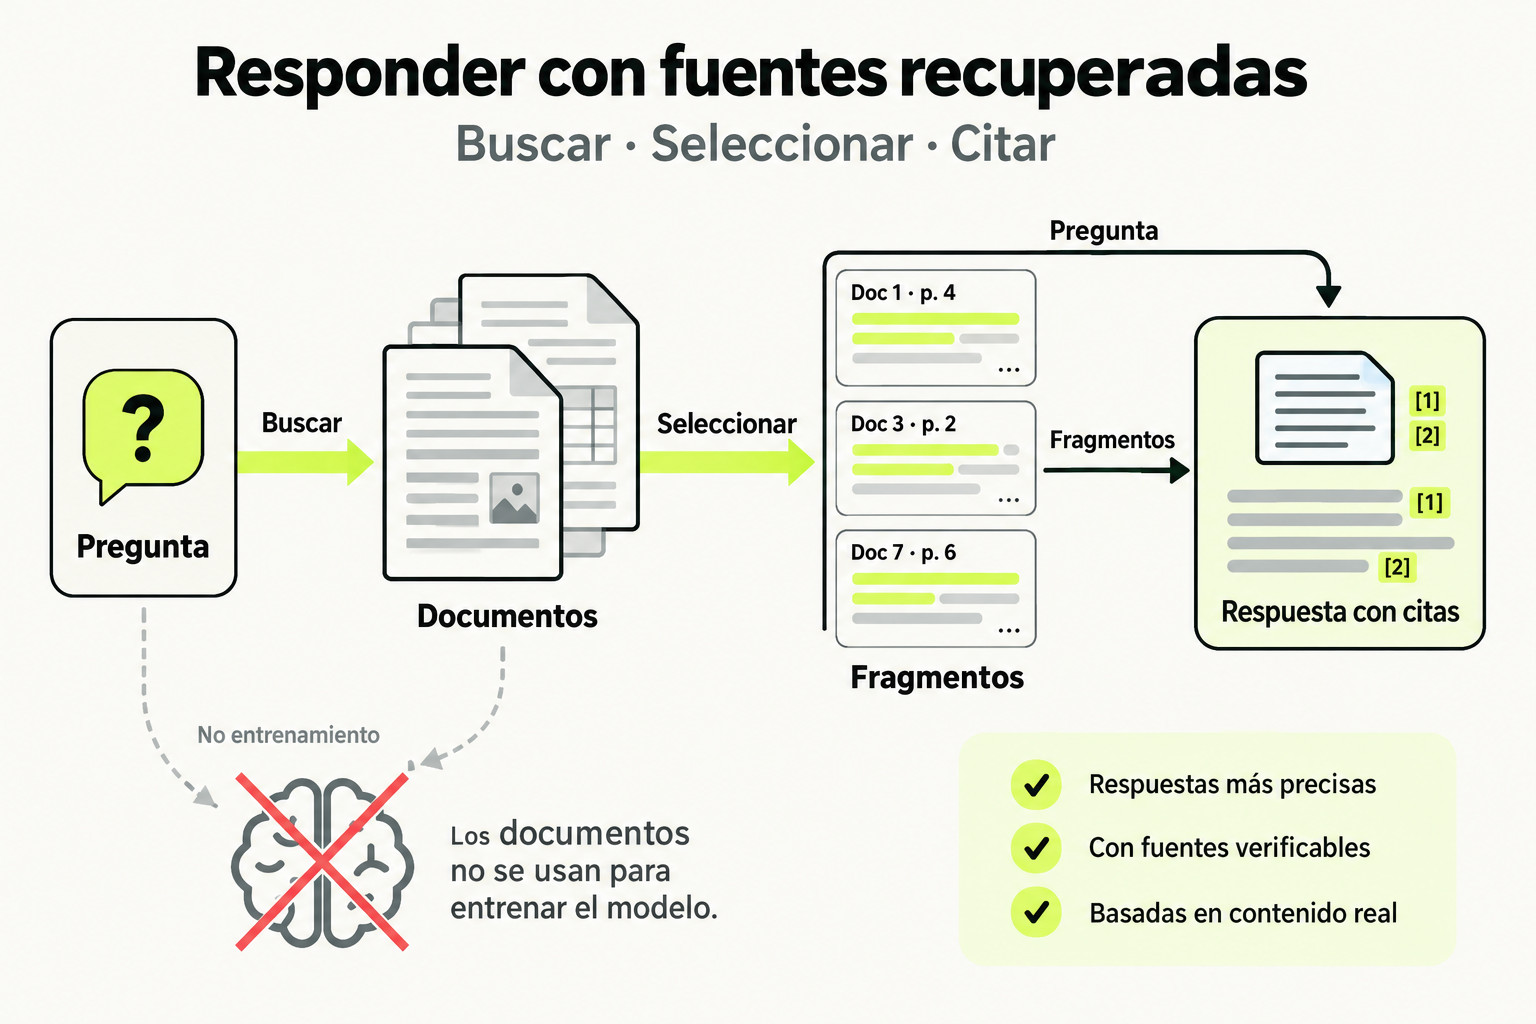
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Quiz
Concepto clave
El Retrieval Augmented Generation (RAG) es una arquitectura que combina sistemas de recuperación de información con modelos generativos de lenguaje. En esencia, funciona como un asistente de investigación que primero busca documentos relevantes en una base de datos y luego usa esa información para generar respuestas precisas y contextualizadas.
Imagina que eres un abogado preparando un caso. Primero buscas en tu biblioteca de leyes y precedentes (la base de datos vectorial) los documentos más relevantes. Luego, usando esos documentos como referencia, redactas un argumento legal bien fundamentado (la generación aumentada). La clave está en que la respuesta no viene solo de la memoria del modelo, sino de información verificable recuperada en tiempo real.
Cómo funciona en la práctica
Un sistema RAG completo sigue estos pasos:
- Indexación: Los documentos se dividen en fragmentos (chunks) y se convierten en vectores numéricos usando un modelo de embeddings.
- Almacenamiento: Estos vectores se guardan en una base de datos vectorial como Chroma, Pinecone o pgvector.
- Consulta: Cuando un usuario hace una pregunta, se convierte en un vector y se busca en la base de datos los fragmentos más similares.
- Contexto aumentado: Los fragmentos recuperados se combinan con la pregunta original para formar el contexto del prompt.
- Generación: Un modelo de lenguaje (como GPT) genera la respuesta final basándose en ese contexto aumentado.
Ejemplo con datos: Si consultas "¿Cuáles son los requisitos para visas de trabajo en Canadá?", el sistema buscará en la base de datos fragmentos sobre leyes de inmigración canadiense y generará una respuesta específica usando esa información actualizada.
Caso de estudio
Sistema de soporte técnico para una empresa de software
Una empresa con 50,000 documentos de manuales, FAQs y tickets resueltos implementa un RAG con pgvector en PostgreSQL. Los datos técnicos se indexan en vectores de 768 dimensiones. Cuando un ingeniero pregunta "¿Cómo solucionar el error 'connection timeout' en el módulo X?", el sistema:
- Recupera los 3 fragmentos más relevantes de la base de datos (incluyendo soluciones documentadas).
- Combina estos con la pregunta en un prompt estructurado.
- Genera una respuesta paso a paso con comandos específicos y referencias a la documentación.
Resultado medible: Reducción del 40% en tickets de soporte y respuestas un 85% más precisas que un chatbot basado solo en el modelo base.
Errores comunes
- Chunks mal dimensionados: Fragmentos demasiado grandes pierden precisión, demasiado pequeños pierden contexto. Solución: Experimentar con tamaños entre 200-500 tokens y usar overlap estratégico.
- Embeddings inapropiados: Usar un modelo de embeddings genérico para dominios técnicos especializados. Solución: Fine-tune o elegir modelos específicos para el dominio (ej: modelos legales para documentos jurídicos).
- Falta de filtrado de contexto: Incluir fragmentos irrelevantes en el prompt contamina la generación. Solución: Implementar umbrales de similitud y filtros por metadatos.
- Ignorar la latencia en producción: No considerar los tiempos de respuesta al elegir la base de datos vectorial. Solución: Evaluar Chroma para prototipos rápidos, Pinecone para escalabilidad cloud, pgvector para integración con datos existentes.
Checklist de dominio
- Puedo explicar la diferencia entre RAG y fine-tuning tradicional
- He implementado pipelines de indexación para al menos 10,000 documentos
- Sé configurar parámetros de búsqueda semántica (top_k, score thresholds)
- Puedo comparar ventajas/desventajas de Chroma vs Pinecone vs pgvector
- He evaluado un sistema RAG con métricas como precisión@k y relevancia humana
- Sé estructurar prompts efectivos que integren contexto recuperado
- Puedo desplegar un sistema RAG en un entorno de producción básico
Implementación y evaluación de un sistema RAG con métricas de calidad
En este ejercicio, implementarás un sistema RAG completo usando una base de datos vectorial de tu elección y evaluarás su rendimiento con métricas cuantitativas.
- Prepara los datos: Usa el dataset "tecnical_docs.csv" (disponible en los materiales del curso) que contiene 1,000 documentos técnicos sobre desarrollo de software. Divide los documentos en chunks de 300 tokens con overlap de 50 tokens.
- Configura la base de datos vectorial: Elige entre Chroma (local), Pinecone (cloud) o pgvector (PostgreSQL). Crea la colección/índice con dimensiones apropiadas para el modelo de embeddings 'all-MiniLM-L6-v2'.
- Indexa los datos: Genera embeddings para todos los chunks y almacénalos en tu base de datos vectorial junto con metadatos (doc_id, chunk_index, source).
- Implementa el sistema de recuperación: Crea una función que tome una consulta, la convierta a embedding, y recupere los 5 chunks más relevantes usando búsqueda semántica.
- Construye el pipeline de generación: Integra con un modelo de lenguaje (puedes usar la API de OpenAI o un modelo local como Llama 2) para generar respuestas basadas en el contexto recuperado.
- Evalúa el sistema: Usa el conjunto de evaluación "test_questions.json" con 50 preguntas y respuestas de referencia. Calcula:
- Precisión@3: ¿La respuesta correcta está entre los top 3 chunks recuperados?
- Relevancia generada: Puntúa del 1-5 si la respuesta generada responde completamente a la pregunta
- Latencia promedio: Tiempo desde consulta hasta respuesta
- Documenta los resultados: Crea un reporte breve con tablas HTML mostrando tus métricas y análisis de 3 casos específicos (uno bueno, uno regular, uno malo).
Pistas
- Considera usar SentenceTransformer para los embeddings si trabajas localmente
- Para la evaluación, implementa una función que compare la respuesta generada con la de referencia usando similitud de coseno entre embeddings
- Si usas pgvector, recuerda crear el índice HNSW para búsquedas eficientes
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.