

Lección 5 de 25 · Lectura y práctica
Quiz: Evaluación de Conceptos Fundamentales
Tipo de lección: QuizConcepto claveEl Retrieval Augmented Generation (RAG) es una arquitectura que combina recuperación de información con generación de texto. En lugar de depender únicamente de los parámetros aprendidos durante.
Del concepto a la práctica
Taller de esta lección
Este repaso distingue errores de etapa. Indexar significa preparar y guardar documentos; recuperar significa buscar candidatos para una pregunta; generar significa redactar usando el contexto disponible. Si una respuesta cita un fragmento inexistente, el problema no se resuelve aumentando k: primero hay que revisar la trazabilidad.
Ejemplo resuelto
Clasifica estas situaciones: cargar diez fragmentos es indexación; devolver dos IDs para una consulta es recuperación; convertir esos dos textos en una respuesta es generación. Un conjunto de evaluación puede tener tres preguntas y una respuesta esperada por cada una.
Pruébalo
Escribe cuatro afirmaciones sobre un flujo RAG.
Etiqueta cada una como ingesta, indexación, recuperación o generación.
Marca cuál necesita datos externos.
Justifica una clasificación con un ID de documento. Error frecuente: llamar «precisión» a que el texto suene convincente. Corrígelo comparando la respuesta con fragmentos realmente recuperados.
Comprueba tu resultado
Entrega cuatro afirmaciones clasificadas y tres preguntas evaluadas. El resultado esperado es una tabla sin categorías ambiguas y con al menos un ID de fuente por respuesta considerada correcta.
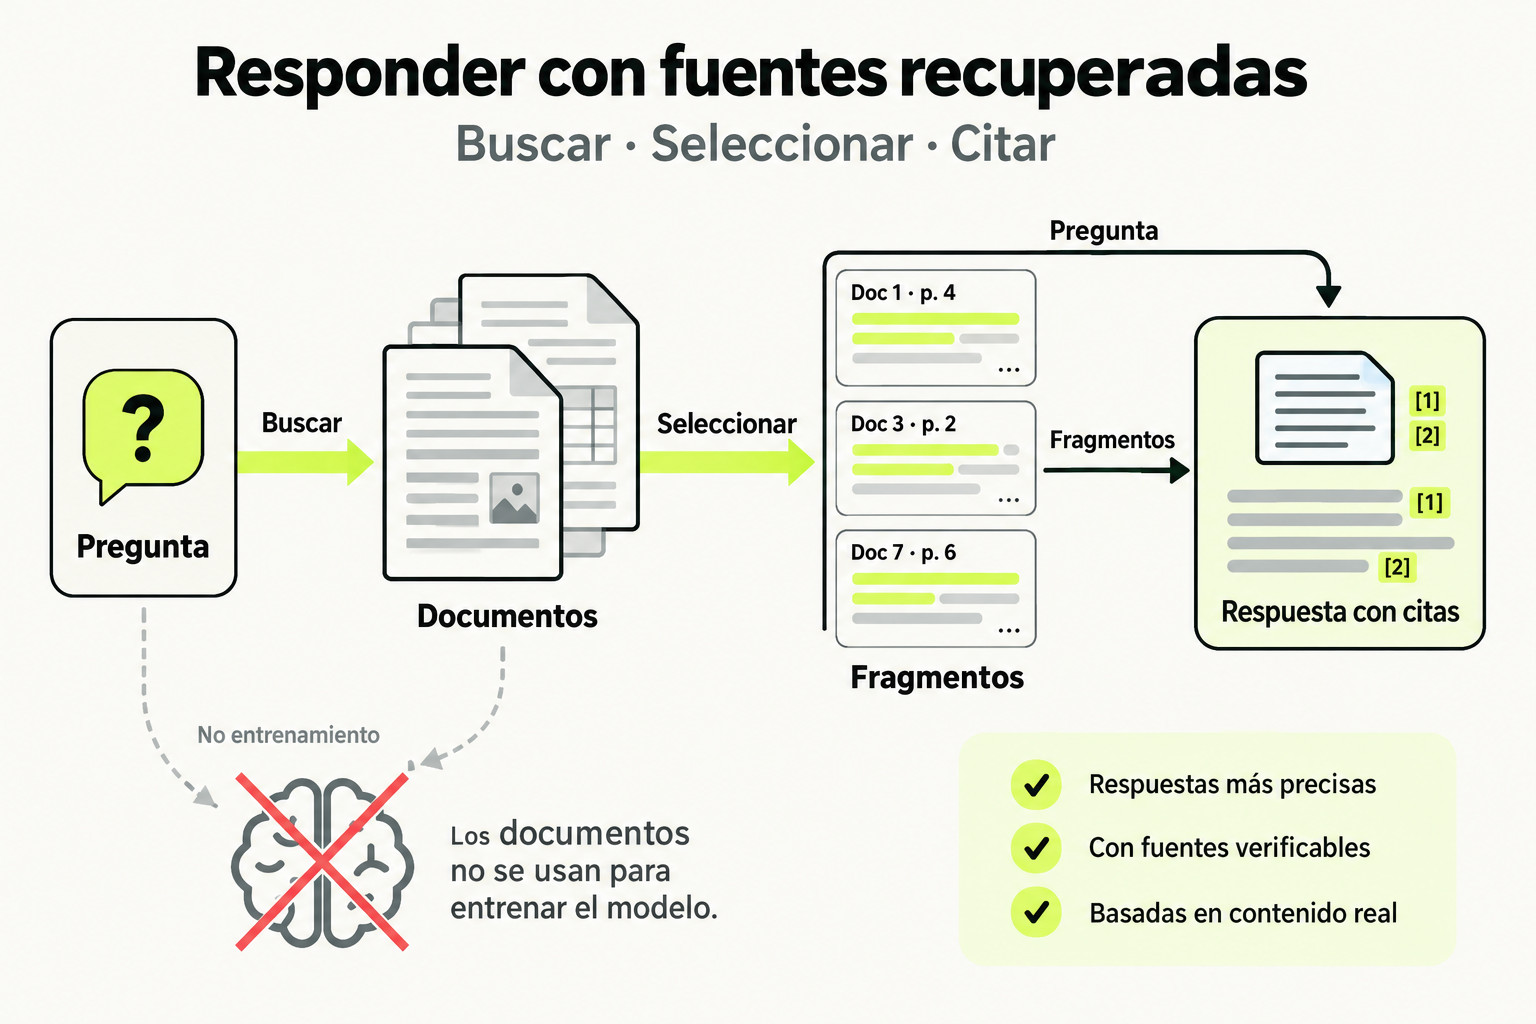
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Quiz
Concepto clave
El Retrieval Augmented Generation (RAG) es una arquitectura que combina recuperación de información con generación de texto. En lugar de depender únicamente de los parámetros aprendidos durante el entrenamiento (como hace un LLM tradicional), un sistema RAG primero recupera documentos relevantes de una base de conocimiento externa y luego usa esa información como contexto para generar respuestas.
Imagina que eres un abogado preparando un caso. No intentas memorizar todos los códigos legales (como haría un LLM puro). En su lugar, primero buscas en tu biblioteca de leyes (la base de datos vectorial) los estatutos relevantes, luego usas esos documentos específicos para redactar tu argumento (la generación). Esto produce respuestas más precisas, actualizables y con menor "alucinación".
Cómo funciona en la práctica
Un flujo típico de RAG con bases de datos vectoriales tiene estos pasos:
- Indexación: Los documentos fuente (PDFs, páginas web, etc.) se dividen en fragmentos (chunks). Cada fragmento se convierte en un vector de embedding usando un modelo como sentence-transformers.
- Almacenamiento: Estos vectores, junto con el texto original y metadatos, se insertan en una base de datos vectorial como Chroma, Pinecone o pgvector.
- Consulta: Cuando un usuario hace una pregunta, esta se convierte en un vector de consulta usando el mismo modelo de embedding.
- Recuperación: La base de datos vectorial encuentra los fragmentos más similares (usando similitud coseno o distancia euclidiana) y los devuelve.
- Aumentación y generación: Los fragmentos recuperados se inyectan como contexto en un prompt para un LLM (como GPT-4 o Llama), que genera la respuesta final.
Caso de estudio
Una empresa de seguros quiere un chatbot que responda preguntas sobre pólizas usando su manual interno de 500 páginas. Implementan un sistema RAG:
- Usan Chroma para prototipar rápidamente, almacenando embeddings de fragmentos de 200 tokens.
- Para producción, migran a pgvector en su PostgreSQL existente, aprovechando ACID y consultas SQL.
- La consulta "¿Cubre mi póliza daños por inundación en el primer piso?" se convierte en vector, recupera 3 fragmentos relevantes del manual, y el LLM genera: "Sí, la cobertura básica incluye inundaciones en plantas bajas, según sección 4.2, con un deducible del 5%".
Un sistema RAG bien implementado puede reducir errores factuales en un 40-60% comparado con un LLM sin contexto, según estudios recientes.
Errores comunes
- Chunking inapropiado: Fragmentos demasiado grandes pierden precisión; demasiado pequeños pierden contexto. Solución: Experimentar con tamaños (ej. 256-512 tokens) y solapamiento (overlap).
- Embeddings inconsistentes: Usar diferentes modelos para indexar y consultar. Solución: Siempre usar el mismo modelo y versión.
- Falta de filtrado por metadatos: Recuperar fragmentos irrelevantes porque no se filtran por fecha, departamento, etc. Solución: Usar metadatos en la consulta vectorial.
- Prompt engineering débil: No instruir al LLM para que use solo el contexto proporcionado. Solución: Incluir en el prompt: "Responde basándote únicamente en los siguientes documentos...".
Checklist de dominio
- Puedo explicar la diferencia entre RAG y fine-tuning de un LLM.
- Sé cómo elegir entre Chroma (simplicidad), Pinecone (escalabilidad cloud) y pgvector (integración SQL).
- Puedo diseñar un esquema de chunking y embeddings para un conjunto de documentos.
- Entiendo cómo la similitud coseno afecta la recuperación de fragmentos.
- Sé depurar un sistema RAG cuando devuelve respuestas incorrectas.
- Puedo optimizar costos balanceando calidad de embeddings vs. latencia.
- Conozco las limitaciones de RAG (ej., no maneja razonamiento complejo entre fragmentos).
Diseño de un sistema RAG para documentación técnica
Vas a diseñar la arquitectura de un sistema RAG para la documentación de una API de 300 páginas. Sigue estos pasos:
- Define el chunking: Decide el tamaño de fragmento (en tokens) y si usarás solapamiento. Justifica tu elección basándote en la naturaleza técnica de la documentación.
- Selecciona la base de datos vectorial: Elige entre Chroma, Pinecone o pgvector para este caso. Considera que el equipo ya usa PostgreSQL en AWS. Explica tu decisión.
- Diseña el flujo de consulta: Describe los pasos desde que un usuario pregunta "¿Cómo autenticar con OAuth2?" hasta la respuesta generada. Incluye cómo manejarías metadatos (ej., versión de la API).
- Propón una métrica de evaluación: Define una métrica simple para medir la precisión del sistema (ej., porcentaje de respuestas correctas en un set de prueba).
Pistas
- Piensa en cómo la estructura de la documentación (encabezados, código) afecta el chunking.
- Considera los costos de infraestructura y las habilidades del equipo.
- Recuerda que el LLM necesita contexto claro para generar respuestas precisas.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.