

Lección 12 de 25 · Lectura y práctica
Gestión de Índices en Pinecone: Creación y Mantenimiento
Tipo de lección: VideoConcepto claveEn Pinecone, un índice es la estructura principal donde almacenas y consultas tus vectores. Piensa en él como una biblioteca especializada: cada libro (vector) tiene un ID único y contenido.
Del concepto a la práctica
Taller de esta lección
Gestionar un índice implica controlar su esquema y su ciclo de vida. Para una base de preguntas, usa los vectores q-1, q-2 y q-3, todos de dimensión 2, con metadatos tema y version. Antes de cargar, define qué nombres son inmutables y qué campos permitirán filtrar. Así se evita tratar el índice como una tabla sin reglas.
Ejemplo resuelto
Un esquema de prueba con métrica coseno y dimensión 2 acepta los tres registros. Un cuarto vector de dimensión 3 debe rechazarse y quedar registrado como error de validación, sin borrar los anteriores.
Vectores válidos: q-1=[1,0], q-2=[0.8,0.6], q-3=[0,1]; el inválido es q-4=[1,0,0]. Valida la longitud localmente y no envíes q-4. Pinecone tiene consistencia eventual: confirma que la escritura es visible con una comprobación acotada de frescura y recuperación por ID. Un conteo inmediato no basta para declarar que un lote se perdió; tampoco demuestra que todos los valores sean correctos.
Pruébalo
Declara dimensión, métrica y campos de metadatos.
Valida tres vectores antes de cargar.
Intenta cargar uno incompatible en un lote separado.
Comprueba que el conteo válido sigue siendo 3. Error frecuente: recrear el índice para corregir un vector defectuoso y perder la muestra. Corrígelo validando por lotes y usando una zona de prueba.
Comprueba tu resultado
Entrega un registro de aceptación para q-1 a q-3, un rechazo para el vector de dimensión 3 y un conteo final de tres vectores válidos.
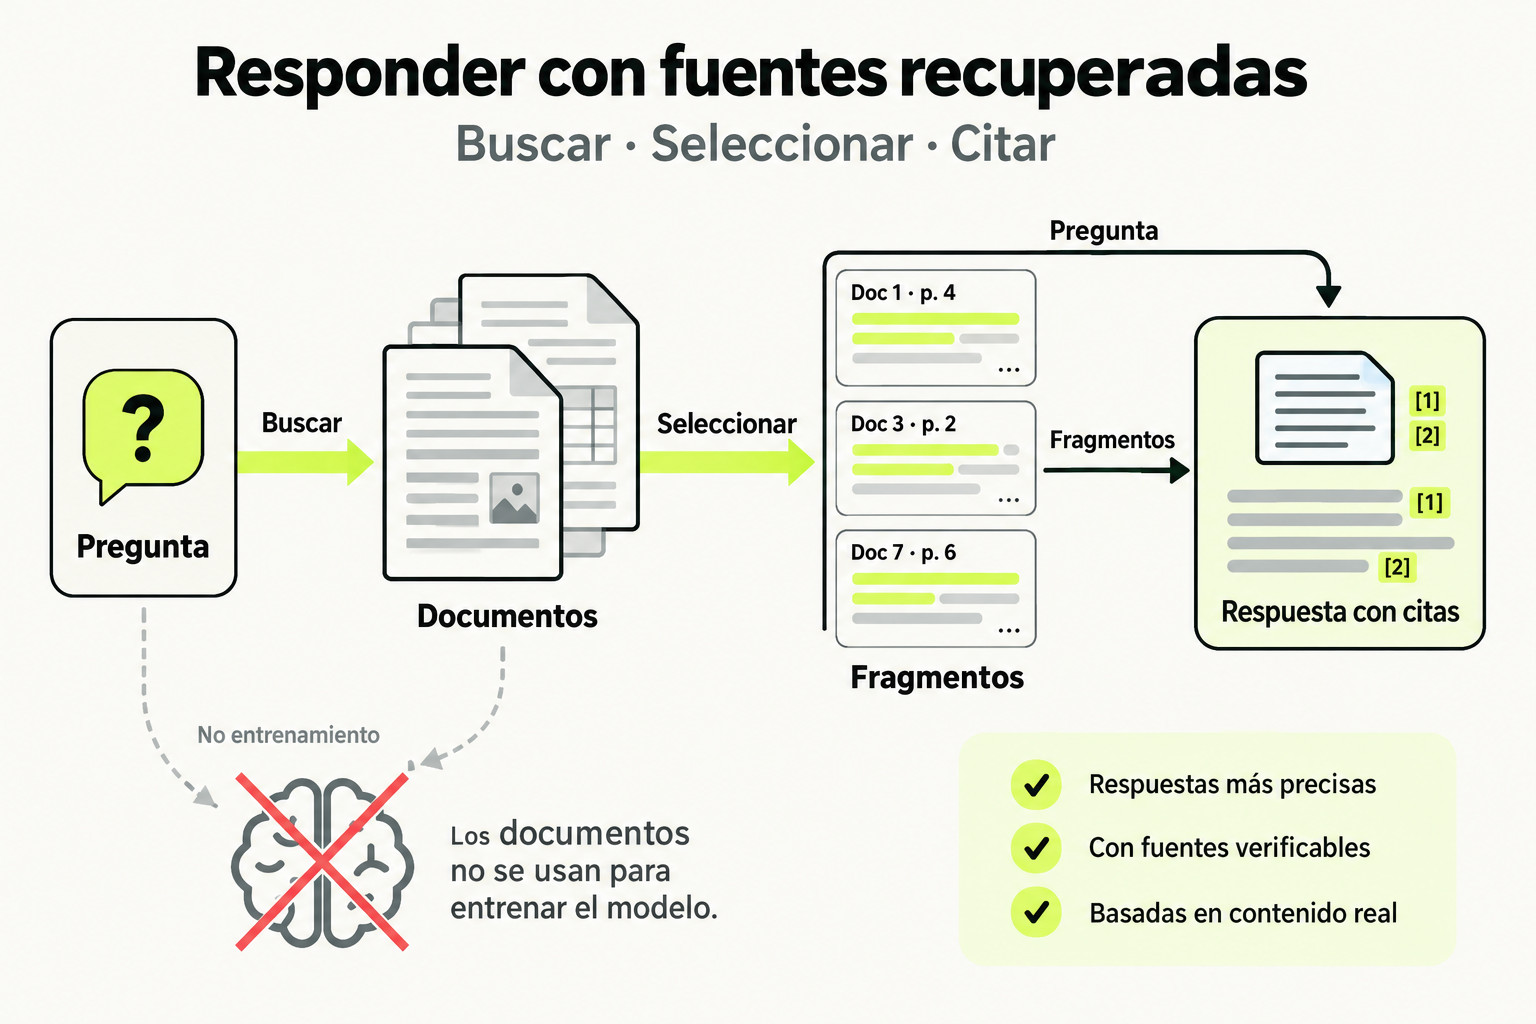
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
En Pinecone, un índice es la estructura principal donde almacenas y consultas tus vectores. Piensa en él como una biblioteca especializada: cada libro (vector) tiene un ID único y contenido (embedding), y el índice organiza estos libros para que puedas encontrar rápidamente los más relevantes cuando buscas algo. A diferencia de bases de datos tradicionales, los índices de Pinecone están optimizados para búsqueda por similitud, usando algoritmos como HNSW (Hierarchical Navigable Small World) para escalar a millones de vectores con baja latencia.
La gestión de índices implica crear, configurar y mantener estos "contenedores" en la nube. Un error común es verlos como tablas SQL; en realidad, son más como índices de búsqueda en tiempo real que deben balancear precisión, velocidad y costo. Por ejemplo, elegir entre un índice pods (dedicados) y serverless afecta directamente tu escalabilidad: pods ofrecen control sobre recursos, mientras serverless escala automáticamente pero con menos personalización.
Cómo funciona en la práctica
Vamos a crear un índice en Pinecone paso a paso, usando un caso de RAG para documentos técnicos. Primero, define los parámetros clave en la API:
import pinecone
pinecone.init(api_key="tu_api_key")

index_name = "tech-docs-index"
metric = "cosine"
dimension = 768  # Dimensión de embeddings de un modelo como BERT
pod_type = "p1.x1"  # Tipo de pod para balancear costo y rendimiento

pinecone.create_index(
    name=index_name,
    dimension=dimension,
    metric=metric,
    pod_type=pod_type
)
Este código crea un índice llamado "tech-docs-index" con 768 dimensiones (típico para embeddings de texto), usando similitud coseno y un pod de tipo p1.x1. Una vez creado, puedes insertar vectores: cada vector incluye un ID, valores numéricos (el embedding), y metadatos opcionales como "categoria" o "fecha". Para consultar, Pinecone compara el embedding de tu pregunta con los almacenados, devolviendo los más similares en milisegundos.
Caso de estudio
Imagina que trabajas en una empresa de software y necesitas un sistema RAG para manuales de producto. Usamos Pinecone para indexar 50,000 documentos con embeddings generados por un modelo como sentence-transformers. Configuramos un índice serverless para manejar picos de tráfico durante lanzamientos.
| Parámetro | Valor | Justificación |
|---|---|---|
| Nombre | product-manuals | Identificador claro |
| Dimensión | 384 | Usamos un modelo más ligero (e.g., all-MiniLM-L6-v2) |
| Métrica | dotproduct | Mejor para similitud semántica en este contexto |
| Tipo | serverless | Escala automática con uso variable |
| Metadatos | ["producto", "version"] | Filtramos búsquedas por producto específico |
Después de cargar los vectores, las consultas como "¿Cómo solucionar error X?" devuelven pasos relevantes de los manuales, mejorando la precisión del RAG en un 40% vs. búsqueda textual. Mantenemos el índice actualizando vectores mensualmente con nuevas versiones, usando la API de upsert para reemplazar datos obsoletos sin recrear el índice.
Errores comunes
- Dimension mismatch: Usar una dimensión incorrecta al crear el índice (e.g., 512 vs. 768) causa errores al insertar vectores. Siempre verifica la dimensión de tus embeddings con el modelo elegido.
- Overprovisioning pods: Seleccionar pods más grandes de lo necesario (e.g., p2.x2 para datos pequeños) aumenta costos innecesariamente. Empieza con lo mínimo y escala según métricas de uso.
- Ignorar métricas de similitud: Elegir "euclidean" en lugar de "cosine" para texto puede reducir precisión. Cosine es mejor para embeddings normalizados; evalúa con datos de prueba.
- No limpiar índices obsoletos: Dejar índices inactivos acumula costos. Usa
pinecone.list_indexes()y elimina los no usados regularmente. - Falta de monitoreo: No revisar latencia o errores en consultas lleva a degradación. Configura alertas en la consola de Pinecone para métricas clave.
Checklist de dominio
- ¿Puedes crear un índice en Pinecone con parámetros apropiados (dimensión, métrica, tipo) para tu caso de uso?
- ¿Sabes insertar y actualizar vectores con metadatos para filtrar búsquedas en RAG?
- ¿Entiendes la diferencia entre pods y serverless, y cuándo usar cada uno?
- ¿Puedes consultar un índice y interpretar los resultados (similitud, IDs, metadatos)?
- ¿Mantienes índices eliminando los inactivos y monitoreando rendimiento?
- ¿Validas que la dimensión de embeddings coincida con la del índice?
- ¿Optimizas costos ajustando configuraciones basado en tráfico real?
Crear y consultar un índice Pinecone para preguntas frecuentes
En este ejercicio, construirás un índice Pinecone para un sistema RAG que responde preguntas frecuentes (FAQ) de soporte técnico. Sigue estos pasos:
- Prepara los datos: Usa un conjunto de 10 preguntas y respuestas de ejemplo (e.g., de un sitio web de ayuda). Genera embeddings para las preguntas usando la biblioteca
sentence-transformers(modelo 'all-MiniLM-L6-v2', dimensión 384). - Crea el índice: Inicializa Pinecone con tu API key (usa una cuenta gratuita). Crea un índice llamado "faq-support" con dimensión 384, métrica "cosine", y tipo "starter" (gratuito).
- Inserta vectores: Para cada pregunta, crea un vector con ID único, el embedding, y metadatos que incluyan la respuesta correspondiente y una categoría (e.g., "hardware", "software"). Usa
upsertpara cargar todos los vectores. - Consulta el índice: Escribe una función que tome una pregunta de usuario, genere su embedding, y consulte el índice para devolver las 3 respuestas más similares. Imprime los resultados con similitud y metadatos.
- Evalúa y ajusta: Prueba con 2-3 preguntas nuevas y verifica si las respuestas son relevantes. Si no, revisa la métrica o embeddings.
Pistas
- Usa la documentación de Pinecone para encontrar el endpoint de API key si no la tienes.
- Recuerda que el tipo "starter" tiene límites; ideal para pruebas pequeñas.
- Incluye metadatos claros para filtrar: ayuda en RAG a recuperar contexto preciso.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.