

Lección 3 de 25 · Lectura y práctica
Configuración Inicial: Entorno de Desarrollo y Primeros Pasos
Tipo de lección: VideoConcepto claveLa Configuración Inicial en sistemas RAG es el proceso de preparar tu entorno de desarrollo para trabajar con bases de datos vectoriales. Piensa en esto como preparar tu taller de carpintería.
Del concepto a la práctica
Taller de esta lección
Una configuración reproducible separa el entorno del sistema y registra las decisiones mínimas. Para una práctica local, conserva tres archivos: requirements.txt, un script de comprobación y una carpeta de datos de prueba. El script no necesita conectarse a servicios externos: puede verificar que una colección recibe un documento y devuelve su ID.
Ejemplo resuelto
El primer laboratorio necesita chromadb; las bibliotecas para generar embeddings se incorporan en una práctica posterior, mientras check.py carga el texto «válvula cerrada», asigna doc-1 y comprueba que la colección contiene una fila. La salida esperada es documentos=1.
Esta comprobación usa vectores manuales de dos dimensiones; no descarga un modelo ni llama a una API de embeddings. No son representaciones semánticas entrenadas. Después de instalar una versión compatible de Chroma en el entorno virtual, registra esa versión y ejecuta:
import chromadb
client = chromadb.EphemeralClient()
collection = client.create_collection("check-rag", embedding_function=None)
collection.add(ids=["doc-1"], documents=["válvula cerrada"], embeddings=[[1.0, 0.0]])
assert collection.count() == 1
assert collection.get(ids=["doc-1"])["ids"] == ["doc-1"]
print("documentos=1")
Pruébalo
Crea un entorno virtual para la práctica.
Instala solo las dependencias declaradas.
Ejecuta una comprobación con un documento sintético.
Guarda la salida y la fecha de ejecución. Error frecuente: mezclar instalaciones globales con las del proyecto. Corrígelo mostrando el intérprete activo y ejecutando el script dentro del entorno.
Comprueba tu resultado
Entrega el listado de dependencias, el comando de ejecución y una salida que indique exactamente una colección, un documento y su identificador. Si el conteo cambia al repetirlo, revisa la persistencia o la limpieza inicial.
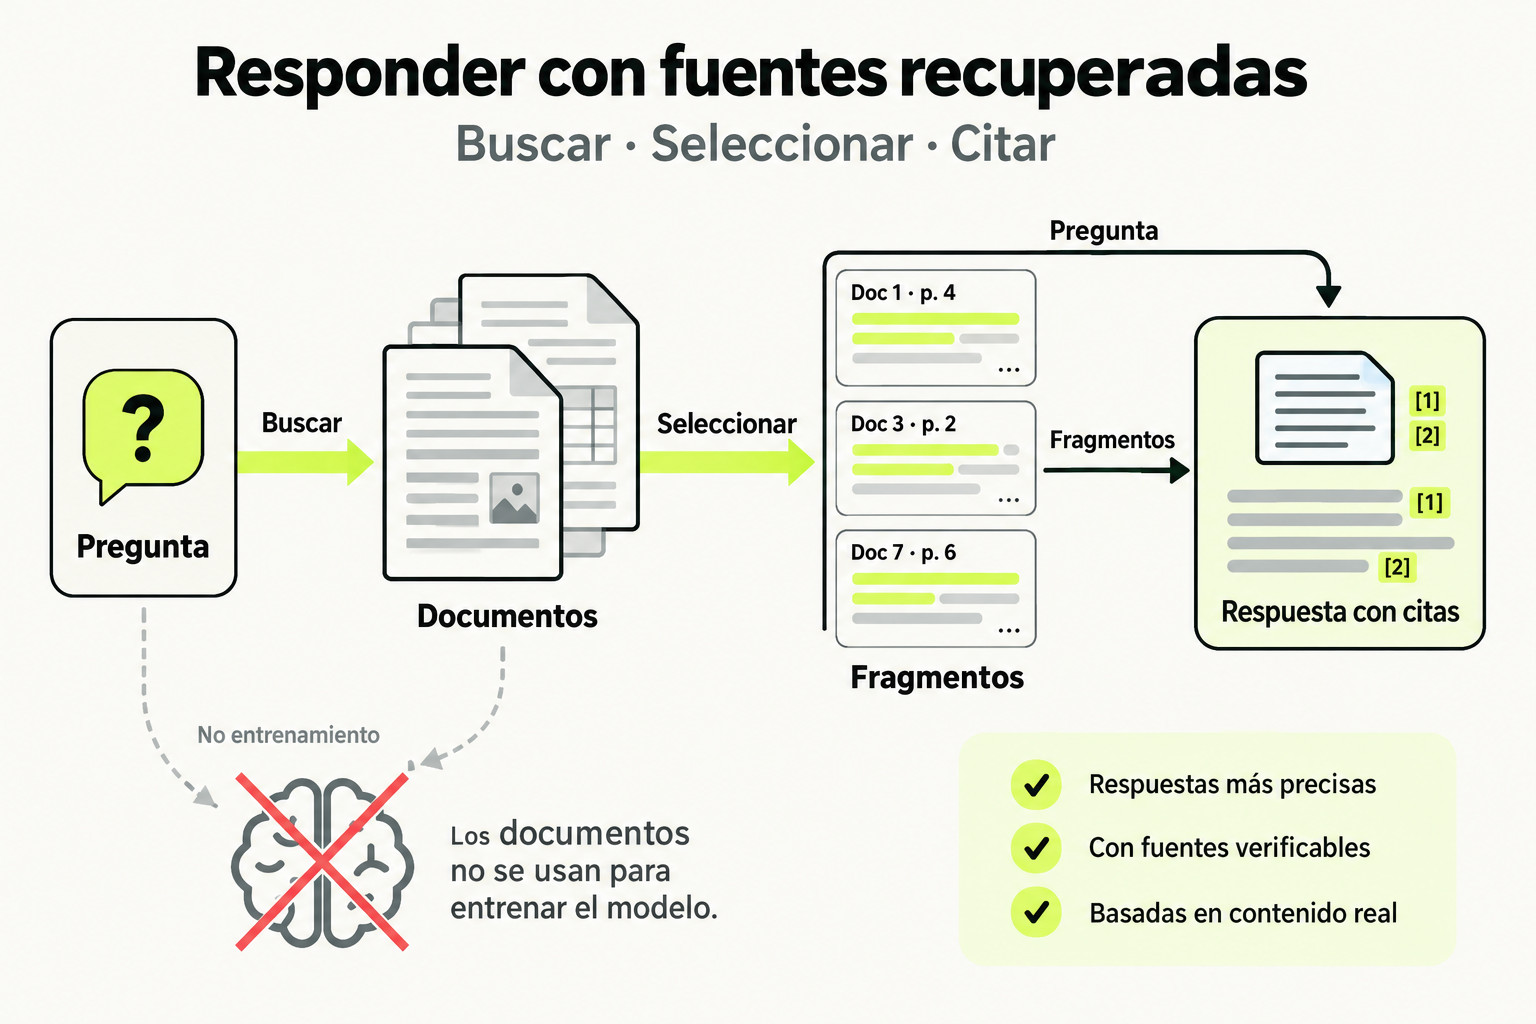
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
La Configuración Inicial en sistemas RAG es el proceso de preparar tu entorno de desarrollo para trabajar con bases de datos vectoriales. Piensa en esto como preparar tu taller de carpintería antes de construir un mueble: necesitas las herramientas correctas, el espacio organizado y los materiales a mano. Sin esta preparación, incluso el mejor diseño fallará en la ejecución.
En el contexto de RAG, esta configuración incluye tres componentes principales: el entorno de Python con las bibliotecas necesarias, la conexión a tu base de datos vectorial elegida, y la estructura inicial para cargar y procesar documentos. Cada base de datos vectorial (Chroma, Pinecone, pgvector) tiene requisitos específicos, pero comparten principios comunes de configuración que dominarás en esta lección.
Cómo funciona en la práctica
Vamos a configurar un entorno básico para trabajar con Chroma, la base de datos vectorial más simple para comenzar. Sigue estos pasos:
- Crea un entorno virtual de Python:
python -m venv rag_env - Activa el entorno e instala las dependencias básicas:
pip install chromadb langchain sentence-transformers - Configura tu primer cliente de Chroma:
import chromadb client = chromadb.Client() collection = client.create_collection(name="documentos_prueba") - Prepara tu primer embedding usando SentenceTransformers:
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('all-MiniLM-L6-v2')
vector = model.encode("Este es mi primer documento")
Esta configuración básica te permite comenzar a experimentar inmediatamente con embeddings y almacenamiento vectorial.
Caso de estudio
Imagina que trabajas en una empresa de e-learning que quiere implementar un asistente de preguntas sobre su contenido educativo. Tu tarea es configurar el entorno para procesar 500 documentos PDF de cursos.
| Componente | Configuración | Justificación |
|---|---|---|
| Entorno Python | Python 3.9+ con 16GB RAM | Compatibilidad con bibliotecas modernas y memoria para embeddings |
| Base de datos | Chroma en modo persistente | Simpleza inicial, almacenamiento local, fácil depuración |
| Modelo de embeddings | all-MiniLM-L6-v2 | Balance entre rendimiento y precisión para texto educativo |
| Estructura de carpetas | /docs, /embeddings, /scripts | Organización escalable para crecimiento futuro |
La elección de Chroma sobre Pinecone o pgvector en esta fase se debe a su simplicidad operacional: no requiere servicios externos ni configuración de base de datos relacional, permitiendo enfocarse en los conceptos fundamentales.
Errores comunes
- No usar entornos virtuales: Instalar bibliotecas globalmente causa conflictos de versiones. Siempre usa
venvocondapara aislar proyectos. - Subestimar los requisitos de memoria: Los modelos de embeddings consumen RAM significativa. Para proyectos medianos, comienza con al menos 8GB disponibles.
- Mezclar versiones incompatibles: ChromaDB 0.4.x tiene API diferente a 0.3.x. Fija versiones en
requirements.txtdesde el inicio. - Ignorar la persistencia: Chroma en modo por defecto (ephemeral) pierde datos al reiniciar. Usa
PersistentClient()para proyectos reales. - No planificar la escalabilidad: Comenzar con estructura de carpetas desorganizada dificulta migrar a Pinecone o pgvector después.
Checklist de dominio
- Entorno virtual de Python configurado y activado
- ChromaDB instalado y cliente básico funcionando
- Modelo de embeddings descargado y produciendo vectores
- Estructura de proyecto organizada con separación clara de responsabilidades
- Sistema de control de versiones (Git) inicializado con .gitignore apropiado
- Script de configuración reproducible (requirements.txt o environment.yml)
- Primera colección de documentos creada y verificada en Chroma
Configura un entorno completo para procesar documentos técnicos
Como ingeniero de datos en una startup tecnológica, necesitas configurar un entorno para procesar documentación técnica de APIs. Sigue estos pasos:
- Crea un nuevo directorio llamado
rag_tecnical_docsy dentro, establece un entorno virtual Python 3.9+ - Instala las siguientes bibliotecas con versiones específicas:
- chromadb==0.4.15
- langchain==0.0.340
- sentence-transformers==2.2.2
- pypdf==3.17.0
- Configura Chroma en modo persistente en una subcarpeta
vector_store - Crea un script
setup.pyque:- Inicialice el cliente persistente de Chroma
- Cree una colección llamada "api_documentation"
- Cargue y convierta a texto un PDF de ejemplo (puedes usar cualquier PDF técnico)
- Genere embeddings para el primer párrafo usando all-MiniLM-L6-v2
- Almacene el embedding en la colección con metadatos básicos
- Verifica la configuración ejecutando el script y confirmando que la colección existe con al menos un documento.
Pistas
- Recuerda que Chroma PersistentClient requiere una ruta de directorio, no un nombre de archivo
- El modelo sentence-transformers se descarga automáticamente en primer uso, lo que puede tomar varios minutos
- Para PDFs simples, langchain tiene document loaders que simplifican la extracción de texto
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.