

Lección 16 de 21 · Lectura y práctica
Diseñar la Arquitectura del Pipeline ETL
Introducción: La Importancia de un Diseño Arquitectónico Sólido Antes de escribir una sola línea de código en Apache Airflow, es fundamental dedicar tiempo al diseño de la arquitectura de nuestro pipeline ETL. Un diseño bien.
Del concepto a la práctica
Taller de esta lección
La arquitectura debe convertir requisitos en contratos verificables. Para ventas, define fuentes pedidos, clientes y productos; establece claves, tipos y reglas antes de decidir operadores. Un diseño sólido muestra dónde se almacenan datos crudos, dónde se validan y qué tabla sirve como salida. También explicita qué ocurre si una fuente no llega.
Ejemplo resuelto
pedidos contiene pedido_id, cliente_id, producto_id y unidades; productos aporta precio. El importe de un pedido con 3 unidades a 8 euros es 24 euros. La unidad es importe, no porcentaje ni precio unitario.
Pruébalo
Escribe el contrato de cada entrada.
Dibuja extracción, validación, transformación y carga.
Marca reintentos, timeout y punto de alerta.
Define consultas para filas, rechazos y suma.
Comprueba tu resultado
Otra persona puede calcular el importe y localizar la tarea responsable de cada dato.
Error frecuente
Empezar por operadores sin conocer claves ni reglas. Corrige documentando identidad, unidades y destino antes del código.
Ejercicio: añade dos pedidos completos y calcula sus importes. Resultado esperado: cada cálculo se reproduce con unidades × precio, y los registros con claves ausentes quedan rechazados.
Ejemplo íntegro y separación de flujos
Clientes: C1=Ana. Productos: P1 con precio=8 y P2 con precio=5, todos en euros. Pedidos: O1=(C1,P1,3 unidades) y O2=(C1,P2,2 unidades). El contrato exige cantidades enteras positivas y claves existentes. O1=24, O2=10, dos filas y total=34. Cambiar el producto de O2 a P999 produce un rechazo y una fila válida por 24 bajo una política explícita por registro.
Separar muchos DAGs no elimina la necesidad de coordinar sus intervalos: uno programado a las 02:00 y otro a las 03:00 no comparten necesariamente fecha lógica. Un ExternalTaskSensor necesita alinear correctamente la ejecución esperada, o se puede diseñar una dependencia por Assets. Dentro de un DAG, recuperar una tarea fallida tampoco obliga siempre a repetir las que ya terminaron y dejaron resultados persistentes.
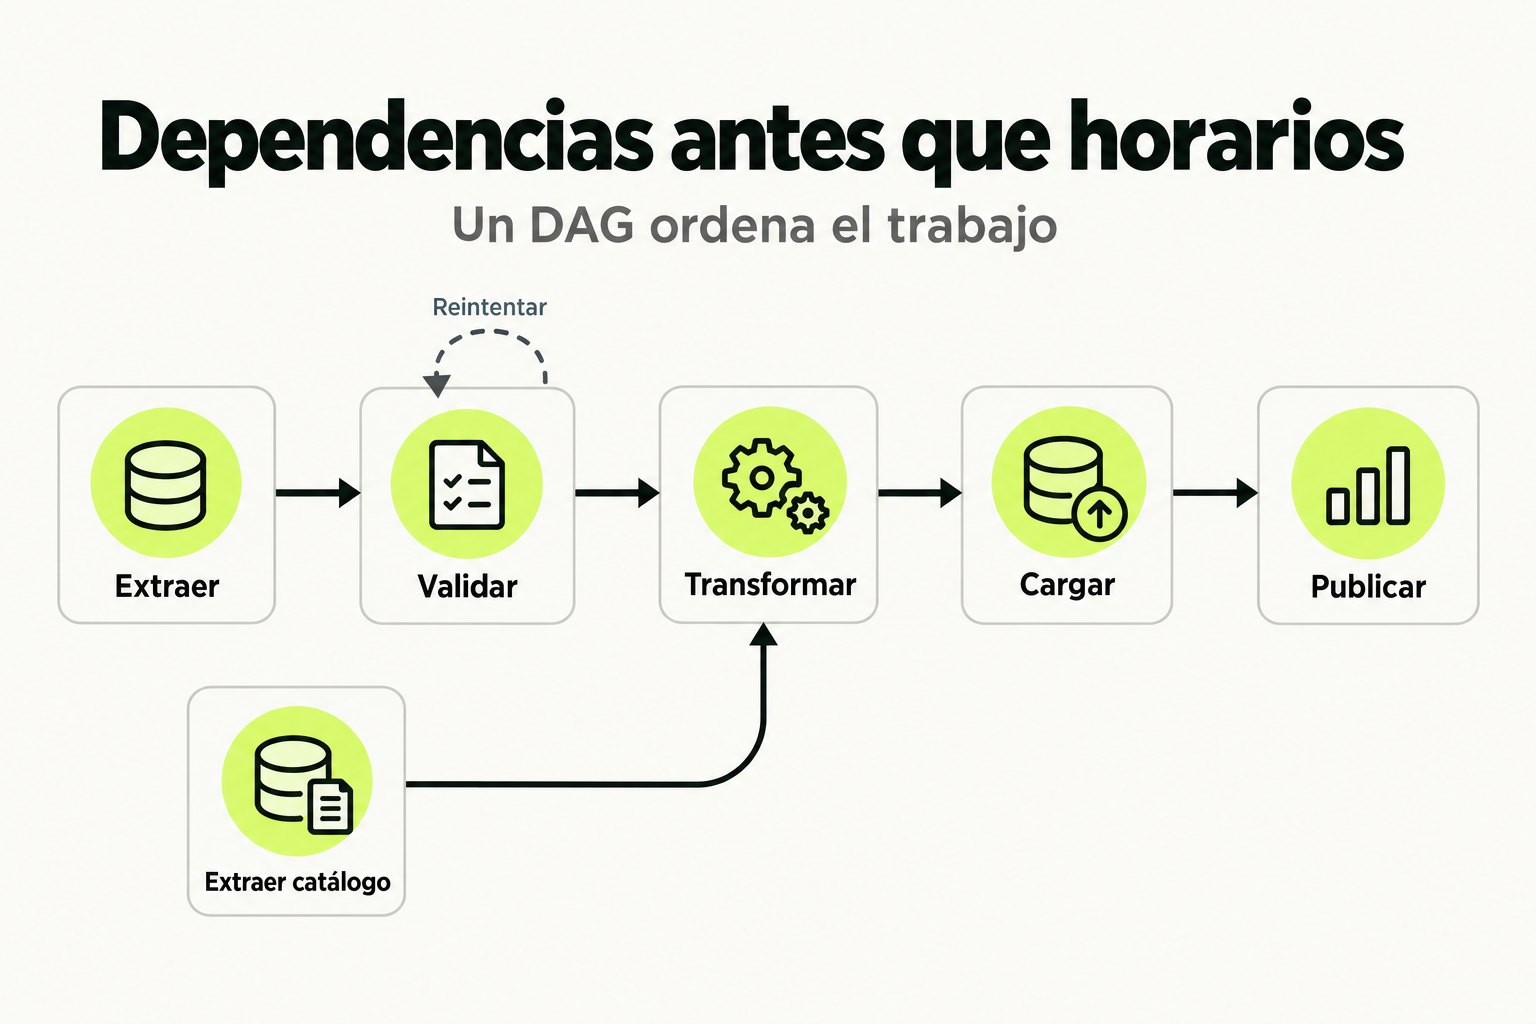
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Introducción: La Importancia de un Diseño Arquitectónico Sólido
Antes de escribir una sola línea de código en Apache Airflow, es fundamental dedicar tiempo al diseño de la arquitectura de nuestro pipeline ETL. Un diseño bien pensado no es un lujo, sino una necesidad para la orquestación de procesos complejos. Esta fase determina la escalabilidad, mantenibilidad, resiliencia y eficiencia de todo el sistema de datos. Un error común es lanzarse directamente a codificar DAGs y tareas sin un plan claro, lo que rápidamente conduce a un código espagueti difícil de depurar, extender o monitorear.
En esta lección, nos enfocaremos en diseñar la arquitectura para un proyecto integrador complejo: un pipeline que consume datos de múltiples fuentes (APIs REST, bases de datos SQL, archivos en cloud storage), los transforma aplicando lógica de negocio, los consolida en un data warehouse y, finalmente, genera reportes y alertas. El objetivo es transformar requisitos de negocio en una estructura de componentes de Airflow claramente definidos, identificando dependencias, puntos de fallo y estrategias de recuperación desde el primer momento.
Pensar en arquitectura es pensar en el panorama completo. Debemos responder preguntas como: ¿Cómo se agrupan las tareas lógicamente? ¿Dónde residen los datos entre cada etapa? ¿Cómo manejamos errores transitorios de red? ¿Cómo aseguramos que el pipeline sea idempotente? Las respuestas a estas preguntas se materializarán en la estructura de nuestros DAGs, la definición de nuestros operadores y el flujo de nuestros datos.
Concepto Clave: Descomposición Modular y Flujo de Datos
El principio fundamental para diseñar un pipeline ETL complejo en Airflow es la descomposición modular. En lugar de construir un DAG gigante con docenas de tareas lineales, debemos dividir el proceso en módulos lógicos e independientes. Cada módulo se convierte en un DAG o un conjunto de tareas dentro de un DAG que cumple una función específica (extracción de una fuente, una transformación crítica, una carga final). Esto es análogo a la construcción de un automóvil: no se ensambla todo de una vez. Un equipo construye el motor (extracción), otro el chasis (transformación), otro la carrocería (carga) y finalmente se integran. Si falla la línea de pintura (un módulo), no es necesario detener toda la fábrica, solo se repara o reprograma ese módulo específico.
El otro pilar es definir explícitamente el flujo de datos. Airflow orquesta tareas, no datos. Es nuestra responsabilidad diseñar cómo los datos pasan de una etapa a otra. Las opciones comunes son: usar almacenamiento temporal (como XCom para datos pequeños, o S3/GCS para intermedios), o hacer que cada tarea lea directamente de la fuente de datos anterior. La elección impacta en la idempotencia y el rendimiento. Una analogía útil es una cadena de montaje de pizzas: la masa cruda (datos brutos) pasa por la estación de salsa (transformación 1), luego a la de ingredientes (transformación 2) y al horno (carga). Cada estación debe saber exactamente qué recibe de la anterior y dónde dejar su resultado para la siguiente.
Tip del Experto: Dibuja un diagrama de flujo de datos en una pizarra o herramienta como draw.io antes de codificar. Identifica claramente los "contratos de datos" entre módulos: formato (JSON, Parquet), esquema, y ubicación. Esto evitará innumerables dolores de cabeza de integración más adelante.
Cómo Funciona en la Práctica: De los Requisitos al Diagrama de DAGs
Imaginemos que nuestro proyecto integrador tiene los siguientes requisitos: 1) Extraer datos diarios de ventas de una API REST y de una base de datos PostgreSQL. 2) Enriquecer los datos de ventas con información de clientes de un archivo CSV en S3. 3) Calcular métricas agregadas y limpiar los datos. 4) Cargar el resultado final en una tabla de Redshift. 5) Enviar un reporte por email si las ventas superan un umbral y alertar por Slack si hay fallos.
El primer paso es la descomposición modular. Podríamos diseñar tres DAGs principales: dag_extraccion (que corre a las 2 AM), dag_transformacion (que corre a las 3 AM y depende del éxito del anterior), y dag_carga_reportes (a las 4 AM). Dentro de dag_extraccion, tendríamos tareas paralelas para la API y PostgreSQL. Los datos extraídos se guardarían en ubicaciones específicas en S3 (por ejemplo, s3://bucket/raw/fecha/tipo_de_datos.parquet). La finalización exitosa de este DAG "despierta" al dag_transformacion a través de un TriggerDagRunOperator o, más comúnmente, mediante una dependencia temporal programada y sensores.
El segundo paso es definir la comunicación. El nombre del archivo en S3 (con la fecha de ejecución) será la "piedra angular" que pase de un DAG a otro. Podemos usar XCom para pasar este nombre de archivo entre tareas dentro de un mismo DAG, pero para la comunicación entre DAGs, usaremos un patrón basado en el sistema de archivos o metadatos. Cada DAG es autónomo: dag_transformacion buscará en S3 los archivos correspondientes a la fecha de ejecución. Si no están, falla. Esto asegura idempotencia.
Código en Acción: Esqueleto de la Arquitectura Multi-DAG
A continuación, se presenta el esqueleto arquitectónico de nuestro proyecto. Este no es un código ejecutable por sí solo, sino la estructura de directorios y la definición base de los DAGs principales que implementan nuestro diseño.
# Estructura de proyecto propuesta
# mi_proyecto_etl/
# │
# ├── dags/
# │   ├── __init__.py
# │   ├── dag_extraccion.py
# │   ├── dag_transformacion.py
# │   └── dag_carga_reportes.py
# │
# ├── plugins/
# │   ├── __init__.py
# │   ├── operators/
# │   │   ├── __init__.py
# │   │   ├── s3_to_redshift.py
# │   │   └── api_to_s3.py
# │   └── helpers/
# │       ├── __init__.py
# │       └── sql_queries.py
# │
# └── config/
#     └── variables.json

# dags/dag_extraccion.py
from datetime import datetime, timedelta
from airflow import DAG
from airflow.operators.python import PythonOperator
from airflow.providers.amazon.aws.sensors.s3 import S3KeySensor
from plugins.operators.api_to_s3 import APIToS3Operator
from airflow.providers.postgres.operators.postgres import PostgresOperator
from airflow.utils.dates import days_ago

default_args = {
    'owner': 'data_team',
    'depends_on_past': False,
    'start_date': days_ago(1),
    'email_on_failure': True,
    'email_on_retry': False,
    'retries': 2,
    'retry_delay': timedelta(minutes=5),
}

with DAG('dag_extraccion',
         default_args=default_args,
         description='Extrae datos de API y Postgres a S3',
         schedule_interval='0 2 * * *',  # Cada día a las 2 AM
         catchup=False,
         max_active_runs=1) as dag:

    # Sensor para verificar la existencia de un archivo de control (opcional)
    esperar_entrada = S3KeySensor(
        task_id='esperar_archivo_configuracion',
        bucket_key='s3://mi-bucket/config/entrada_habilitada.txt',
        aws_conn_id='aws_default',
        timeout=18*60*60,  # 18 horas
        poke_interval=60*60,  # 1 hora
        mode='reschedule'
    )

    # Extracción desde API
    extraer_api = APIToS3Operator(
        task_id='extraer_datos_desde_api',
        endpoint='https://api.ejemplo.com/ventas',
        s3_bucket='mi-bucket-raw',
        s3_key='raw/{{ ds }}/ventas_api.json',
        http_conn_id='api_ventas',
        aws_conn_id='aws_default'
    )

    # Extracción desde PostgreSQL
    extraer_postgres = PostgresOperator(
        task_id='extraer_datos_desde_postgres',
        sql="""
            COPY (
                SELECT * FROM ventas WHERE fecha_venta = '{{ ds }}'
            ) TO STDOUT WITH CSV HEADER;
            -- Nota: En la práctica, se usaría un operador personalizado
            -- para subir este CSV directamente a S3.
        """,
        postgres_conn_id='postgres_warehouse'
    )

    # Tarea para consolidar metadatos de la extracción
    generar_manifest = PythonOperator(
        task_id='generar_archivo_manifest',
        python_callable=lambda **context: open(f'/tmp/manifest_{context["ds"]}.txt', 'w').write('EXTRACCION_COMPLETADA'),
        dag=dag
    )

    # Definición de dependencias
    esperar_entrada >> [extraer_api, extraer_postgres] >> generar_manifest
# dags/dag_transformacion.py
from datetime import datetime, timedelta
from airflow import DAG
from airflow.operators.python import PythonOperator
from airflow.operators.dummy import DummyOperator
from airflow.providers.amazon.aws.operators.glue import AwsGlueJobOperator
from airflow.sensors.external_task import ExternalTaskSensor

default_args = {
    'owner': 'data_team',
    'depends_on_past': True,  # ¡Importante! Depende de la ejecución pasada de ESTE DAG.
    'start_date': days_ago(1),
    'retries': 1,
}

with DAG('dag_transformacion',
         default_args=default_args,
         description='Transforma y enriquece datos en S3',
         schedule_interval='0 3 * * *',  # 3 AM, después de la extracción
         catchup=False) as dag:

    # Sensor que espera a que el DAG de extracción se complete con éxito PARA LA MISMA FECHA DE EJECUCIÓN.
    esperar_extraccion = ExternalTaskSensor(
        task_id='esperar_extraccion_completa',
        external_dag_id='dag_extraccion',
        external_task_id='generar_archivo_manifest',  # Espera esta tarea específica
        execution_date_fn=lambda dt: dt,  # Espera la misma fecha lógica
        allowed_states=['success'],
        failed_states=['failed', 'skipped'],
        mode='reschedule',
        timeout=6*60*60  # 6 horas
    )

    # Ejecutar un job de AWS Glue (Spark) para transformación pesada
    ejecutar_transformacion_glue = AwsGlueJobOperator(
        task_id='ejecutar_job_de_transformacion',
        job_name='mi_etl_job_spark',
        script_location='s3://mi-bucket-scripts/transformacion.py',
        s3_bucket='mi-bucket-scripts',
        iam_role_name='my-glue-role',
        create_job_kwargs={'GlueVersion': '3.0', 'WorkerType': 'G.1X', 'NumberOfWorkers': 2},
        aws_conn_id='aws_default',
        dag=dag
    )

    # Validación de la salida transformada
    validar_datos = PythonOperator(
        task_id='validar_calidad_datos',
        python_callable=_validar_calidad,  # Función definida en otro módulo
        op_kwargs={'execution_date': '{{ ds }}'}
    )

    # Flujo lineal después del sensor
    esperar_extraccion >> ejecutar_transformacion_glue >> validar_datos
Errores Comunes y Cómo Evitarlos
1. El Monolítico Indebuggable: Codificar todo en un solo DAG masivo de 50 tareas. Esto hace que los logs sean inmanejables y un fallo en la tarea 49 requiera re-ejecutar las 48 anteriores. Solución: Aplica descomposición modular. Crea DAGs separados por dominio lógico o etapa del proceso (Extraer, Transformar, Cargar). Usa sensores o TriggerDagRunOperator para orquestarlos.
2. Acoplamiento Excesivo con XCom: Usar XCom para pasar grandes volúmenes de datos (como DataFrames de pandas) entre tareas. XCom está respaldado por la base de datos de metadatos de Airflow y tiene un límite de tamaño. Esto ralentizará tu base de datos y puede causar fallos. Solución: Usa XCom solo para metadatos pequeños (nombres de archivos, conteos, flags). Para los datos en sí, utiliza almacenamiento intermedio como S3, GCS, o un sistema de archivos compartido. Pasa la ruta del archivo a través de XCom.
3. Falta de Idempotencia: Diseñar un pipeline que, al re-ejecutarse, duplica datos en el destino o falla porque intenta crear tablas que ya existen. Solución: Diseña cada tarea y DAG para que sea idempotente. Usa la fecha de ejecución ({{ ds }}) en las rutas de archivos y en las claves de inserción. Emplea sentencias SQL del tipo "INSERT ON CONFLICT" o "MERGE". Las tareas deben poder fallar y re-ejecutarse sin efectos secundarios no deseados.
4. Mala Gestión de Dependencias Externas: Asumir que una API o una base de datos externa siempre estará disponible y responderá rápidamente. Esto lleva a timeouts y fallos en cascada. Solución: Implementa mecanismos de resiliencia. Usa retries con backoff exponencial en tus operadores. Emplea sensores (como HttpSensor, S3KeySensor) para esperar gentilmente por recursos externos. Considera patrones de circuit breaker en operadores personalizados para fuentes particularmente inestables.
5. Ignorar el Patrón de "Catchup": Configurar catchup=True (por defecto) en un DAG con un start_date en el pasado sin considerar las consecuencias. Airflow creará ejecuciones para todas las fechas perdidas, lo que puede saturar el sistema. Solución: Establece catchup=False en la definición del DAG a menos que tengas una necesidad explícita de reprocesar datos históricos. Para backfills controlados, usa el comando CLI airflow dags backfill con un rango de fechas específico.
Checklist de Dominio del Diseño Arquitectónico
- ¿He dibujado un diagrama que muestra todos los DAGs, sus tareas principales y las dependencias entre ellos (tanto internas como externas)?
- ¿He definido claramente el contrato de datos (formato, esquema, ubicación) entre cada etapa del pipeline (extracción, transformación, carga)?
- ¿He descompuesto el proceso en DAGs o grupos de tareas modulares, evitando un DAG monolítico?
- ¿He elegido un mecanismo adecuado para pasar datos/metadatos entre tareas (XCom para metadatos, almacenamiento externo para datos)?
- ¿He asegurado que cada tarea y DAG sea idempotente, usando la fecha lógica de ejecución en rutas y lógica de negocio?
- ¿He implementado estrategias de resiliencia (retries, sensores, timeouts apropiados) para manejar fallos transitorios en sistemas externos?
- ¿He configurado correctamente los parámetros de programación (schedule_interval, catchup, start_date) y dependencias (depends_on_past, ExternalTaskSensor) para cada DAG?
- ¿He planificado cómo se integrará el monitoreo y las alertas (on_success_callback, on_failure_callback, métricas) en esta arquitectura?
Sigue con Apache Airflow: Orquestación de Pipelines ETL Complejos con DAGs
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.