

Lección 20 de 20 · Lectura y práctica
Quiz: Evaluación del Proyecto Integrador
Tipo de lección: QuizConcepto claveUn pipeline de datos en tiempo real con Apache Airflow no procesa datos instantáneamente como un sistema de streaming, sino que orquesta tareas que se ejecutan con alta frecuencia (por ejemplo,.
Del concepto a la práctica
Taller de esta lección
Explicación específica
La evaluación final debe distinguir un DAG frecuente de un sistema de streaming, comprobar idempotencia y medir resultados con datos observables. Una respuesta correcta no depende de memorizar nombres: debe justificar cuándo reintentar, qué guardar como estado y cómo demostrar que una carga no duplica filas.
Ejemplo resuelto
Considera estas respuestas: respuestas = ["B", "A", "C", "B"] y clave = ["B", "A", "C", "D"]. El cálculo es determinista:
respuestas = ["B", "A", "C", "B"]
clave = ["B", "A", "C", "D"]
aciertos = sum(r == c for r, c in zip(respuestas, clave))
puntuacion = aciertos / len(clave) * 100
assert aciertos == 3 and puntuacion == 75.0
La cuarta respuesta falla porque una alerta tras el último reintento no equivale a alertar en cada intento.
Pruébalo
Lee cada caso y separa hecho, riesgo y decisión.
Comprueba que la opción elegida respete el orden de tareas.
Calcula la puntuación con la clave completa.
Revisa cada error y escribe la evidencia que faltó.
Comprueba tu resultado
Error frecuente: confundir una ejecución cada minuto con procesamiento instantáneo. Corrige la respuesta indicando que el DAG coordina lotes frecuentes.
Ejercicio: usa respuestas = ["B", "C", "C", "D"] con la misma clave. Resultado esperado: 3 aciertos y 75.0%; justifica que la segunda opción debe cambiarse de C a A.
Cuatro preguntas con opciones completas
¿Qué representa un DAG cada cinco minutos? A) Un stream instantáneo; B) Un trabajo periódico finito; C) Un bucle infinito obligatorio; D) Una garantía de latencia de un segundo.
¿Qué protege frente a dos eventos distintos con el mismo timestamp? A) Identidad única más deduplicación persistente; B) Usar solo la hora; C) Borrar ambas filas; D) Aumentar retries.
¿Cuándo avanzar el marcador de lectura? A) Antes de extraer; B) Antes de cargar; C) Después de confirmar la carga, con estrategia de recuperación; D) Cuando aparezca el DAG en la interfaz.
¿Qué regla de alerta se ha definido para un error transitorio con reintentos? A) Cada import del DAG; B) Cada intento fallido; C) Nunca; D) Fallo definitivo, conservando logs de los intentos.
La clave completa es B,A,C,D. La primera respuesta B,A,C,B obtiene tres aciertos; la segunda B,C,C,D también obtiene tres. Ambas dan 75%, pero requieren corregir preguntas distintas. Antes de puntuar exige igual longitud de respuestas y clave, pues zip por sí solo trunca. Airflow 3 usa schedule; para nuevas prácticas importa del SDK y providers actuales. Un timestamp de publicación por sí solo no es una identidad segura.
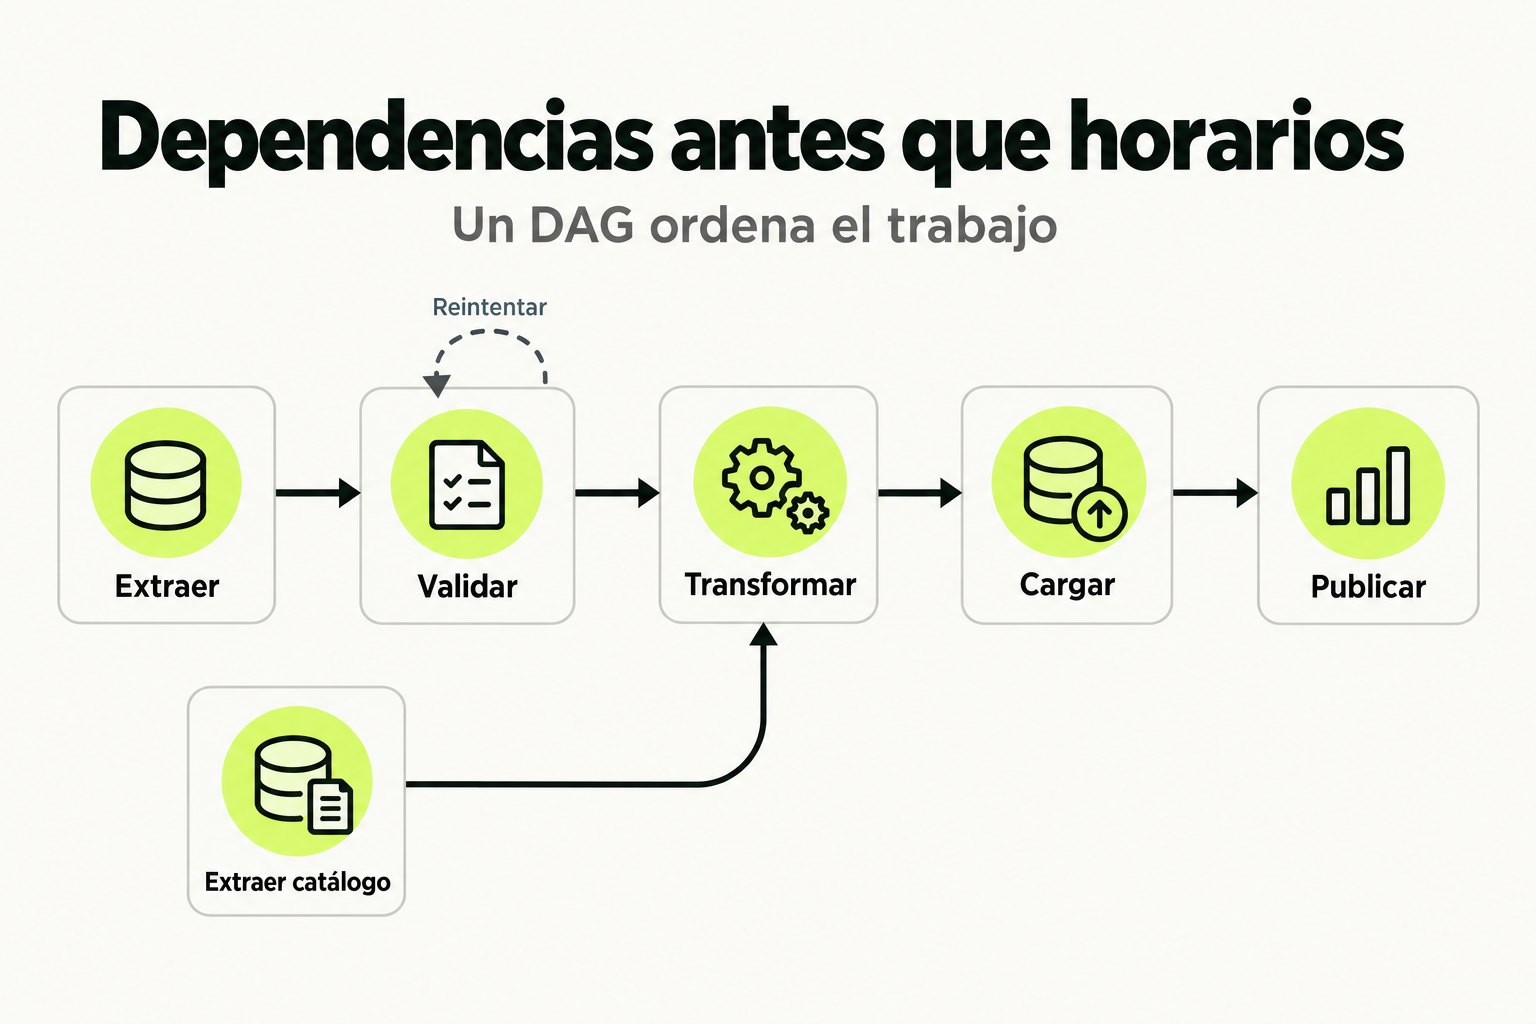
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
Un pipeline de datos en tiempo real con Apache Airflow no procesa datos instantáneamente como un sistema de streaming, sino que orquesta tareas que se ejecutan con alta frecuencia (por ejemplo, cada minuto) para manejar datos casi en tiempo real. Piensa en esto como una línea de ensamblaje en una fábrica: los datos llegan continuamente, y Airflow coordina los pasos de extracción, transformación y carga (ETL) de manera automatizada y confiable, asegurando que cada lote se procese en el momento adecuado.
En este contexto, los DAGs (Directed Acyclic Graphs) son el corazón de Airflow, definiendo las dependencias entre tareas. Para pipelines en tiempo real, se configuran con intervalos cortos usando schedule_interval (como '*/1 * * * *' para cada minuto). La clave está en diseñar DAGs que sean idempotentes (pueden ejecutarse múltiples veces sin efectos secundarios) y tolerantes a fallos, ya que los datos fluyen constantemente y los errores deben manejarse sin interrumpir el flujo completo.
Cómo funciona en la práctica
Imagina que estás construyendo un pipeline para analizar transacciones de una tienda online en tiempo real. Sigue estos pasos:
- Diseño del DAG: Define un DAG con un schedule_interval de 5 minutos. Las tareas incluyen: extraer datos de una API de transacciones, transformarlos para calcular métricas como ventas por producto, y cargar los resultados en una base de datos analítica.
- Configuración de tareas: Usa operadores de Airflow como PythonOperator para la extracción y transformación, y PostgresOperator para la carga. Establece dependencias con set_upstream o >> para que las tareas se ejecuten en orden.
- Manejo de errores: Implementa retries y alertas en caso de fallos en la API o la base de datos, usando parámetros como retries y email_on_failure.
- Monitoreo: Utiliza la interfaz web de Airflow para ver el estado de las ejecuciones y métricas como duración de tareas.
Ejemplo de código para un DAG básico:
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime, timedelta

def extract_data():
    # Lógica para extraer datos de una API
    pass

def transform_data():
    # Lógica para transformar datos
    pass

def load_data():
    # Lógica para cargar a una base de datos
    pass

default_args = {
    'owner': 'data_engineer',
    'retries': 3,
    'retry_delay': timedelta(minutes=5)
}

dag = DAG(
    'tienda_online_realtime',
    default_args=default_args,
    description='Pipeline para transacciones en tiempo real',
    schedule_interval='*/5 * * * *',
    start_date=datetime(2023, 10, 1)
)

extract_task = PythonOperator(
    task_id='extract_transactions',
    python_callable=extract_data,
    dag=dag
)

transform_task = PythonOperator(
    task_id='transform_metrics',
    python_callable=transform_data,
    dag=dag
)

load_task = PythonOperator(
    task_id='load_to_db',
    python_callable=load_data,
    dag=dag
)

extract_task >> transform_task >> load_task
Caso de estudio
Una empresa de logística necesita monitorear entregas en tiempo real para optimizar rutas. Implementan un pipeline con Airflow que:
- Extrae: Datos de GPS de camiones cada 2 minutos desde una API REST.
- Transforma: Calcula la distancia recorrida y estima tiempos de entrega usando Python y pandas.
- Carga: Inserta los resultados en una tabla de PostgreSQL para dashboards en tiempo real.
El DAG se ejecuta cada 2 minutos (schedule_interval='*/2 * * * *'), con tareas paralelas para diferentes regiones. Usan XComs para pasar datos entre tareas, como las coordenadas procesadas. Un error común fue no manejar datos duplicados; lo solucionaron agregando una capa de idempotencia en la transformación.
Resultado: Reducción del 15% en tiempos de entrega gracias a la visibilidad en tiempo real proporcionada por el pipeline.
Errores comunes
- Programar DAGs con start_date en el futuro o muy atrás: Esto puede causar ejecuciones no deseadas o faltantes. Solución: Usa una start_date fija en el pasado y prueba con airflow backfill si es necesario.
- No manejar fallos en fuentes de datos externas: Si una API falla, el pipeline puede detenerse. Solución: Implementa retries y timeouts en las tareas, y considera usar sensores para esperar datos.
- Olvidar la idempotencia: En pipelines en tiempo real, los datos pueden reprocesarse accidentalmente. Solución: Diseña tareas que verifiquen si los datos ya fueron procesados, usando marcas de tiempo o IDs únicos.
- Sobrecargar el scheduler con intervalos muy cortos: Un schedule_interval de segundos puede saturar Airflow. Solución: Usa intervalos de minutos o más, y optimiza el código para ejecuciones rápidas.
- Ignorar el monitoreo de recursos: Pipelines frecuentes pueden consumir mucha CPU o memoria. Solución: Configura límites en los operadores y monitorea métricas del sistema.
Checklist de dominio
- ¿Puedes diseñar un DAG con schedule_interval para ejecuciones cada 1-5 minutos?
- ¿Sabes configurar retries y manejo de errores en tareas de Airflow?
- ¿Eres capaz de implementar idempotencia en un pipeline de datos?
- ¿Puedes usar XComs para pasar datos entre tareas en un DAG?
- ¿Sabes monitorear y depurar ejecuciones de DAGs en la interfaz web de Airflow?
- ¿Puedes optimizar un DAG para reducir su tiempo de ejecución?
- ¿Eres capaz de integrar Airflow con fuentes de datos comunes como APIs o bases de datos?
Implementa un Pipeline de Datos en Tiempo Real para Análisis de Redes Sociales
En este ejercicio, crearás un DAG en Airflow que simule un pipeline en tiempo real para analizar publicaciones de redes sociales. Sigue estos pasos:
- Configura el entorno: Asegúrate de tener Airflow instalado y funcionando localmente o en un entorno de prueba.
- Diseña el DAG: Crea un archivo Python llamado
social_media_realtime.py. Define un DAG con:- Nombre:
social_media_analysis - schedule_interval: '*/3 * * * *' (cada 3 minutos)
- start_date: una fecha pasada, como datetime(2023, 10, 1)
- default_args con owner='tu_nombre' y retries=2
- Nombre:
- Agrega tareas: Implementa tres tareas usando PythonOperator:
- extraer_publicaciones: Simula la extracción de datos de una API de redes sociales (puedes usar una lista fija de diccionarios con claves como 'usuario', 'texto', 'timestamp').
- analizar_sentimiento: Transforma los datos para analizar el sentimiento del texto (puede ser simple, como contar palabras positivas/negativas).
- guardar_resultados: Carga los resultados en un archivo CSV o una base de datos SQLite, asegurándote de evitar duplicados usando el timestamp.
- Establece dependencias: Ordena las tareas para que se ejecuten secuencialmente.
- Prueba el DAG: Ejecuta
airflow dags listpara verificar que aparezca, y usaairflow tasks test social_media_analysis extraer_publicaciones 2023-10-01para probar una tarea. - Monitorea: Accede a la interfaz web de Airflow y verifica que el DAG se active cada 3 minutos y complete las ejecuciones exitosamente.
Entrega: El archivo Python del DAG y una captura de pantalla de la interfaz web mostrando al menos una ejecución exitosa.
Pistas
- Usa el módulo datetime para manejar timestamps y evitar duplicados en la carga.
- Para simular datos, puedes hardcodear una lista de publicaciones en la función de extracción.
- Si usas SQLite, recuerda cerrar conexiones después de cada tarea para evitar bloqueos.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.