

Lección 9 de 20 · Lectura y práctica
Ejercicio: Construir un DAG con Múltiples Ramas y Fallback
Concepto claveEn pipelines ETL complejos, los flujos de trabajo rara vez son lineales. A menudo necesitas ramificaciones para manejar diferentes escenarios de datos y mecanismos de fallback para garantizar la resiliencia del.
Del concepto a la práctica
Taller de esta lección
Un fallback debe conservar información sobre por qué se activó. En un DAG que recibe archivos, la decisión puede clasificar csv, json o desconocido; la ruta alternativa no debe fingir que el archivo fue procesado correctamente. Su salida puede ser un registro de rechazo con nombre, motivo y fecha de ejecución.
Ejemplo resuelto
Para ventas.csv, se ejecuta leer_csv; para ventas.json, leer_json; para ventas.xml, se ejecuta rechazar_formato. El resultado común recibe estado=procesado o estado=rechazado. Así, una ausencia de datos no se confunde con cero ventas.
Pruébalo
Crea un archivo de cada formato indicado.
Implementa la función que devuelve el
task_idcorrespondiente.Haz que cada rama produzca una salida con estado.
Une las salidas y cuenta cada estado.
Comprueba tu resultado
Error frecuente: usar un fallback que devuelve una tabla vacía y marca éxito. Corrige escribiendo el motivo del rechazo y dejando la decisión visible en logs. El resultado esperado para los tres archivos es dos procesados, un rechazado y un resumen con conteos procesado=2, rechazado=1.
Entradas completas y fallback determinista
ventas.csv contiene id,importe
V1,10
; ventas.json contiene [{"id":"V2","importe":8}]; ventas.xml contiene <ventas><venta id="V3" importe="5"/></ventas>. Este ejercicio admite CSV y JSON, y rechaza XML; no inventa un parser para él. Ejecuta tres corridas con un archivo por corrida y agrega sus registros de negocio: dos procesados, un rechazado, importe válido=18.
Una rama elegida por formato desconocido utiliza su dependencia normal, no all_failed: las rutas no elegidas están skipped, no failed. Para un fallback por fallo de una fuente diseña explícitamente la regla de fallo y qué fuente sustituye; la rama de decisión no se ejecuta automáticamente tras una tarea fallida con all_success. La recuperación debe indicar origen y antigüedad y no llamar aleatoriamente a APIs para probar. Una ruta de rechazo que termina bien no dispara un callback de fallo del DAG; observa también su estado de negocio.
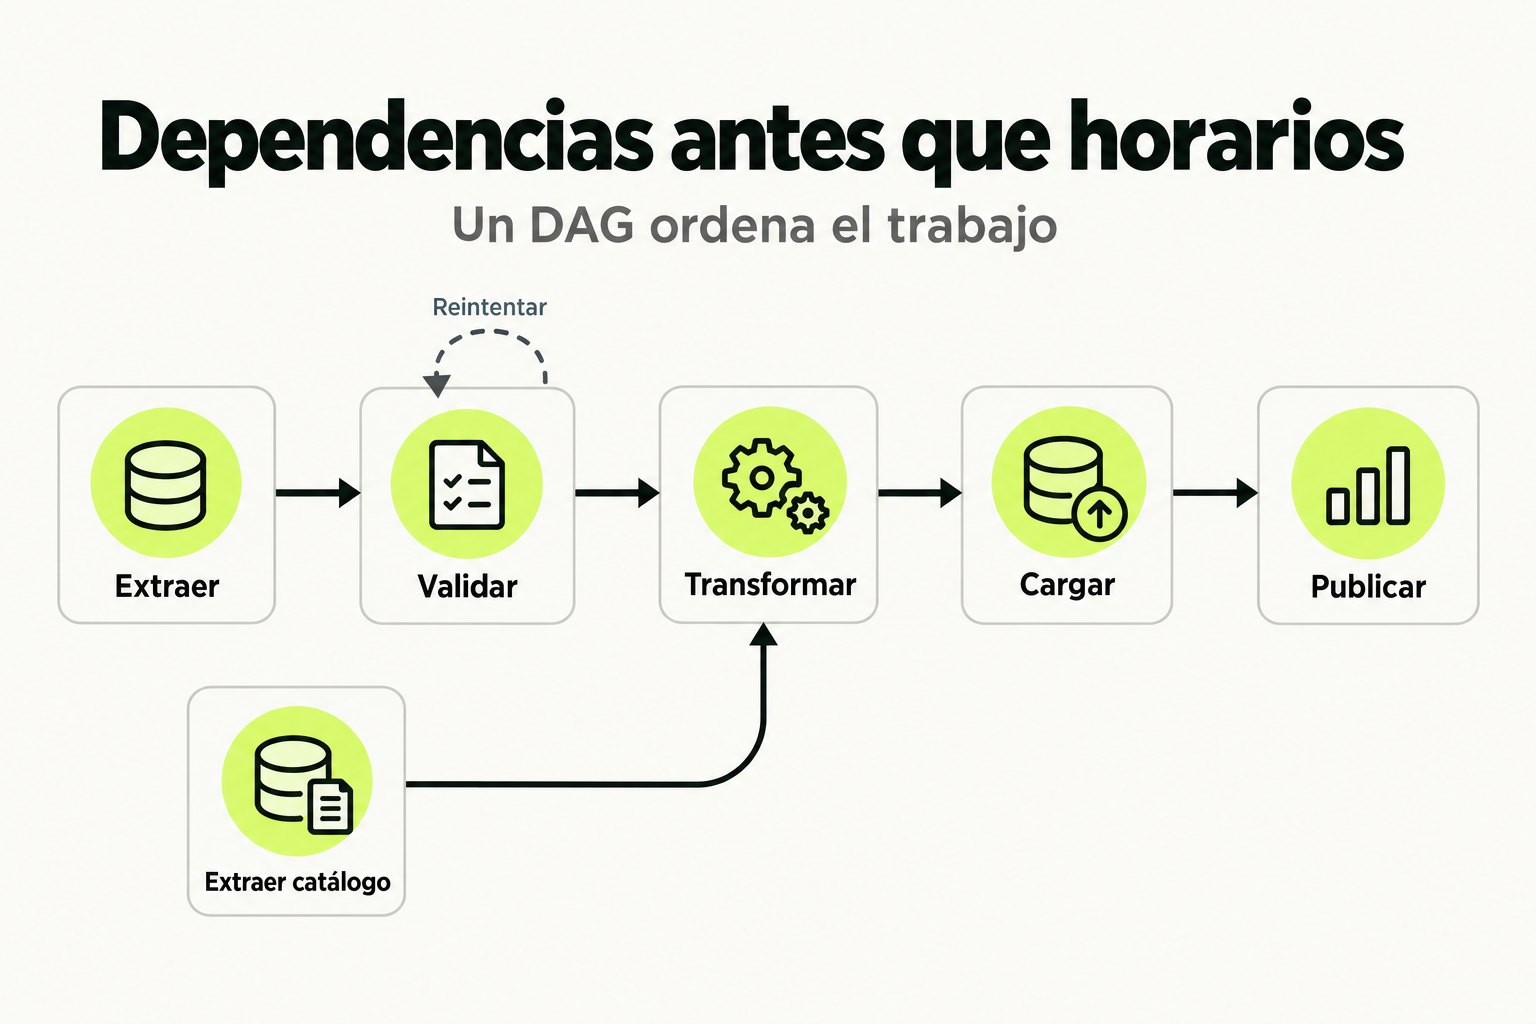
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Concepto clave
En pipelines ETL complejos, los flujos de trabajo rara vez son lineales. A menudo necesitas ramificaciones para manejar diferentes escenarios de datos y mecanismos de fallback para garantizar la resiliencia del sistema. Imagina una cadena de montaje en una fabrica: cuando un producto llega a un punto de decision, puede seguir diferentes lineas segun su tipo, pero siempre hay una ruta alternativa si la principal falla.
En Apache Airflow, esto se implementa mediante operadores como BranchPythonOperator que decide que camino seguir, combinado con trigger rules que controlan como se ejecutan las tareas dependiendo del estado de sus predecesoras. El fallback es como tener un plan B automatizado: si una tarea critica falla, el sistema automaticamente ejecuta una alternativa sin detener todo el pipeline.
Como funciona en la practica
Vamos a construir un ejemplo paso a paso. Supongamos que procesamos datos de ventas que pueden venir en tres formatos: CSV, JSON o XML. Nuestro DAG debe:
- Detectar el formato del archivo de entrada
- Ramificar a la ruta de procesamiento correspondiente
- Tener un procesamiento de fallback si ningun formato es reconocido
- Unificar los resultados
Primero, definimos la funcion de ramificacion:
def decide_ruta(**context):
    file_path = context['ti'].xcom_pull(task_ids='detectar_formato')
    if file_path.endswith('.csv'):
        return 'procesar_csv'
    elif file_path.endswith('.json'):
        return 'procesar_json'
    elif file_path.endswith('.xml'):
        return 'procesar_xml'
    else:
        return 'formato_desconocido'
Luego configuramos las trigger rules. Para la tarea de fallback, usamos trigger_rule='all_failed' para que solo se ejecute si todas las ramas principales fallan.
Caso de estudio
Una empresa de e-commerce procesa diariamente 1TB de datos de clics. El pipeline debe:
| Escenario | Ruta principal | Fallback |
|---|---|---|
| Datos completos y validos | Procesamiento completo con machine learning | N/A |
| Datos incompletos (>80%) | Procesamiento basico sin ML | Alertar al equipo |
| Datos corruptos o faltantes | Usar datos del dia anterior | Generar reporte de error |
El DAG implementado tiene esta estructura:
detectar_calidad -> [calidad_alta, calidad_media, calidad_baja]
calidad_alta -> procesamiento_completo
calidad_media -> procesamiento_basico -> alertar_equipo
calidad_baja -> usar_datos_anteriores -> generar_reporte
[procesamiento_completo, procesamiento_basico, usar_datos_anteriores] -> consolidar_resultados
La tarea alertar_equipo tiene trigger_rule='one_success' para ejecutarse si calidad_media tiene exito, mientras que generar_reporte tiene trigger_rule='all_done' para ejecutarse siempre.
Errores comunes
- Olvidar trigger rules personalizadas: Por defecto, las tareas esperan que todas sus predecesoras tengan exito. Si no configuras trigger_rule='none_failed' o similar en las rutas de consolidacion, el DAG se quedara atascado cuando una rama falle.
- Dependencias circulares: Crear ramas que eventualmente dependen de si mismas, causando loops infinitos. Siempre valida que cada camino tenga un final claro.
- Manejo inadecuado de XCom: Las ramas pueden necesitar compartir datos. Usa XCom con keys especificas para evitar contaminacion cruzada entre rutas paralelas.
- Falta de monitoreo de ramas inactivas: Si una rama nunca se ejecuta porque la condicion nunca se cumple, podrias perder datos. Implementa logging y metricas para cada posible camino.
- Fallback que falla: El mecanismo de respaldo debe ser extremadamente simple y confiable. Si tu fallback es tan complejo como la ruta principal, estas duplicando puntos de falla.
Checklist de dominio
- Puedo diseñar un DAG con al menos tres ramas condicionales usando BranchPythonOperator
- Se configurar trigger rules diferentes para tareas de consolidacion, alertas y fallback
- Implemento mecanismos de fallback que se activan automaticamente cuando las rutas principales fallan
- Uso XCom de forma segura para compartir datos entre ramas paralelas
- Incluyo logging diferenciado para cada rama del DAG
- Valido que no existan dependencias circulares en el grafo de tareas
- Documento claramente todas las posibles rutas de ejecucion y sus condiciones
Construye un DAG para procesamiento de datos meteorologicos con ramificaciones y fallback
Objetivo: Crear un DAG que procese datos meteorologicos de diferentes fuentes con mecanismos de resiliencia.
Contexto: Tu empresa recibe datos de tres APIs meteorologicas diferentes. Cada dia debes:
- Intentar obtener datos de la API primaria (OpenWeatherMap)
- Si falla, intentar con la API secundaria (WeatherAPI)
- Si ambas fallan, usar datos historicos locales como fallback
- Procesar los datos obtenidos segun su formato (JSON o XML)
- Almacenar resultados en una base de datos
Pasos:
- Crea un DAG llamado 'procesamiento_meteorologico' con schedule_interval diario
- Implementa una tarea inicial 'obtener_datos_api_primaria' que simule llamar a una API (puedes usar PythonOperator con una funcion que a veces falle aleatoriamente)
- Crea un BranchPythonOperator 'decidir_fuente_datos' que:
- Si la API primaria tuvo exito: continuar con 'procesar_datos_primarios'
- Si fallo: ejecutar 'obtener_datos_api_secundaria'
- Si ambas APIs fallaron: ejecutar 'usar_datos_historicos'
- Configura las trigger rules para que 'procesar_datos' se ejecute cuando cualquier fuente tenga exito (trigger_rule='one_success')
- Agrega una rama adicional: si los datos son JSON, procesarlos con transformaciones complejas; si son XML, procesarlos con transformaciones basicas
- Implementa alertas: si se usan datos historicos, enviar una notificacion (simulada) al equipo
- Prueba tu DAG con diferentes escenarios de fallo
Pistas
- Usa un diccionario en XCom para pasar el estado de cada API y el formato de datos entre tareas
- Para simular fallos aleatorios, usa random.randint(0,1) en tus funciones y maneja las excepciones apropiadamente
- Considera usar ShortCircuitOperator como alternativa a BranchPythonOperator para algunas decisiones simples
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.