

Python para Data Science
Domina Python para analisis de datos. Aprende NumPy, Pandas, visualizacion y estadistica para convertirte en un cientifico de datos. Es un curso en español con 4 módulos y 14 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 132 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Representar datos pequeños con estructuras nativas y funciones reutilizables.
- Aplicar operaciones vectorizadas, máscaras, cambios de forma y estadísticas básicas con NumPy.
- Inspeccionar, limpiar, transformar, agregar y combinar DataFrames conservando trazabilidad.
- Elegir y rotular visualizaciones que comuniquen únicamente patrones observables.
Este curso recorre un flujo completo de análisis reproducible con Python: parte de estructuras básicas y termina con gráficos que permiten comunicar resultados verificables. La ruta no consiste en memorizar funciones aisladas, sino en conservar la relación entre datos, transformación, cálculo y decisión. Primero trabajarás con listas, tuplas, conjuntos y diccionarios para representar colecciones pequeñas y preparar registros. Después definirás funciones que encapsulen reglas, reduzcan repeticiones y hagan explícitos los supuestos de un cálculo. El quiz de fundamentos comprobará si puedes leer expresiones, seleccionar la estructura adecuada y anticipar una salida antes de ejecutar el código.
El segundo módulo introduce NumPy como una forma de organizar valores homogéneos en arrays. Aprenderás a leer shape, ndim, size y dtype, y a distinguir una operación elemento a elemento de una operación por eje. Las operaciones vectorizadas y el broadcasting te permitirán calcular diferencias, totales y medias sin bucles innecesarios. En la lección práctica usarás máscaras booleanas, reshape, concatenación y estandarización. La decisión importante será comprobar dimensiones, unidades y condiciones antes de aceptar un resultado.
El tercer módulo convierte esos principios en trabajo tabular con Pandas. Un DataFrame representa observaciones y columnas con significado; por eso la inspección inicial, los tipos y los valores ausentes importan tanto como la sintaxis. En limpieza aprenderás a normalizar texto, convertir números sin transformar un dato desconocido en cero y registrar qué queda pendiente. Luego filtrarás, ordenarás, crearás columnas, agruparás y resumirás registros. Al combinar DataFrames distinguirás entre apilar filas y relacionar tablas mediante una clave. La comprobación de cardinalidad evitará duplicaciones silenciosas y totales inflados.
El último módulo aborda la visualización como una decisión analítica. Matplotlib ofrece control directo sobre figuras, ejes, escalas, etiquetas y exportación. Seaborn facilita comparaciones estadísticas mediante distribuciones, relaciones y categorías, pero no sustituye la lectura de los datos. La interfaz de gráficos de Pandas permite producir una figura rápida desde una tabla, siempre que elijas el tipo adecuado y revises el orden de las categorías. En todas las lecciones se trabajará con datos pequeños y completos para que cada cifra pueda reproducirse.
El trabajo final consistirá en un informe local sobre pedidos de una tienda ficticia. Recibirás una tabla de pedidos, otra de productos y una tabla de fechas; deberás inspeccionar tipos, conservar ausencias justificadas, unir las tablas sin perder ni duplicar pedidos, calcular ingresos por categoría y periodo, y producir dos visualizaciones complementarias. Una gráfica mostrará evolución temporal y otra comparará distribuciones o categorías. El informe incluirá el código, una tabla resumen, las decisiones de limpieza y dos conclusiones limitadas a lo observado.
Para comprobar el aprendizaje no bastará con que el programa se ejecute. Deberás mostrar filas de entrada, forma de los DataFrames, conteos antes y después de las transformaciones, fórmulas y salidas esperadas. Repetir la ejecución desde cero servirá para revisar reproducibilidad. También comprobarás que las unidades son coherentes, que una suma coincide con sus componentes y que cada gráfico tiene título, ejes y etiquetas suficientes. El criterio central será poder explicar qué representa cada fila, qué cambió en cada paso y qué afirmación está respaldada por los datos.
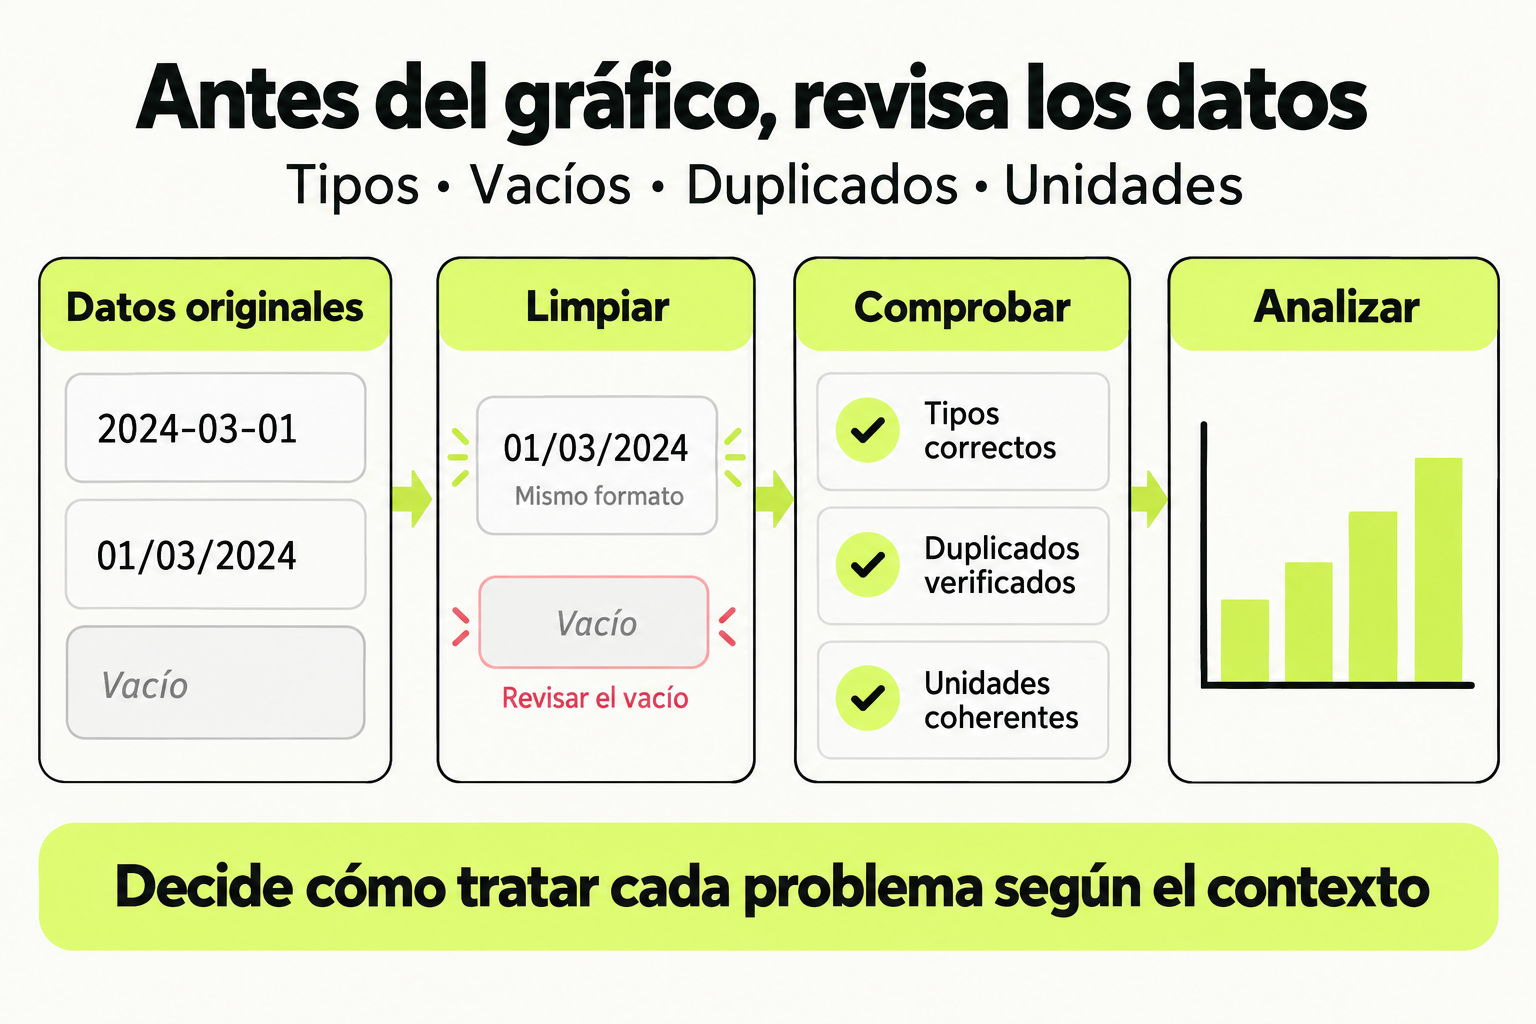
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Proyecto final
Informe reproducible de pedidos ficticios
Construye un análisis local a partir de tres tablas ficticias relacionadas: pedidos, productos y calendario. Documenta la inspección, las decisiones de limpieza, la unión por claves, los cálculos agregados y dos gráficos que respondan preguntas concretas sobre ingresos y comportamiento temporal. Datos completos para iniciar: pedidos (pedido_id, producto_id, fecha, unidades) = (101,A,2026-03-01,2), (102,B,2026-03-02,1), (103,A,2026-04-01,3); productos (producto_id,categoria,precio) = (A,libro,5), (B,juego,8); calendario (fecha,mes) = (2026-03-01,2026-03), (2026-03-02,2026-03), (2026-04-01,2026-04). Define los precios en una misma moneda ficticia. Cada pedido contiene una línea en este fixture. Los joins many-to-one con productos y calendario conservan tres filas; ingreso total = 33, libro = 25, juego = 8, marzo = 18 y abril = 15. Añade luego una fila de precio ausente en una copia de prueba y documenta el rechazo o estado pendiente, sin convertirla en cero.
Qué entregar
- Un script o notebook ejecutable desde cero.
- Una tabla resumen de ingresos por categoría y mes.
- Dos gráficos exportados con títulos, unidades, ejes y leyendas cuando correspondan.
- Una breve sección de decisiones, ausencias detectadas y comprobaciones aritméticas.
Cómo comprobarlo
- Las filas y claves se conservan o se descartan con una razón explícita.
- Los totales se pueden reproducir a partir de los registros entregados.
- Las transformaciones no convierten ausencias desconocidas en valores inventados.
- Cada gráfico responde una pregunta concreta y no atribuye causalidad no demostrada.
- El análisis se ejecuta sin depender de pasos manuales ocultos.
Temario completo
14 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos de Python
- Por qué Python para Data Science?
- Estructuras de datos en Python
- Funciones y Lambda
- Quiz: Fundamentos de Python
NumPy: Computación Numérica
- Introducción a NumPy
- Operaciones con NumPy
- NumPy en la práctica
Pandas: Manipulación de Datos
- Introducción a Pandas
- Limpieza de datos
- Transformación y agregación
- Combinando DataFrames
Visualización de Datos
- Matplotlib: Fundamentos
- Seaborn: Gráficos estadísticos
- Visualización con Pandas
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Python para Data Science?
Puedes adquirir el curso Python para Data Science con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Python para Data Science?
Es un curso completo en español con 4 módulos y 14 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Python para Data Science?
Revisa el temario público para comprobar el punto de partida y la progresión de Python para Data Science. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Python para Data Science entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Qué formato tiene el curso?
El formato actual es lectura y práctica. Consulta las lecciones y sus recursos; no se ofrece como un curso completo de video.
¿Puedo revisar el programa antes de pagar?
Sí. El temario y esta ficha son públicos. Compara el contenido y los requisitos con tu objetivo antes de elegir una compra individual o un acceso a toda la escuela en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Otros cursos de IA
Ver todo el catálogo →- Análisis de Datos con Google Sheets y SQLDomina las herramientas esenciales para analizar datos. Aprende a manipular hojas de cálculo en Google Sheets y a realizar consultas SQL para extraer información valiosa de bases de datos.
- Apache Airflow para ETL: Integraciones y Pipelines en Tiempo RealCurso práctico para data engineers que desean dominar Apache Airflow en la automatización de pipelines ETL. Aprenderás a diseñar, implementar y monitorear DAGs robustos para flujos de trabajo complejos, integrando herramientas como Python, SQL y bases de datos. Al finalizar, serás capaz de construir pipelines escalables y.
- Apache Airflow: Construcción de Pipelines ETL Automatizados con DAGsCurso práctico para data engineers que desean dominar Apache Airflow en la orquestación de pipelines ETL complejos. Aprenderás a diseñar, programar y monitorear DAGs robustos, integrando herramientas como Python, bases de datos y APIs. Al finalizar, serás capaz de automatizar flujos de datos escalables en entornos productivos.
- Apache Airflow: Orquestación de Pipelines ETL Complejos con DAGsCurso práctico para data engineers que desean dominar Apache Airflow en la automatización de pipelines ETL. Aprenderás a diseñar, programar y monitorear DAGs complejos, integrando múltiples fuentes de datos y herramientas. Al finalizar, serás capaz de implementar soluciones robustas de orquestación en entornos productivos.