

Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Curso avanzado para ingenieros de ML que desean dominar técnicas de ajuste fino de modelos de lenguaje con aprendizaje por refuerzo. Aprenderás a implementar RLHF y DPO en modelos open-source, optimizando respuestas con retroalimentación humana y preferencias. Al finalizar, podrás desplegar modelos ajustados para aplicaciones. Es un curso en español con 4 módulos y 19 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 131 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Distinguir las etapas, componentes y señales de RLHF y DPO.
- Construir y validar registros de preferencias sin mezclar particiones ni introducir pares incompatibles.
- Explicar y calcular operaciones básicas de recompensa, PPO y pérdida DPO con datos pequeños.
- Diseñar una evaluación separada que combine calidad, alineamiento, seguridad y desviación respecto del modelo base.
- Documentar y exponer un pipeline local con una interfaz FastAPI validada.
Este curso sigue el recorrido completo desde una preferencia humana hasta un servicio evaluable que responde de forma controlada. El escenario de trabajo será un asistente interno que redacta respuestas breves para solicitudes de soporte técnico. No se busca que produzca textos llamativos, sino que respete instrucciones, distinga hechos de suposiciones y mantenga un formato verificable. Todas las comparaciones se realizarán con datos locales o simulados, sin presentar resultados como evidencia de producción.
En el primer módulo se construye el vocabulario necesario. Se separan modelo base, política, modelo de recompensa, referencia, respuesta elegida y respuesta rechazada. Después se prepara un entorno reproducible y se revisan los campos que necesita cada método. La preparación de datos será una decisión central: un par de preferencias debe compartir el mismo prompt, conservar el contexto relevante y expresar una diferencia comprensible. También se practicará la carga y validación de registros pequeños antes de escalar.
El segundo módulo estudia RLHF como una cadena de decisiones. Primero se define qué conducta se desea medir; luego se entrena un modelo de recompensa con comparaciones y finalmente se optimiza la política mediante PPO. La atención estará en la relación entre recompensa, divergencia respecto de la política de referencia, tamaño de actualización y evaluación independiente. Los ejercicios usarán tablas pequeñas para calcular preferencias, ventajas y cambios de política sin ocultar los datos de entrada. El mini-proyecto exigirá justificar una métrica y reconocer cuándo una recompensa aparentemente alta refleja un atajo.
El tercer módulo presenta DPO como una alternativa que aprende directamente de pares preferidos y rechazados. Se analizará el papel de los logaritmos de probabilidad, el modelo de referencia y el parámetro beta. La implementación se dividirá en operaciones comprobables: enmascarar padding, sumar log-probabilidades de tokens válidos y formar la diferencia entre ambas respuestas. Después se compararán RLHF y DPO con una matriz de criterios: cantidad de componentes, facilidad de diagnóstico, sensibilidad a datos ruidosos, coste experimental y control de desviación. El ejercicio práctico mantendrá separado un conjunto de validación para no confundir entrenamiento con evidencia.
El proyecto integrador une selección, pipeline, evaluación y exposición. La selección del modelo se justificará mediante memoria disponible, longitud de contexto, licencia conocida en el material entregado y ajuste al idioma del caso. El pipeline deberá registrar versiones de datos, particiones, hiperparámetros y decisiones de exclusión. La evaluación combinará exactitud de formato, utilidad revisada por personas, tasa de respuestas inseguras y distancia frente al modelo base. Ninguna métrica aislada será suficiente.
La última parte convierte el resultado en una interfaz local con FastAPI. Se definirá un contrato de entrada y salida, validación de campos, carga única del modelo y manejo explícito de errores. La presentación final mostrará una línea base, el método elegido, ejemplos antes y después, una tabla de evaluación y limitaciones. Para comprobar el aprendizaje, otra persona deberá poder reproducir los cálculos, ejecutar el conjunto de pruebas y explicar por qué una mejora numérica no demuestra por sí sola alineamiento. El producto final será, por tanto, un experimento documentado y auditable, no una promesa de rendimiento universal.
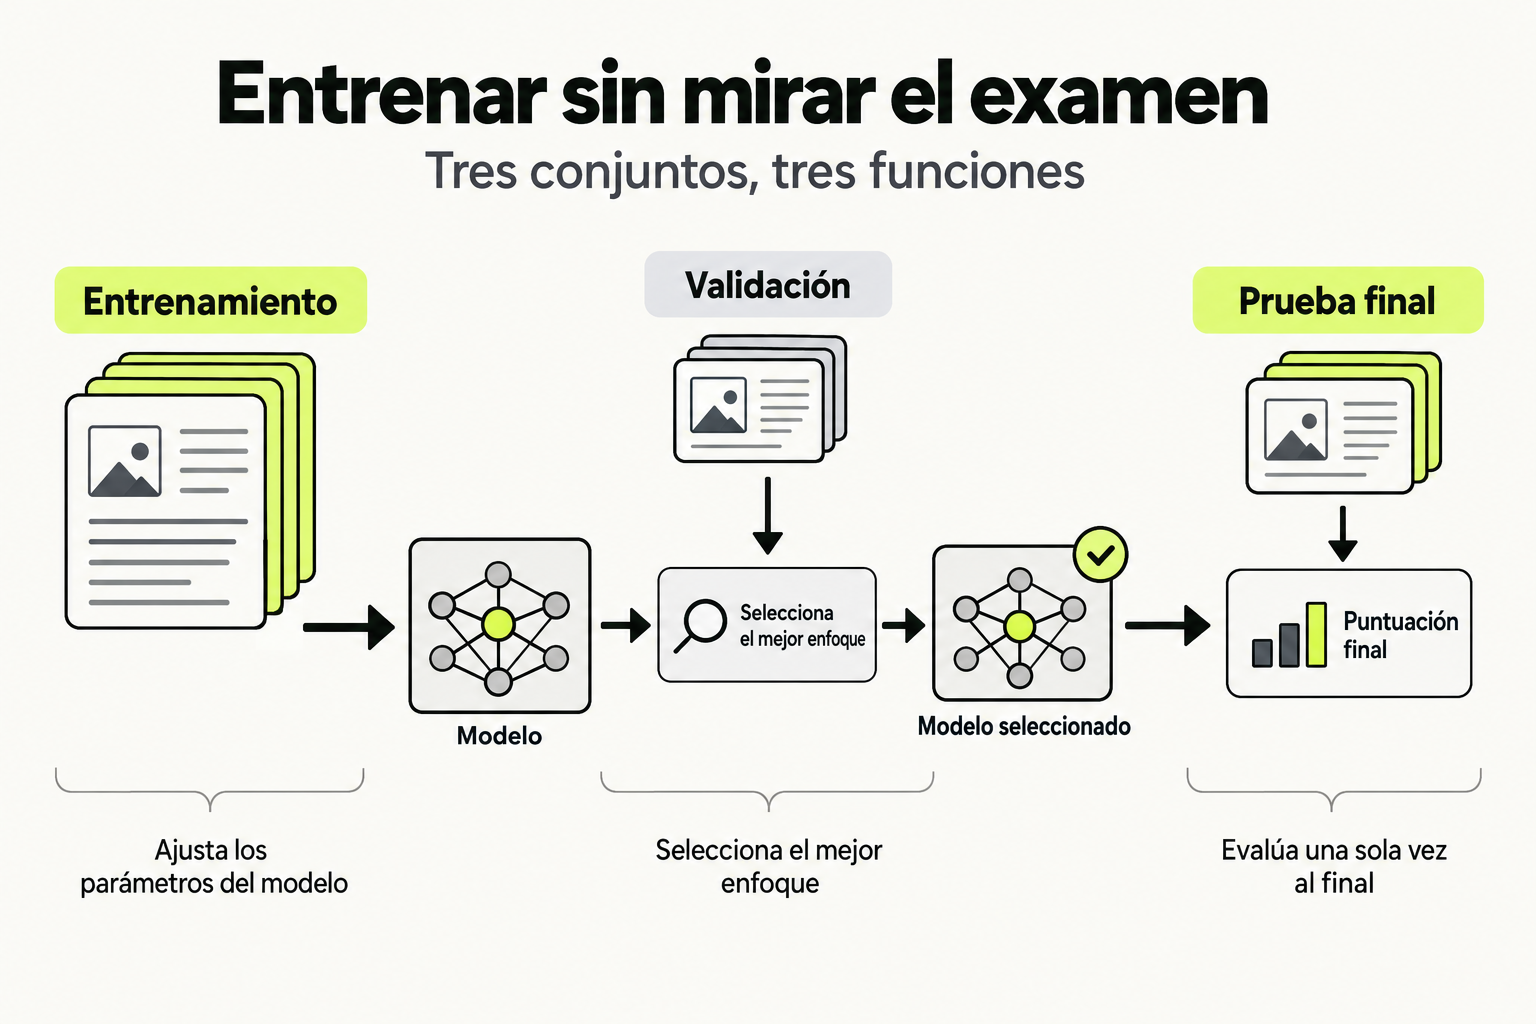
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Proyecto final
Asistente de soporte con preferencias auditables
Construye un experimento local que compare un modelo base con una variante ajustada mediante RLHF simulado o DPO. El asistente debe responder a solicitudes de soporte técnico con formato consistente, reconocer información ausente y evitar inventar soluciones. Documenta las decisiones sobre datos, método, evaluación y límites.
Qué entregar
- Dataset versionado con prompts, respuestas preferidas y rechazadas, particiones y validaciones.
- Pipeline reproducible de RLHF o DPO con configuración y registros de ejecución.
- Informe comparativo con línea base, métricas, ejemplos cualitativos y análisis de errores.
- API local con contrato de entrada, salida y errores, además de una prueba automatizada mínima.
- Presentación breve que explique decisiones, resultados reproducibles y limitaciones.
Cómo comprobarlo
- Todos los pares comparten prompt y la preferencia está justificada por un criterio observable.
- Los cálculos y métricas pueden reproducirse a partir de los datos entregados.
- La evaluación usa ejemplos no vistos durante el ajuste y reporta calidad, seguridad y formato.
- El pipeline conserva la referencia y evita afirmar causalidad a partir de una sola métrica.
- La API valida entradas, carga el modelo una vez y comunica fallos sin ocultarlos.
Temario completo
19 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos de RLHF y preparación del entorno
- Introducción a RLHF y DPO: conceptos clave y diferencias
- Configuración del entorno con Hugging Face y bibliotecas esenciales
- Preparación de datasets para retroalimentación y preferencias
- Ejercicio práctico: Carga y preprocesamiento de un dataset de ejemplo
Implementación de RLHF: desde la política hasta la recompensa
- Diseño de la política y el modelo de recompensa en RLHF
- Implementación del algoritmo PPO para optimización
- Entrenamiento y evaluación del modelo con RLHF
- Mini-proyecto: Ajuste fino de un modelo pequeño con RLHF
- Quiz: Evaluación de conceptos de RLHF
Dominando DPO: optimización directa de preferencias
- Teoría de DPO: ventajas y aplicaciones prácticas
- Implementación de DPO con PyTorch y Transformers
- Comparación de RLHF vs DPO: rendimiento y complejidad
- Ejercicio práctico: Ajuste de un modelo con DPO en un dataset real
- Quiz: Diferencias clave entre RLHF y DPO
Proyecto integrador: Sistema completo de fine-tuning con evaluación
- Selección del modelo y dataset para el proyecto
- Implementación del pipeline de fine-tuning (RLHF o DPO)
- Evaluación del modelo con métricas de alineamiento y calidad
- Despliegue del modelo ajustado como API con FastAPI
- Presentación del proyecto y lecciones aprendidas
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica?
Puedes adquirir el curso Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica?
Es un curso completo en español con 4 módulos y 19 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica?
Revisa el temario público para comprobar el punto de partida y la progresión de Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Cuánto tiempo necesito y qué nivel requiere Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica?
Revisa el temario público para comprobar el punto de partida: cada curso indica sus lecciones y su progresión. Con 15 a 30 minutos al día avanzas, a tu ritmo y con el progreso guardado. Si vienes desde cero, empieza por ChatGPT para Principiantes, incluido en la matrícula.
¿Qué pasa si el curso no es para mí?
Puedes revisar el temario, las lecciones y el precio antes de pagar. El cargo inicial de la matrícula tiene 7 días de garantía según la política publicada, y cancelar evita la próxima renovación; la compra individual es un pago único que no se renueva. Si hubo un cobro incorrecto o un problema de acceso, soporte revisa el caso. Tienes 7 días de garantía en tu primer pago.
¿Puedo ver el curso antes de decidir?
Sí. Revisa el temario y el tráiler en esta página. Para estudiar, la matrícula mensual cuesta US$15 y la cancelas cuando quieras; compárala con el curso individual en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Tu ruta: desde cero → intermedio → avanzado
Este curso es un paso, no toda la ruta. Sigue este orden: cada nivel usa lo que dominaste en el anterior.
Nivel 1 · Desde cero
Nivel 2 · Intermedio
Nivel 3 · Avanzado
Otros cursos de IA
Ver todo el catálogo →- ChatGPT para AbogadosOcho clases para organizar investigación, borradores y comunicación jurídica con datos sintéticos, trazabilidad y revisión profesional.
- ChatGPT para Atención al ClienteDiseña respuestas, macros y análisis de conversaciones sin perder empatía ni control de políticas.
- ChatGPT para Crear ContenidoCurso práctico de ocho clases para pasar de una idea a contenidos claros, visuales, coherentes y medibles.
- ChatGPT para DocentesOcho clases para diseñar actividades, diferenciar explicaciones y evaluar con transparencia sin sustituir el juicio docente.