

Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Aprende a containerizar tus flujos de Machine Learning con Docker y desplegarlos en Kubernetes para producción. Este curso práctico te guiará desde la creación de imágenes personalizadas hasta la orquestación de servicios escalables, optimizado para científicos de datos. Es un curso en español con 4 módulos y 20 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 131 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Construir imágenes reproducibles para pequeños componentes de ML y ejecutar procesos sin depender del entorno del host.
- Relacionar Pods, Services, Deployments, volúmenes y HPA mediante manifiestos verificables.
- Diseñar pipelines con contratos de datos, persistencia explícita, validación de modelos y códigos de salida.
- Separar entrenamiento e inferencia en una arquitectura de recomendación comprobable.
- Diagnosticar fallos mediante entradas, salidas, eventos, logs y cálculos reproducibles.
Este curso aborda un problema concreto: un equipo de datos ha entrenado un modelo de recomendación y necesita llevarlo desde un entorno reproducible de desarrollo hasta un servicio supervisable en Kubernetes. La ruta no empieza por crear muchos Pods, sino por entender qué debe permanecer estable: código, dependencias, configuración, artefactos del modelo, entradas y criterios de evaluación.
En el primer módulo construirás una base operativa con Docker. Distinguirás una imagen inmutable de un contenedor en ejecución y relacionarás esa diferencia con la reproducibilidad de un experimento de ML. Después revisarás la configuración local y crearás un Dockerfile pequeño para un modelo de scikit-learn. La práctica de preprocesamiento te obligará a separar datos de código, observar qué permanece al detener un contenedor y qué desaparece al eliminarlo y documentar una ejecución repetible. El cuestionario final comprobará si sabes elegir entre imagen, contenedor, volumen, puerto y proceso.
El segundo módulo introduce Kubernetes como un sistema de estado deseado. Relacionarás Pods, Services y Deployments mediante etiquetas, puertos y réplicas, en vez de tratarlos como comandos aislados. Prepararás un clúster local para probar manifiestos sin presentar esa prueba como producción. Luego desplegarás una API de inferencia y analizarás sus fallos con estados, eventos y registros. La práctica de HPA añadirá una decisión importante: CPU o memoria son señales indirectas de demanda, por lo que el escalado debe validarse con carga controlada y límites explícitos.
El tercer módulo conecta tareas de ML que suelen confundirse. Diseñarás un pipeline donde preprocesamiento, entrenamiento y evaluación intercambian archivos definidos, códigos de salida y metadatos. Estudiarás la persistencia para decidir qué debe sobrevivir al ciclo de vida de un Pod y qué debe regenerarse. En CI/CD, la calidad no se reduce a que una imagen compile: también tendrás que rechazar un modelo cuya métrica de validación sea insuficiente. La práctica end-to-end separa una prueba local comprobable de un Job de Kubernetes que todavía debe ejecutarse en un entorno autorizado.
El proyecto integrador se centra en un sistema de recomendación sencillo, con entrenamiento separado de inferencia. Definirás el contrato de entrada, la respuesta, el modelo de fallos, los recursos y la política de actualización. La arquitectura deberá explicar dónde viven los datos, cómo se identifica una versión del modelo y cómo se evita que una réplica sirva artefactos incompatibles. No se evaluará la sofisticación del algoritmo, sino la trazabilidad entre decisión, configuración y evidencia.
El trabajo final consistirá en un prototipo local y manifiestos revisables para un servicio que reciba un identificador de usuario y devuelva una lista determinista de recomendaciones a partir de un artefacto preparado. Entregarás la imagen, un registro de ejecución, los manifiestos, una prueba de salud, una prueba funcional y un pequeño informe de límites. También indicarás qué partes se ejecutaron realmente y cuáles quedan pendientes de comprobar.
Comprobarás el aprendizaje reproduciendo comandos en un entorno local, comparando entradas y salidas, inspeccionando logs, verificando selectores y calculando métricas con datos visibles. Una entrega sólida podrá explicar por qué un volumen no sustituye a una estrategia de versionado, por qué un HPA no demuestra por sí solo buena latencia y cómo revertir una imagen sin borrar evidencias. El criterio central será que otra persona pueda repetir el recorrido y localizar un fallo sin depender de suposiciones ocultas.
La ampliación proporciona entradas concretas, cálculos y contratos de laboratorio. Distingue las declaraciones de Kubernetes de las réplicas listas observadas, el puerto del Service del puerto de escucha, y el archivo de un artefacto de un modelo realmente entrenado. Las comprobaciones editoriales validan sintaxis y aritmética; construir imágenes, ejecutar inferencia o levantar el clúster forman parte de la práctica y requieren evidencias propias.
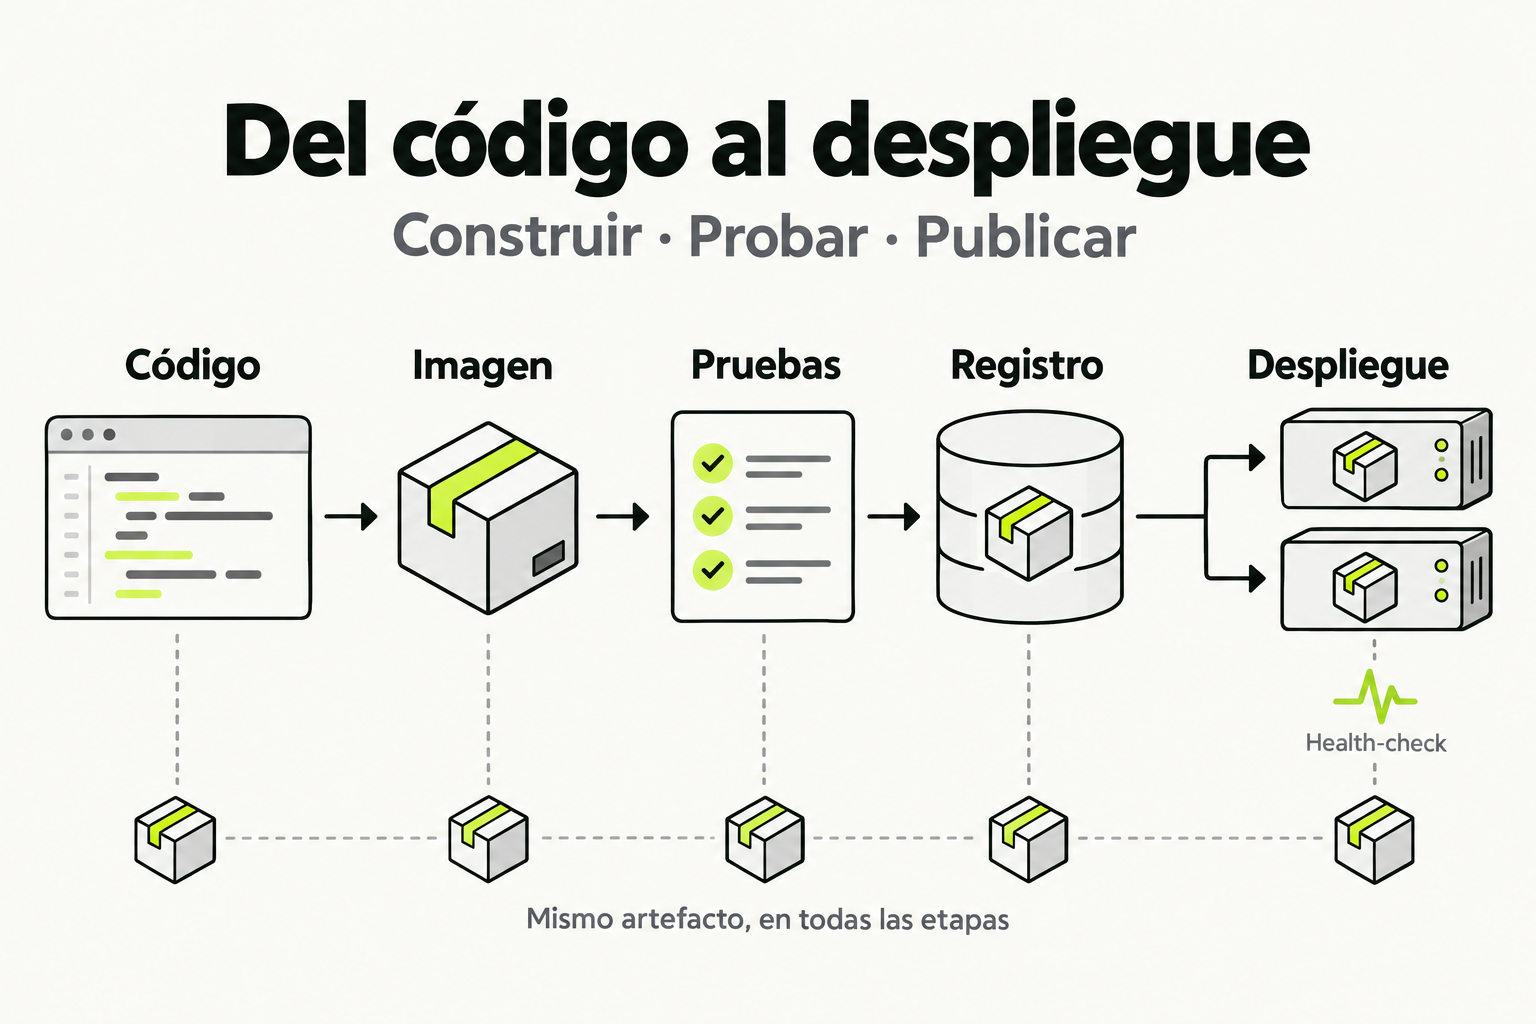
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Proyecto final
Servicio reproducible de recomendaciones en un clúster local
Diseña un prototipo que entrene o cargue un modelo sencillo de recomendaciones y exponga una inferencia determinista. Empaqueta la aplicación, sepárala del artefacto de datos, despliega réplicas en Kubernetes y documenta las comprobaciones realizadas y los límites del experimento.
Qué entregar
- Dockerfile, código de inferencia, dependencias fijadas y .dockerignore.
- Datos sintéticos, artefacto de modelo versionado y registro de una ejecución local.
- Manifiestos de Deployment, Service, configuración de recursos y comprobaciones de salud.
- Pruebas de entrada y salida, logs relevantes y breve informe de decisiones, fallos y pendientes.
Cómo comprobarlo
- La imagen se construye con un contexto mínimo y la aplicación devuelve resultados reproducibles.
- Los selectores, puertos, réplicas, recursos y sondas coinciden con el contrato de la aplicación.
- El pipeline distingue datos efímeros de artefactos persistentes y valida una métrica con registros visibles.
- La entrega identifica qué se ejecutó realmente, permite repetir las pruebas y no incluye credenciales ni datos personales.
Fuentes para profundizar
- Dockerfile ↗
- Docker: volúmenes ↗
- Kubernetes: EndpointSlices ↗
- Kubernetes: sondas ↗
- Kubernetes: HPA ↗
- Kubernetes: persistencia ↗
- Kubernetes: Jobs ↗
- kind: laboratorio ↗
- Minikube: imágenes ↗
- Helm: plantillas ↗
- Prometheus: configuración ↗
- Scikit-learn: persistencia ↗
- Scikit-learn: DecisionTreeClassifier ↗
- Flask: referencia ↗
- GitHub: artifacts ↗
Temario completo
20 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos de Docker para Científicos de Datos
- Introducción a Containers y su Impacto en ML
- Instalación y Configuración de Docker en tu Máquina
- Crear un Dockerfile para un Modelo de Scikit-learn
- Práctica: Containeriza un Pipeline de Preprocesamiento
- Quiz: Conceptos Básicos de Docker
Orquestación con Kubernetes para Despliegue de Modelos
- Conceptos Clave de Kubernetes: Pods, Services y Deployments
- Configurar un Cluster Local con Minikube o Kind
- Desplegar tu Primer Modelo en Kubernetes
- Práctica: Escalar un Servicio de Inferencia con HPA
- Quiz: Fundamentos de Kubernetes
Integración de ML Pipelines con Docker y Kubernetes
- Diseñar un Pipeline de ML con Containers
- Usar Volumes para Persistencia de Datos y Modelos
- Automatizar Despliegues con CI/CD para ML
- Práctica: Crear un Pipeline End-to-end con Airflow y Kubernetes
- Quiz: Integración de Pipelines
Proyecto Integrador: Sistema de Recomendación en Producción
- Definir el Modelo y Arquitectura del Sistema
- Containerizar el Modelo y sus Dependencias
- Desplegar y Configurar en Kubernetes con Helm
- Práctica: Implementar Monitorización y Logs con Prometheus
- Quiz: Evaluación del Proyecto Integrador
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Containerización y Despliegue de Modelos de ML con Docker y Kubernetes?
Puedes adquirir el curso Containerización y Despliegue de Modelos de ML con Docker y Kubernetes con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Containerización y Despliegue de Modelos de ML con Docker y Kubernetes?
Es un curso completo en español con 4 módulos y 20 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Containerización y Despliegue de Modelos de ML con Docker y Kubernetes?
Revisa el temario público para comprobar el punto de partida y la progresión de Containerización y Despliegue de Modelos de ML con Docker y Kubernetes. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Containerización y Despliegue de Modelos de ML con Docker y Kubernetes entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Qué formato tiene el curso?
El formato actual es lectura y práctica. Consulta las lecciones y sus recursos; no se ofrece como un curso completo de video.
¿Puedo revisar el programa antes de pagar?
Sí. El temario y esta ficha son públicos. Compara el contenido y los requisitos con tu objetivo antes de elegir una compra individual o un acceso a toda la escuela en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Otros cursos de IA
Ver todo el catálogo →- Containerización y Despliegue de Modelos ML con Docker y KubernetesAprende a containerizar tus flujos de machine learning con Docker y desplegar modelos en producción usando Kubernetes. Este curso práctico te guiará desde los conceptos básicos hasta la implementación de pipelines escalables en entornos cloud.
- Docker para DesarrolladoresDomina Docker para optimizar tu flujo de desarrollo, crear entornos reproducibles y desplegar aplicaciones como un profesional. Aprende a containerizar aplicaciones, gestionar múltiples contenedores y aplicar mejores prácticas de la industria.
- Accesibilidad Web (WCAG)Aprende a crear sitios web accesibles para todas las personas. Estándares WCAG 2.2, herramientas de auditoría, HTML semántico, ARIA, contraste de colores y navegación por teclado.
- Arquitectura de Micro-frontends con Module Federation de WebpackEste curso avanzado te guiará en el diseño e implementación de arquitecturas de micro-frontends utilizando Module Federation de Webpack. Aprenderás a desplegar aplicaciones frontend distribuidas entre equipos, optimizando la colaboración y escalabilidad. Cada módulo incluye ejercicios prácticos para construir componentes.