

Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Curso práctico para ingenieros de datos que deseen implementar sistemas RAG utilizando bases de datos vectoriales. Aprenderás a diseñar, desarrollar y optimizar pipelines completos con Chroma, Pinecone y pgvector, enfocándote en casos reales de producción. Es un curso en español con 5 módulos y 25 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 131 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Diseñar un flujo RAG trazable desde la ingesta hasta la respuesta contextual.
- Calcular e interpretar similitud vectorial con datos pequeños y verificables.
- Implementar operaciones de almacenamiento, consulta y filtrado en Chroma, Pinecone y pgvector.
- Comparar alternativas mediante relevancia, latencia, persistencia y controles de integridad.
- Construir una evaluación reproducible que documente errores, límites y decisiones de despliegue.
Este curso aborda la construcción de un sistema RAG como una cadena de decisiones verificables, no como una simple demostración de búsqueda semántica. El escenario conductor es un portal interno de soporte técnico que debe responder sobre procedimientos de mantenimiento, conservar el origen de cada fragmento y permitir comparar una instalación local con alternativas escalables. Trabajarás con registros pequeños y reproducibles para distinguir los problemas de arquitectura de los problemas propios de una herramienta.
En el primer módulo seguirás el recorrido completo: documentos, fragmentación, embeddings, recuperación, contexto y respuesta. Aprenderás a identificar qué componente transforma el texto, cuál ordena candidatos y cuál redacta la salida. También calcularás similitudes con vectores reducidos para comprobar manualmente por qué un resultado aparece antes que otro. La configuración inicial convertirá esas ideas en un entorno aislado y repetible; el pipeline básico cerrará el módulo con una prueba que conserve texto, identificador y procedencia. El quiz servirá para detectar confusiones entre indexación y consulta, no para memorizar nombres.
El segundo módulo se concentra en Chroma como laboratorio local. Primero establecerás persistencia y una colección con metadatos claros. Después practicarás altas, lecturas, cambios y bajas sin perder la identidad de los documentos. Los filtros permitirán separar versiones, áreas o fechas, mientras las métricas ayudarán a interpretar distancias. El sistema RAG simple combinará recuperación y una respuesta acotada al contexto disponible. La evaluación de este tramo pedirá justificar decisiones con resultados observables, especialmente cuando una consulta no devuelve lo esperado.
El tercer módulo introduce Pinecone desde la perspectiva de una migración controlada. La prioridad será definir dimensión, métrica, identificadores y metadatos antes de cargar datos. Aprenderás a pensar en un índice como una frontera operativa: allí se combinan capacidad, latencia, mantenimiento y gasto. Las consultas avanzadas incorporarán filtros y una tabla de medición con latencia, cantidad recuperada y relevancia. La práctica de migración exigirá comparar una muestra origen-destino y documentar discrepancias antes de considerar que el traslado es correcto. El quiz final de este módulo evaluará escalabilidad sin convertir una cifra aislada en una garantía.
El cuarto módulo integra pgvector con PostgreSQL. Verás cómo una tabla relacional puede conservar texto, fuente, permisos y vector en una misma unidad lógica. Las consultas vectoriales se estudiarán junto con sus límites: dimensión fija, operadores de distancia, filtros SQL y necesidad de medir planes de ejecución. La optimización tratará índices y parámetros como compromisos entre exactitud y velocidad, no como valores universales. La práctica híbrida reunirá coincidencia semántica y condiciones estructuradas para resolver una consulta realista.
El proyecto integrador une los aprendizajes. Diseñarás una arquitectura con límites explícitos, prepararás un conjunto de evaluación, ejecutarás el mismo caso en capas de almacenamiento seleccionadas y registrarás resultados. La comprobación final incluirá trazabilidad de fuentes, consultas reproducibles, controles de filas y cálculos de métricas. Si los resultados difieren, la entrega deberá señalar si la causa probable está en los datos, el modelo de embedding, el filtro, la configuración o la medición. Así, terminarás con un sistema demostrable y con criterios para mantenerlo, no solo con una colección de fragmentos de código.
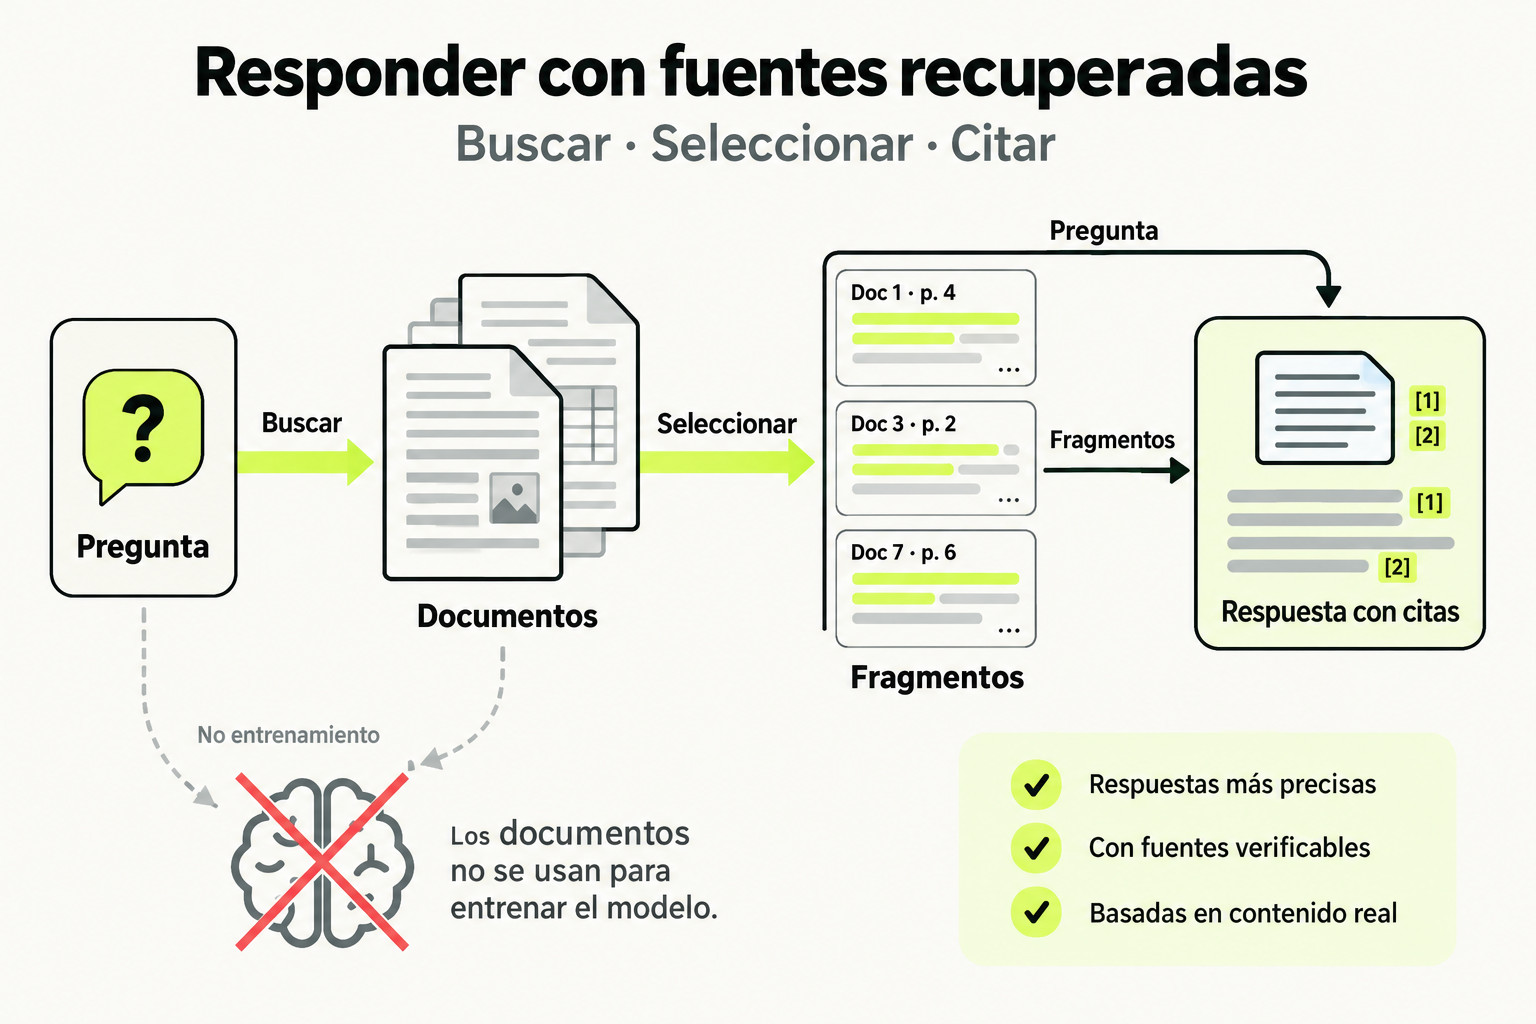
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Proyecto final
Sistema RAG trazable para soporte técnico
Construye un prototipo que reciba preguntas sobre cuatro procedimientos internos, recupere fragmentos pertinentes y devuelva una respuesta acompañada por sus identificadores de origen. Compara una implementación local con una opción vectorial o relacional, usando los mismos documentos y consultas.
Qué entregar
- Diagrama del flujo de ingesta, recuperación y generación.
- Conjunto de documentos fragmentados con identificador, fuente y metadatos.
- Implementación reproducible de carga y consulta en la alternativa elegida.
- Tabla de evaluación con cuatro preguntas, resultados recuperados, latencia y relevancia.
- Informe breve de discrepancias, límites y decisiones de mantenimiento.
Cómo comprobarlo
- Cada respuesta se puede rastrear hasta uno o más fragmentos concretos.
- La dimensión y el modelo de embedding son consistentes entre carga y consulta.
- Los filtros no eliminan indebidamente documentos pertinentes.
- La evaluación incluye registros de entrada, fórmula y cálculo reproducible.
- El informe distingue hechos observados, supuestos y trabajo futuro.
Temario completo
25 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos de RAG y Bases de Datos Vectoriales
- Arquitectura de Sistemas RAG: Componentes y Flujo de Datos
- Embeddings y Similitud Vectorial: Teoría Aplicada
- Configuración Inicial: Entorno de Desarrollo y Primeros Pasos
- Práctica: Creación de un Pipeline Básico de Embeddings
- Quiz: Evaluación de Conceptos Fundamentales
Implementación con Chroma: Bases de Datos Vectoriales Locales
- Instalación y Configuración de Chroma: Primeros Pasos
- Operaciones CRUD con Chroma: Inserción y Consulta de Vectores
- Optimización de Consultas: Filtros y Métricas de Similitud
- Práctica: Construcción de un Sistema RAG Simple con Chroma
- Quiz: Evaluación de Chroma y sus Funcionalidades
Escalando con Pinecone: Bases de Datos Vectoriales en la Nube
- Introducción a Pinecone: Cuentas, APIs y Configuración
- Gestión de Índices en Pinecone: Creación y Mantenimiento
- Consultas Avanzadas y Monitoreo en Pinecone
- Práctica: Migración de un Sistema RAG a Pinecone
- Quiz: Evaluación de Pinecone y Escalabilidad
Integración con pgvector: Bases de Datos Vectoriales en PostgreSQL
- Instalación y Configuración de pgvector en PostgreSQL
- Operaciones Vectoriales en pgvector: Extensiones y Consultas
- Optimización de Rendimiento: Índices y Buenas Prácticas
- Práctica: Implementación de un Sistema RAG Híbrido con pgvector
- Quiz: Evaluación de pgvector y Integración
Proyecto Integrador: Sistema RAG Completo con Evaluación y Despliegue
- Diseño del Proyecto: Arquitectura y Planificación
- Implementación del Pipeline: Integración de Múltiples Bases de Datos
- Evaluación de Rendimiento: Métricas y Pruebas
- Práctica: Despliegue y Monitoreo del Sistema RAG
- Quiz Final: Evaluación Integral del Proyecto
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector?
Puedes adquirir el curso Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector?
Es un curso completo en español con 5 módulos y 25 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector?
Revisa el temario público para comprobar el punto de partida y la progresión de Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Qué formato tiene el curso?
El formato actual es lectura y práctica. Consulta las lecciones y sus recursos; no se ofrece como un curso completo de video.
¿Puedo revisar el programa antes de pagar?
Sí. El temario y esta ficha son públicos. Compara el contenido y los requisitos con tu objetivo antes de elegir una compra individual o un acceso a toda la escuela en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Otros cursos de IA
Ver todo el catálogo →- SQL para Principiantes: Domina las Bases de Datos desde CeroAprende SQL paso a paso y domina la manipulación de bases de datos relacionales. Descubre cómo consultar, filtrar y gestionar información como un profesional.
- Análisis de Datos con Google Sheets y SQLDomina las herramientas esenciales para analizar datos. Aprende a manipular hojas de cálculo en Google Sheets y a realizar consultas SQL para extraer información valiosa de bases de datos.
- Apache Airflow: Construcción de Pipelines ETL Automatizados con DAGsCurso práctico para data engineers que desean dominar Apache Airflow en la orquestación de pipelines ETL complejos. Aprenderás a diseñar, programar y monitorear DAGs robustos, integrando herramientas como Python, bases de datos y APIs. Al finalizar, serás capaz de automatizar flujos de datos escalables en entornos productivos.
- Excel para Análisis de Datos - Nivel PrincipianteDomina las herramientas esenciales de Excel para transformar datos en información valiosa. Aprende desde cero a organizar, calcular y visualizar datos de manera efectiva.