Machine learning usa datos para ajustar un modelo que realiza una tarea. No es lo mismo que escribir reglas, consultar un asistente o garantizar que una predicción será correcta. El primer trabajo es definir qué querés estimar y con qué información contás en el momento de decidir.
Fundamentos con una pregunta concreta
Imaginá una práctica ficticia para estimar el tiempo de entrega de un paquete. La variable objetivo es el tiempo; las entradas podrían ser distancia y día de la semana, si realmente están disponibles antes de la entrega. No incluyas una columna que sólo se conoce al terminar: sería una fuga de información.
Regresión estima una cantidad. Clasificación asigna una categoría. Agrupamiento explora similitudes sin una etiqueta objetivo. Un resultado distinto no implica mejor desempeño: elegí el enfoque por la pregunta y por cómo vas a comprobar el error.
Línea de base antes de un modelo complejo
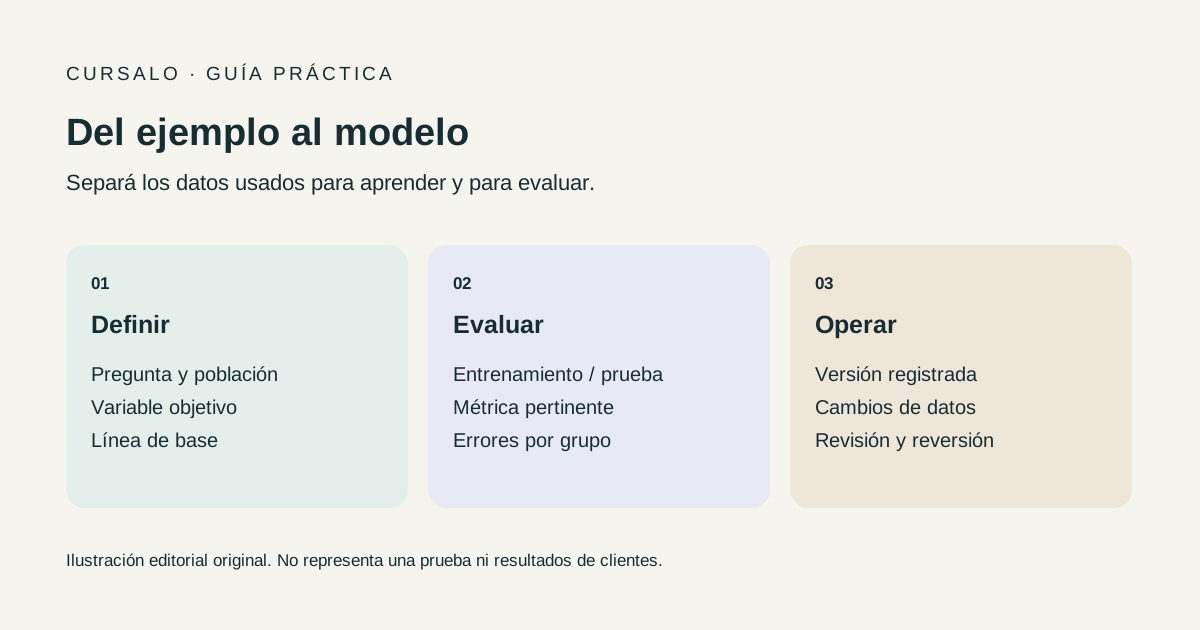
Para la entrega, una línea de base podría usar la mediana del tiempo en el conjunto de entrenamiento. Compará el modelo contra esa regla en datos que no usó para aprender. Si no la supera de una manera útil, agregar complejidad no está justificado.
La guía de scikit-learn documenta modelos, preprocesamiento y evaluación. Elegí un conjunto público adecuado o una muestra autorizada; registrá licencia, origen y significado de las variables.
Entrenamiento y prueba separados
Reservá ejemplos para evaluar y ajustá preprocesamiento sólo con entrenamiento. Para datos temporales, considerá el orden del tiempo: una división aleatoria puede permitir aprender de un futuro que no existía al predecir. La elección depende del caso; no hay un porcentaje de división que sirva para todo.
| Paso | Qué registrar | Error que ayuda a evitar |
|---|---|---|
| Definir | Objetivo, población y momento de uso. | Resolver otra pregunta. |
| Preparar | Faltantes, duplicados y variables. | Fuga de información. |
| Separar | Entrenamiento y evaluación. | Medir sobre ejemplos vistos. |
| Comparar | Línea de base y métrica. | Confundir complejidad con mejora. |
| Revisar | Errores por caso y grupo. | Ocultar fallas tras un promedio. |
Para cantidades, revisá la magnitud del error y qué casos lo concentran. Para categorías, contá falsos positivos y negativos según el efecto de equivocarte. La exactitud puede esconder un problema cuando una clase es poco frecuente.
Una práctica para explicar lo aprendido
Elegí un conjunto de muestra, escribí la pregunta y calculá una línea de base. Guardá una tabla con entrada, valor real, predicción y error. Revisá cinco errores grandes y explicá qué información falta o qué supuesto falló. No cambies los datos de evaluación para mejorar el número final.
Si usás una IA para escribir código, pedí que explique preprocesamiento y separación. Comprobá el script, la documentación y el resultado; no tomes la respuesta como prueba de que no hay fuga. Podés practicar esa explicación con ChatGPT para Principiantes, explorar prompts y consultar libros y el catálogo. Estas rutas son apoyo formativo, no una certificación de machine learning ni una promesa de un curso inexistente.
De la evaluación a producción
Antes de usar el modelo, definí quién lo opera, dónde se guardan versiones, qué datos recibe y cuándo se detiene. Vigilá cambios en la entrada y en los errores. Conservá una forma de volver a la versión anterior o a un proceso manual. Un buen resultado en una muestra no garantiza el mismo desempeño después del despliegue.
Para decisiones sobre personas, revisá necesidad, efectos, permisos y mecanismos de corrección con los responsables del proceso. El modelo no elimina la responsabilidad de quien decide. Continuá con análisis de datos y consultá precios cuando encuentres un programa que responda a tu necesidad.